30 秒看懂
Berman 解读 o3-mini 的首次发布,包括推理强度设置、公司报告的基准分数、延迟和发布时价格。他测试了两个贪吃蛇程序,报告说两者都能运行,但碰到边界时的行为不同;这些只是简短示例,产品细节也属于历史信息。
- 1推理强度发布资料介绍了低、中、高设置以及发布当天的 API 功能。
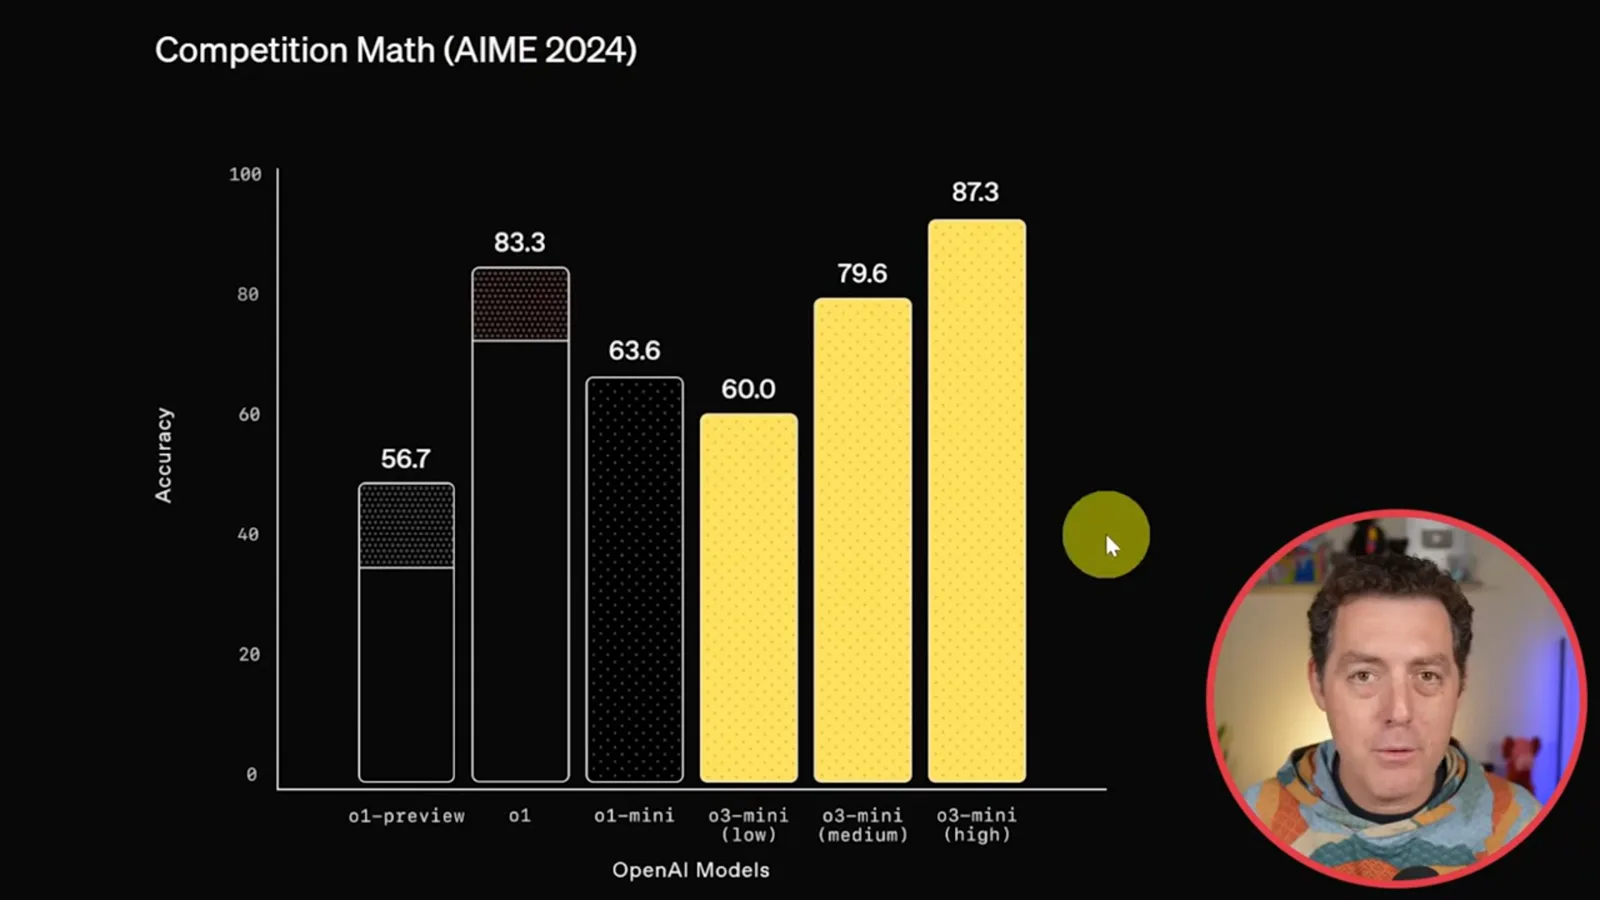
- 2报告的数学结果OpenAI 的 AIME 图表比较了不同推理设置在选定任务上的表现。
- 3测得的延迟公司报告,在与 o1-mini 的特定比较中,平均响应速度提高了 24%。
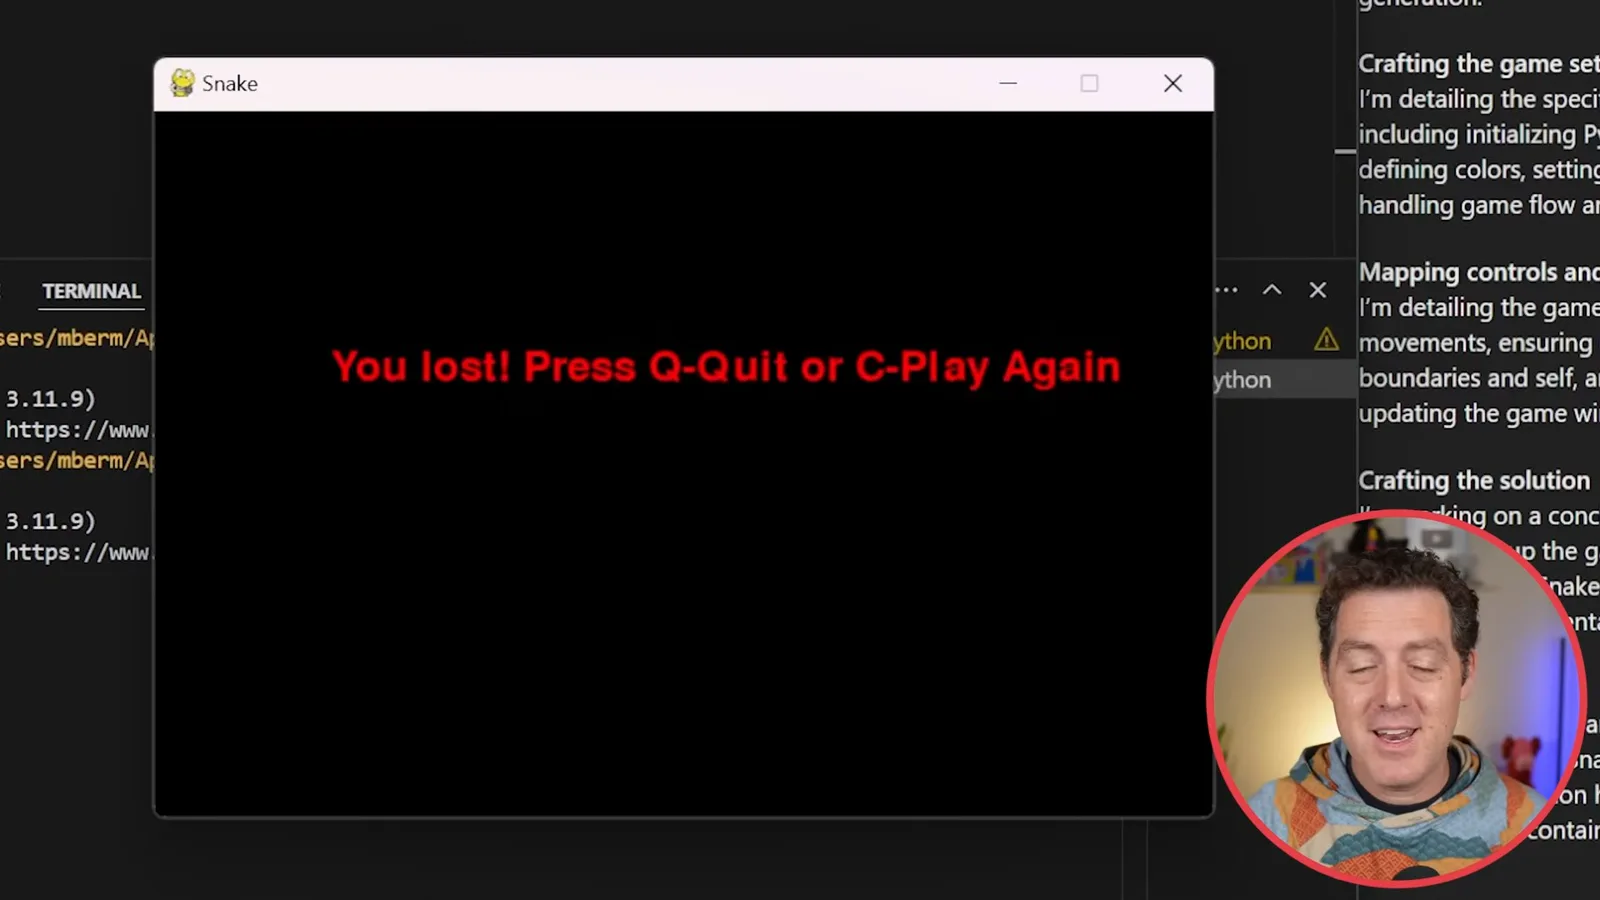
- 4两个贪吃蛇程序Berman 运行了两个简短的生成游戏,它们碰到墙壁时行为不同。
要点建议
- 首次发布提供低、中、高三档推理强度设置。
- OpenAI 的基准图表显示,不同设置和任务的结果各不相同。
- 公司报告的延迟比较适用于其特定 A/B 测试。
- 主持人的两个贪吃蛇示例均能运行,但边界行为不同;它们不是全面的编码评估。
- 视频中描述的价格、访问条件和视觉限制反映的是 2025 年发布时的情况。
按章节阅读整理后的全文
发布与推理设置
Berman 介绍模型、推理强度设置和当时的发布安排。
OpenAI 发布了 o3-mini。在这段 2025 年 1 月的视频中,我解读公告并尝试一个小型编码示例。我猜测 DeepSeek 带来的竞争可能促使其提前发布,但视频没有证实 OpenAI 选择这一日期的原因。
发布资料介绍了低、中、高三档推理强度设置。当时,OpenAI 宣布通过 ChatGPT 和选定的 API 等级提供访问,并支持函数调用、结构化输出和开发者消息。这篇历史回顾中的可用性和限制可能已经变化。
我解释说,答案明确的题目可以让部分科学、技术、工程和数学问题更容易用于强化学习的评估。这是我讨论中的一种直观解释,并不意味着开放式任务无法使用强化学习或其他反馈。
选择推理强度让开发者可以在更多思考时间与延迟、成本之间权衡。我讨论发布当天 ChatGPT 和 API 的推出安排,包括消息上限的变化,但这些数字属于历史信息,并非当前产品指南。
公告介绍了 ChatGPT 中的搜索功能,并称 o3-mini 发布时不支持视觉,当时建议使用 o1 进行视觉推理。这个说法描述的是 2025 年 1 月的发布情况,而不是后来模型或界面的能力。
报告的基准与速度
他解读 OpenAI 对数学、科学、编码和延迟的比较。
OpenAI 的 AIME 2024 图表显示,低、中、高推理强度的结果不同。在展示的比较中,中等强度接近 o1,高强度的分数更高。这些是公司在特定测试条件下报告的基准结果。
我查看 OpenAI 的科学和 FrontierMath 图表。在所展示的 GPQA 比较中,o1 系列领先;而在所示设置下,o3-mini 高强度报告的 FrontierMath 结果更强。不同的 pass-at-k 数值对应不同的尝试次数,应在相同条件下比较。
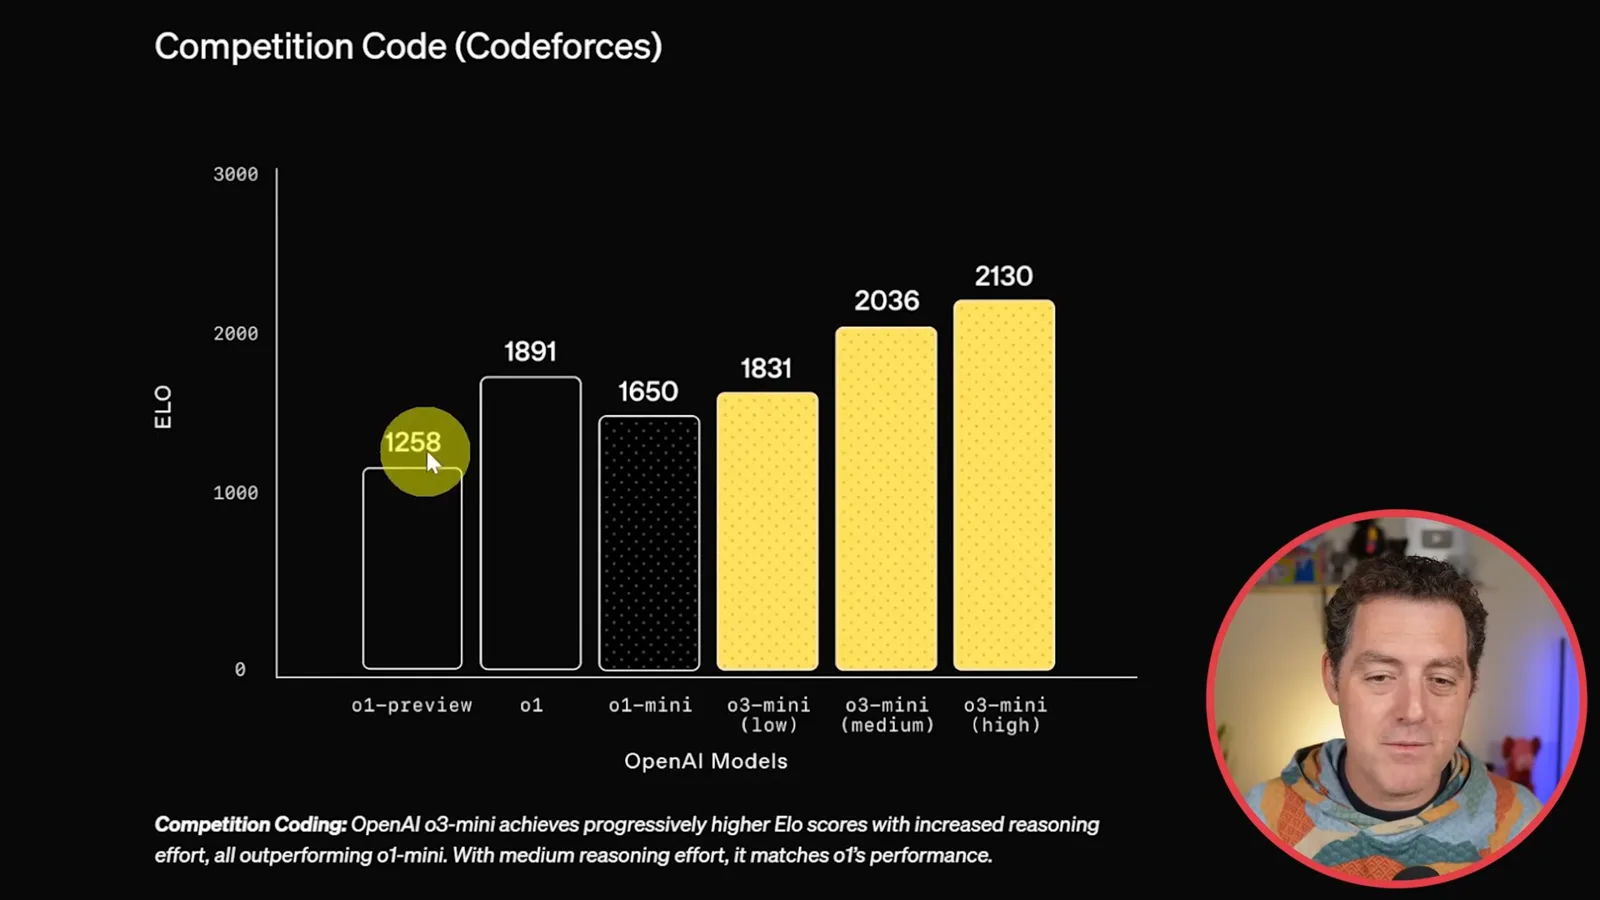
Codeforces 图表显示,随着推理强度提高,估算的编码评分也提高,其中 o3-mini 高强度高于展示的其他模型。SWE-bench Verified 图表也显示了较强的高强度结果。任何一个基准都不能单独证明模型在所有编码项目中的表现。
我讨论的偏好评估区分了 STEM 和非 STEM 问题。我将技术任务的表现部分归因于答案更容易验证,但这是我的解释,这些结果并未独立证明具体的训练机制。
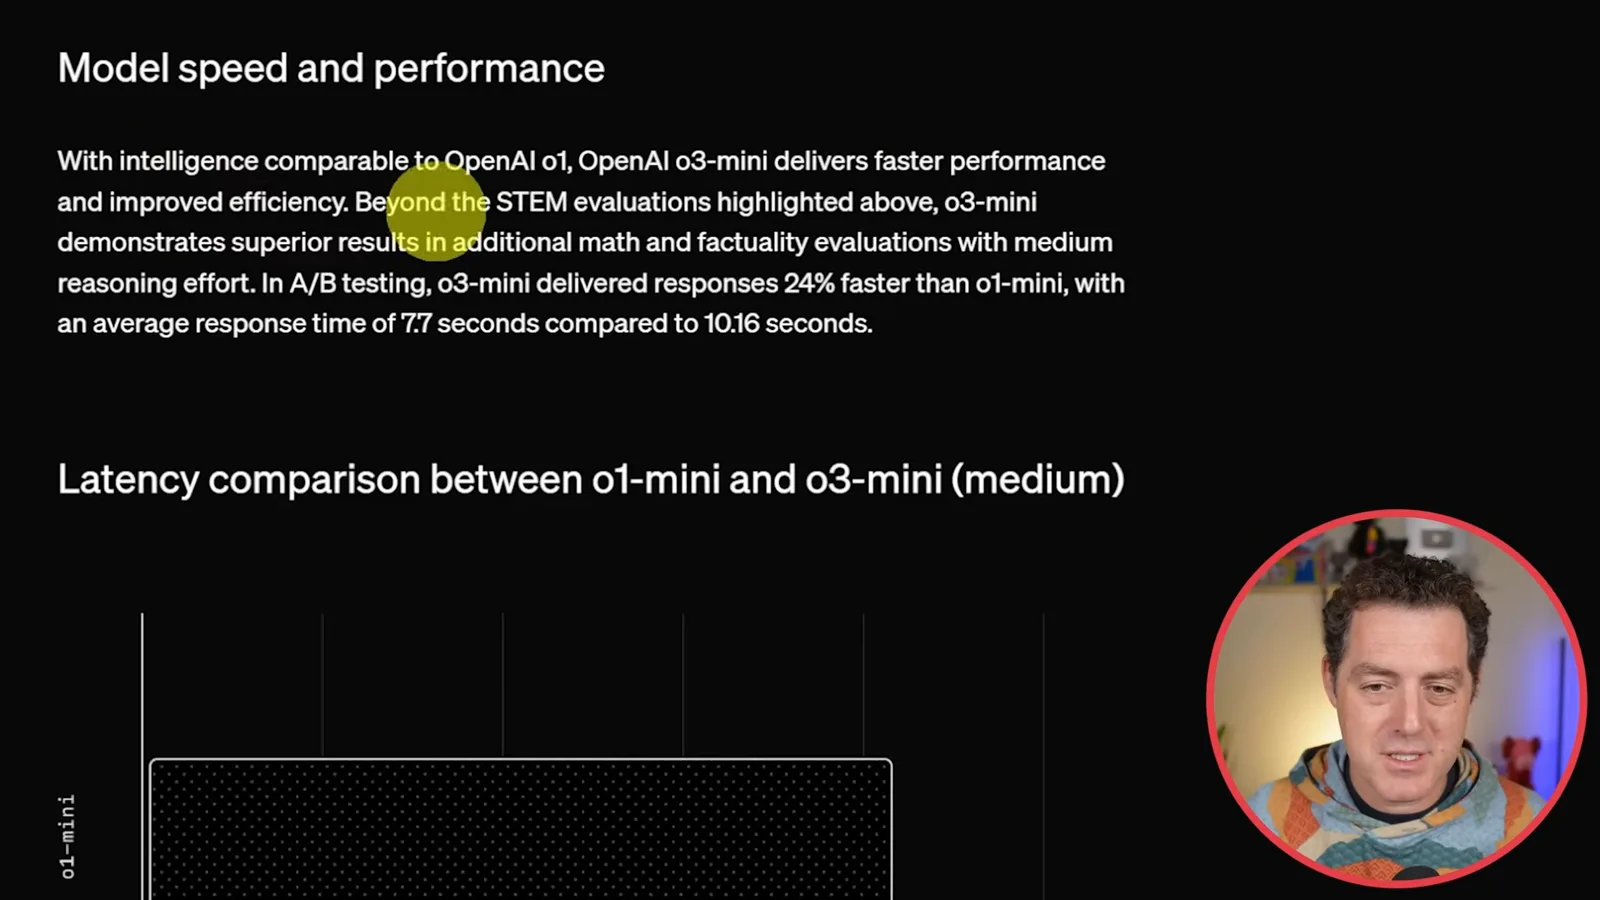
OpenAI 报告,在其 A/B 测试中,中等推理强度的 o3-mini 比 o1-mini 的响应速度快 24%,平均响应时间分别为 7.7 秒和 10.16 秒。这些测量取决于测试工作负载,并非普遍的延迟保证。
价格与编码测试
他比较历史价格,并运行两个生成的贪吃蛇游戏。
我比较了发布时展示的 o3-mini 和 DeepSeek Reasoner API 价格,包括单独的缓存输入价格。这些是历史价格;当前费用、缓存条款和产品可用性应向服务商核实。
为了快速上手,我让 o3-mini 用 Python 编写贪吃蛇游戏。在画面展示的首次运行中,代码约六秒后生成。我运行游戏,检查蛇能否吃到食物,并观察到它会从屏幕另一侧出现,但撞到自己时游戏结束。
我用高推理强度重复相同提示。画面显示这次运行约需九秒,生成的程序也更长;这个版本在蛇撞墙时结束游戏,并提供重新开始或退出选项。两者都是简短示例,并非全面的编码基准。
我提到 Windsurf 和 Cursor 宣布在各自的编码工具中提供该模型。我计划进行更全面的评估,并以对这些产品在 2025 年初快速变化的乐观看法收尾。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文