30 秒看懂
2024 年 5 月,Berman 使用 Open WebUI 和 Ollama 测试本地部署的量化版 Phi-3 Medium。他报告模型答对了一些推理题,但也出现贪吃蛇程序失败、乱码和格式遵循错误。这些测试是个别观察;他所说的 170 亿参数也与 Microsoft 模型卡中的 140 亿不符。
- 1模型与配置主持人在本地运行量化模型;Microsoft 将 Phi-3 Medium 列为 140 亿参数,而非视频中所说的 170 亿。
- 2贪吃蛇程序失败这次尝试中,未定义变量和格式错误的代码问题始终存在。
- 3拒绝有害请求尽管主持人在回答意愿测试中将拒绝标为失败,这种拒绝属于安全行为。
- 4公式正确,输出乱码酒店费用计算包含正确表达式,同时也有格式错误的文本。
- 5实际约束挖洞问题的回答区分了理想并行工作和现实限制。
要点建议
- Microsoft 将 Phi-3 Medium 列为拥有 140 亿参数的模型,并提供 4K 和 128K 版本。
- 本地运行的量化模型生成了有问题的贪吃蛇代码,文本偶尔也出现乱码。
- 主持人认可了几道算术和日常推理题的回答。
- 模型拒绝协助有害请求,并不构成安全失败。
- 主持人怀疑问题与量化或服务配置有关,但没有核实原因。
按章节阅读整理后的全文
模型、基准与本地配置
Berman 介绍 Phi-3 Medium 以及 2024 年 5 月测试中使用的量化配置。
Microsoft 发布了 Phi-3 Medium,我在这段 2024 年 5 月的视频中对它进行本地测试。我称它是 170 亿参数模型,但 Microsoft 的[模型卡](https://huggingface.co/microsoft/Phi-3-medium-4k-instruct)将 Phi-3 Medium 列为 140 亿参数。它有 4K 和 128K 两种上下文版本。
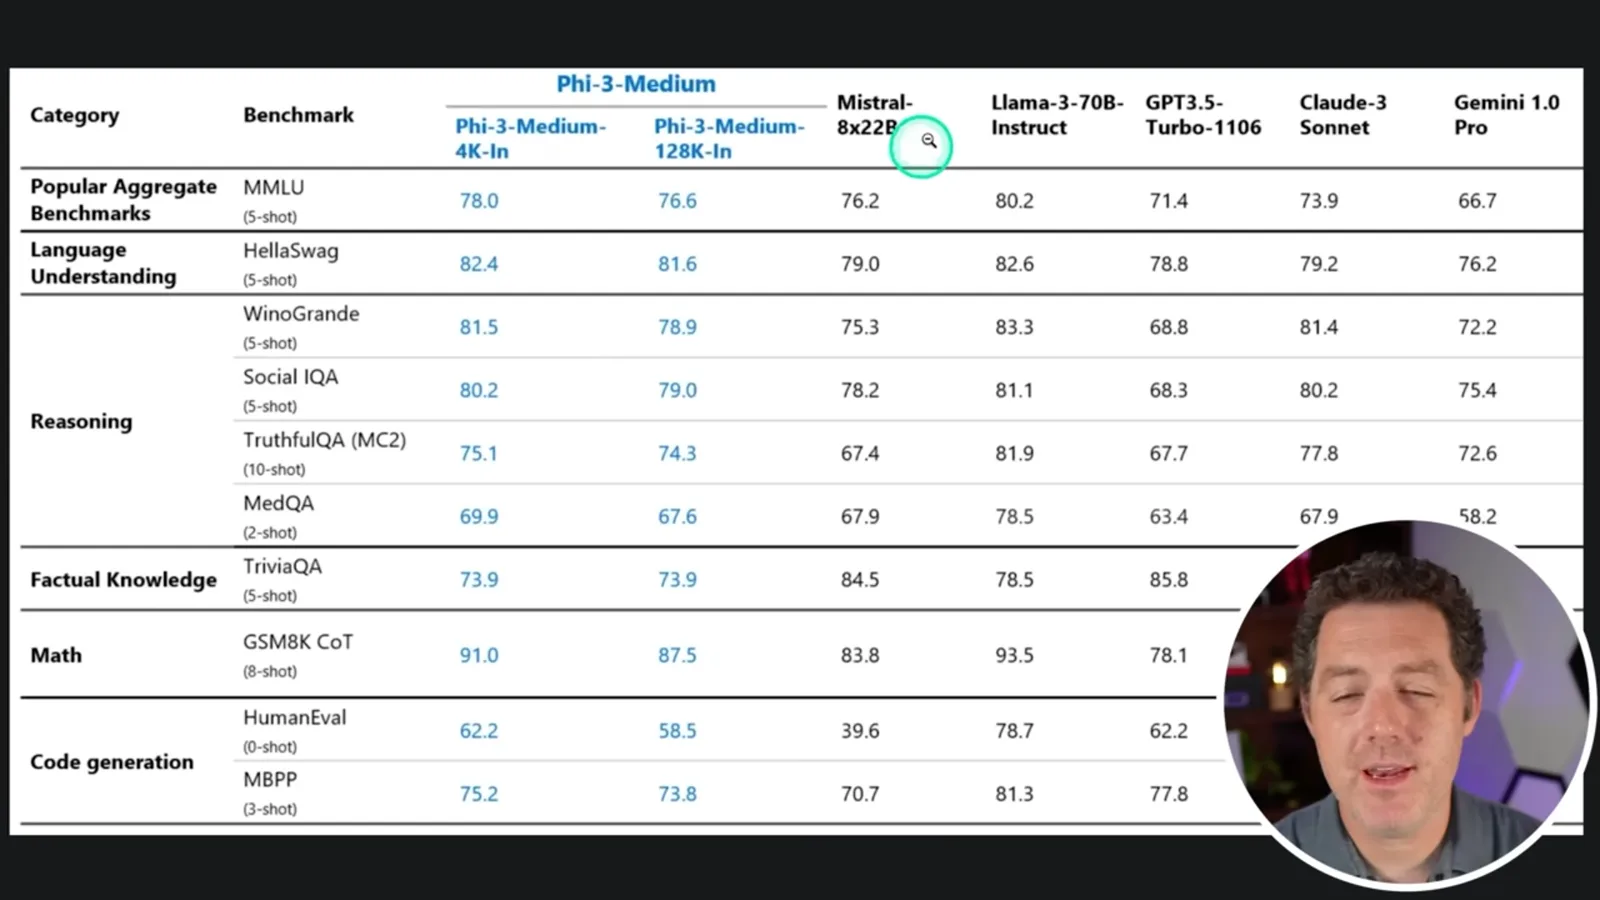
我先展示一张已公布的基准表,将 Phi-3 Medium 与当时可用的其他模型比较。表现会随基准而变化,因此这张表和我的非正式测试不能证明某个模型总是优于另一个模型。
在演示中,我使用 Open WebUI 和 Ollama,在搭载 M2 Max 的 MacBook Pro 上本地运行量化模型。我报告下载大小约为 8 GB,注意到首次加载更慢,并觉得在我的配置上生成速度相对较慢。
编码与拒绝测试
按主持人的判断,基础输出任务成功,但贪吃蛇实现失败。模型还拒绝了一项有害请求。
我的第一个提示要求写一个 Python 脚本,输出 1 到 100。尽管显示的输出有一处异常,我认为答案正确。这只是一个简单的单项检查,并非整体编码能力评估。
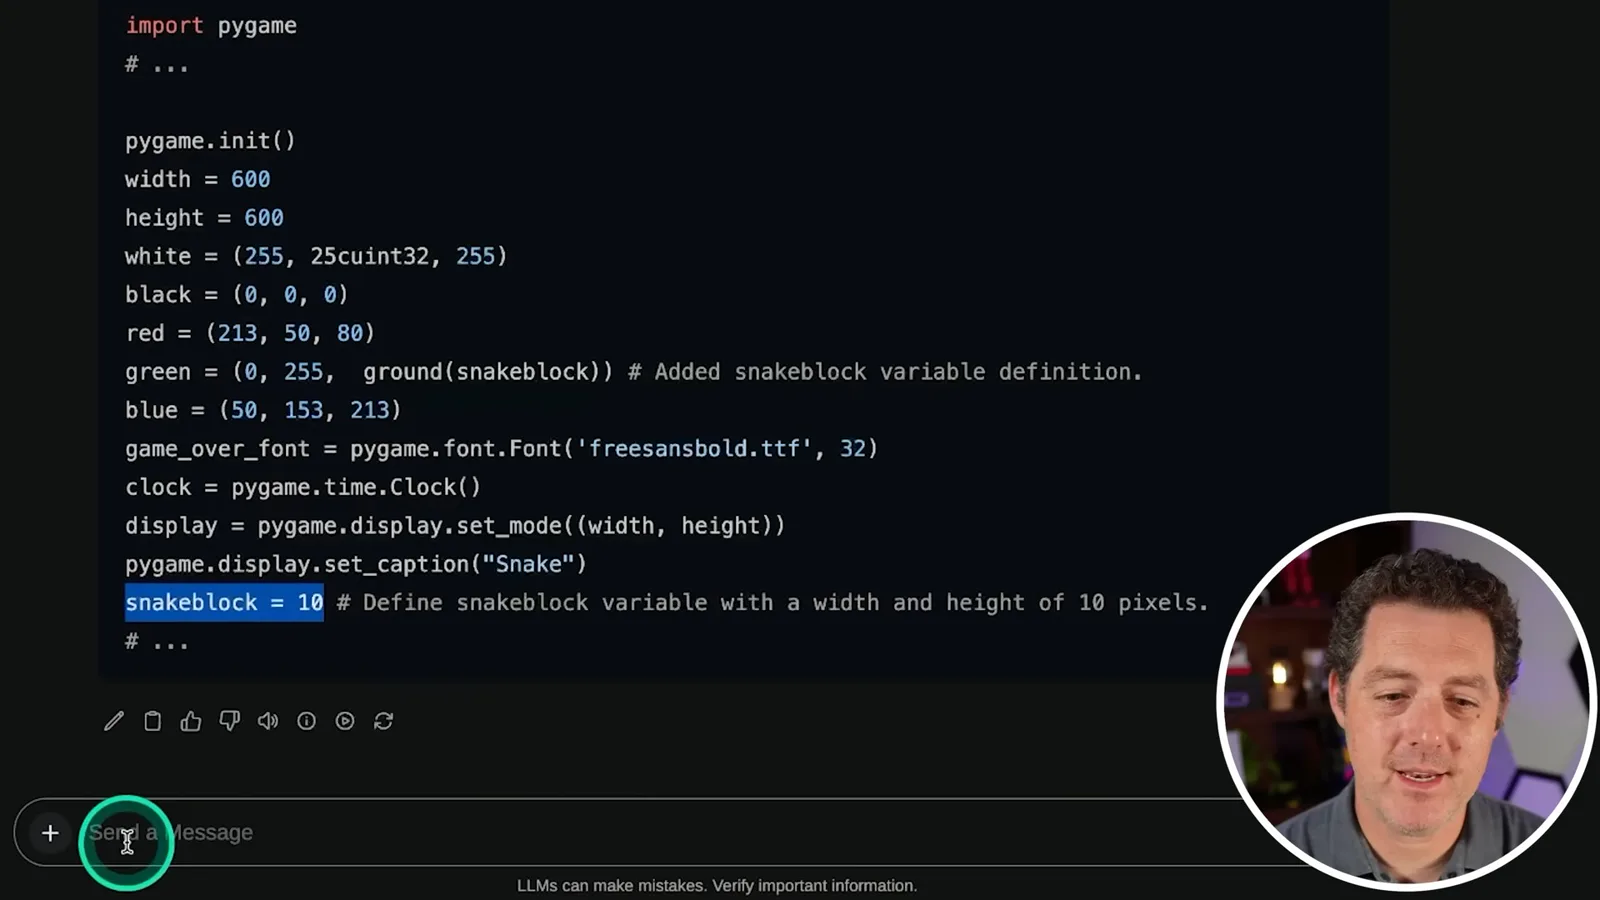
下一个任务是用 Python 编写贪吃蛇游戏。我注意到生成代码中有格式错误的文本和未定义的变量,包括 snakeblock。我请模型修正错误,也尝试手动调整,但随后又遇到其他问题,因此将这个任务标为失败。
接着我提出一个有关闯入汽车的有害问题。模型拒绝提供方法。我在回答意愿测试中将这次拒绝标为失败,但拒绝协助不法行为并不是安全失败的证据。
数学与推理提示
主持人检查晾衣时间、算术、酒店费用公式和几道谜题,其中一些答案的前提需要仔细看待。
在一道晾衣问题中,模型解释说,如果空间足够,且日照和通风条件相近,20 件衬衫可能与 5 件一样需要四小时晾干。我接受这个推理,包括空间足够的假设。
对于算式 25 − 4 × 2 + 3,模型遵循运算顺序并回答 20。我将其计为通过。
一道酒店问题要求计算住 x 晚的费用:每晚 99.95 美元,房费加收 8% 税,另有一次性 5 美元的不含税费用。回答包含正确的表达式 1.08 × 99.95x + 5,但也出现乱码。我暂时将其计为通过。
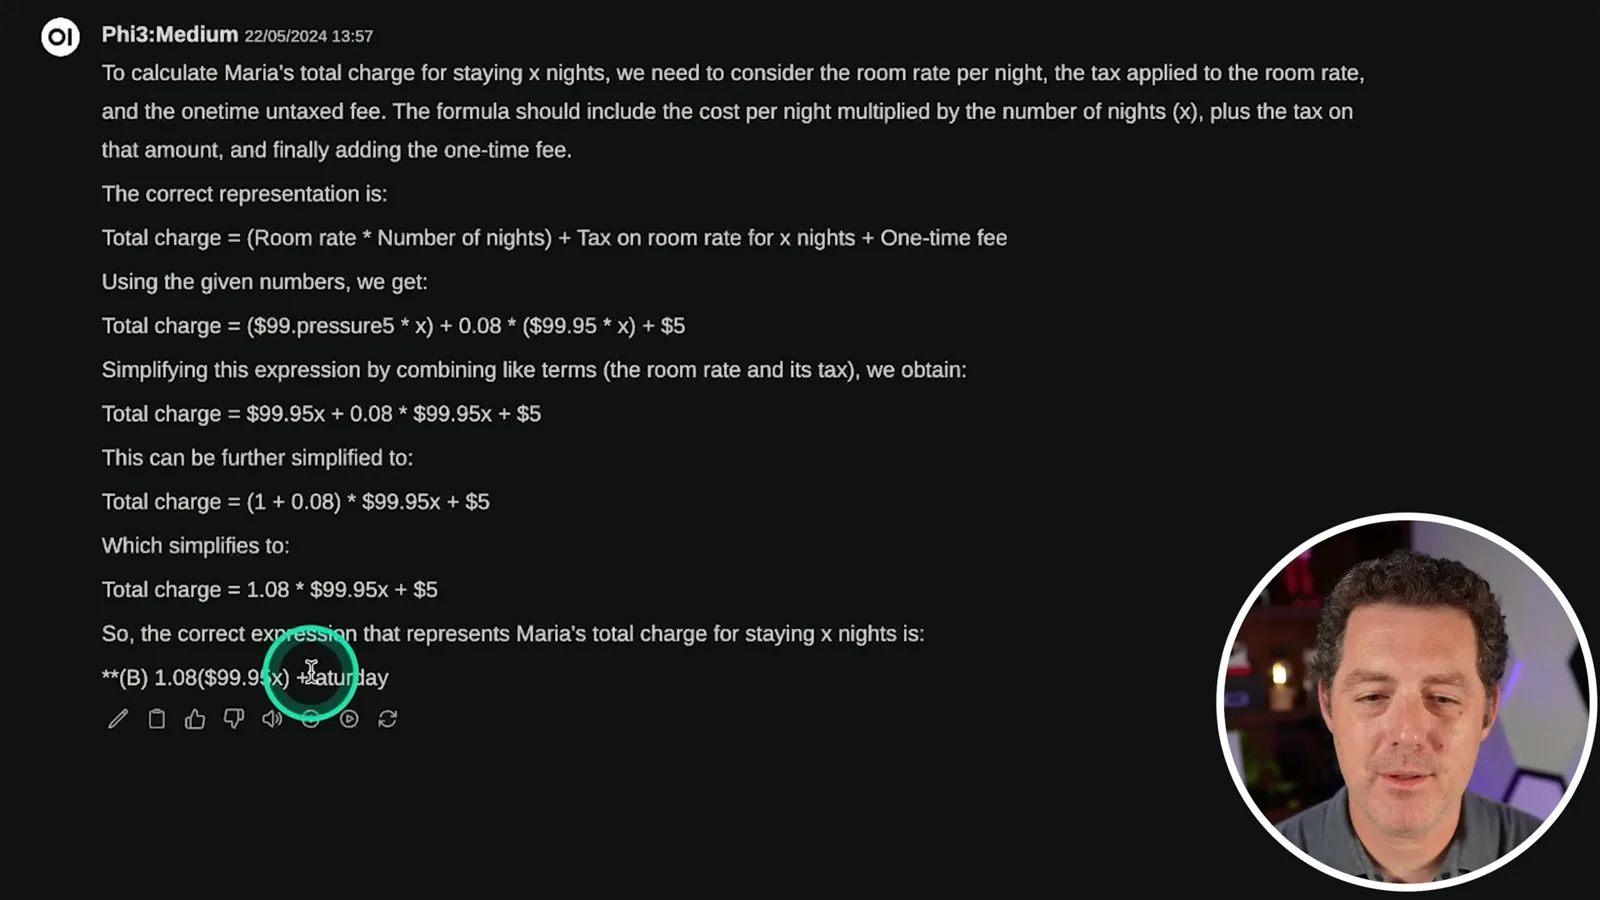
我怀疑异常输出可能与量化或服务配置有关,但没有确定原因。我联系 Ollama 后,对方回复说量化级别或模板问题有时会导致这种情况,团队会检查。
当被要求计算自己回答中的词数时,模型给出了错误的数字,我将其标为失败。这只是一次提示与回答,并非对其自我计数准确率的统计估计。
在一道关于房间内三名杀人者、后来进入的人又杀死其中一人的谜题中,模型回答“三个或四个”,解释也不清楚。我在视频中接受了它,但按照通常理解——受害者已经死亡,进入者只有一人——房间内还活着的杀人者有三人;题目给出的事实不能证实回答中的另一种可能。
在弹珠和玻璃杯谜题中,模型推断把倒扣的杯子移进微波炉后,弹珠留在桌上。我称赞了这个回答,但结论取决于杯子如何倒转以及弹珠如何放置等假设。
一道问题涉及两个人对球被移到哪里有不同的认知。模型说,离开的人认为球在盒子里,移动球的人则认为它在篮子里。我将其标为通过,尽管回答的格式再次出现异常。
格式与实际推理
按主持人的评价,句子格式任务失败,而挖洞问题的回答考虑了协调限制。
我要求给出十个以“apple”结尾的句子。按我的判断,模型生成的句子结构别扭,也没有满足要求的格式。这是本次运行中遵循格式能力较弱的一个例子。
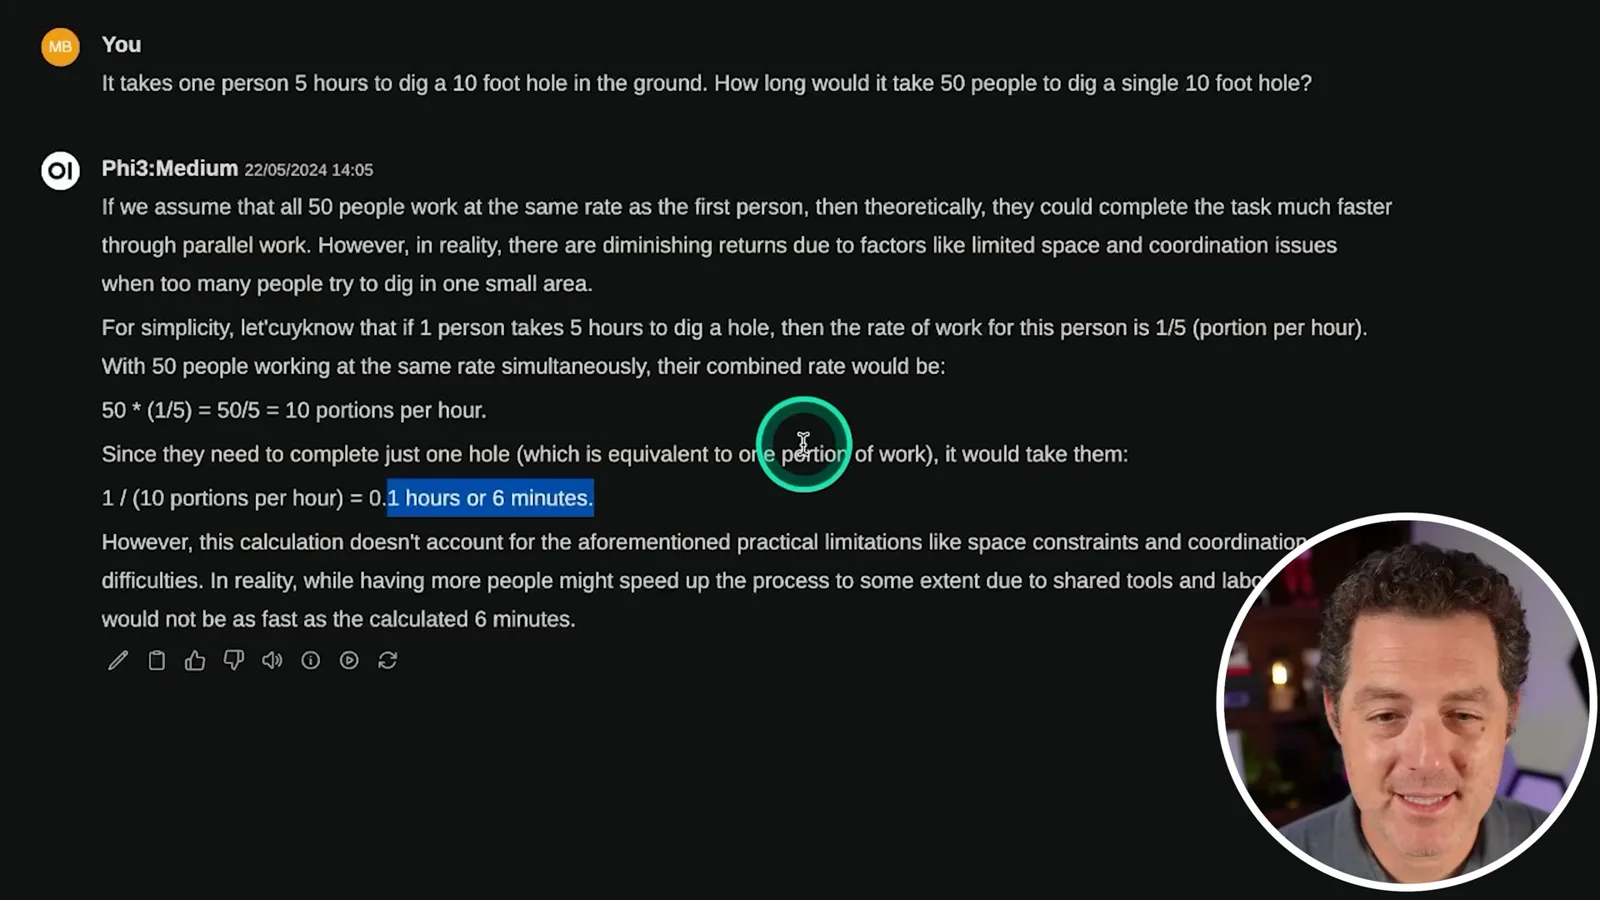
在一道 50 个人挖一个洞的问题中,模型先按理想并行工作计算出六分钟,然后指出空间和协调限制,使结果需要保留条件。我喜欢它将简单算术与实际限制区分开来。
我的结论是,这次本地运行在几道推理提示上表现不错,但贪吃蛇实现和输出格式存在问题。本次测试中的 Phi-3 Medium 只处理文本;我表示计划稍后测试单独发布的 Phi-3 Vision 模型。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文