30 秒看懂
Will Brown 认为,组织中存在大量隐性知识,agent 不得不反复重新发现。他提出结合上下文、检索、评估、人工反馈和针对性的模型训练,让组织工作流程随时间改进,并介绍 Prime Intellect 的案例和原型。
- 1隐性知识Brown 说,重要的组织上下文分散在文档、关系和工作习惯中。
- 2放进上下文还是权重他区分了明确规则、检索信息,以及可能值得训练的重复模式。
- 3漫长的反馈链他描述领域知识在进入模型训练前,如何经过多个中间环节。
- 4把评估当作测试执行轨迹和反馈可以成为组织模型与工作流程的测试用例。
- 5辅助决策的界面针对任务的组件可以请求人工判断,并为后续学习产生明确反馈。
- 6持续学习原型Brown 介绍了在启动夜间训练前,审核标记问题和实验建议的做法。
要点建议
- 组织知识既存在于明确的文档中,也存在于隐性的工作模式中。
- 技能、检索和模型权重是存储不同知识的互补位置。
- 生产环境中的执行轨迹和反馈,可以先整理成评估,再考虑用于训练。
- 路由与决策模型为从反馈中学习提供了具体且可标注的切入点。
- 便于人使用的决策界面既能改善交互,也能为评估或训练提供明确反馈。
按章节阅读整理后的全文
AI 原生组织
Brown 介绍将企业工作流程与能够持续改进的模型结合起来的机会。
我在 Prime Intellect 负责应用研究。在这场会议上,人们会交流哪些方法有效、哪些无效,以及接下来会发生什么。我想从组织层面讨论这个问题:一家成熟企业真正成为 AI 原生组织意味着什么?
我们已经从聊天机器人、推理系统,发展到能够承担更多工作流程的 agent 和工具。接下来的问题是,如何在整个组织中整合 agent,而不只是让一家快速开发的小型初创公司使用它们。
Prime Intellect 构建训练、部署和改进模型的基础设施,尤其关注开放模型和工具。我们的设想是,组织除了使用现有前沿模型,还可以围绕自己的工作流程、数据和 harness 培育模型。
知识、上下文与权重
他描述隐性的机构知识,并追问哪些信息应放在提示、检索或模型训练中。
组织拥有的知识多于正式文档所记录的内容。一部分存在于代码、邮件和书面流程中;另一部分则隐含在会议记录、人际关系、局部偏好,以及谁真正作决定的非正式认识中。
每位员工可能只能看到低效流程的一部分。能够跨团队查看非结构化材料的 agent,或许可以帮助发现反复出现的摩擦,或者指出某个团队仍在面对的问题已被另一个团队解决。
我希望这不是一次性分析,而是持续的循环:agent 获得所需上下文,agent 和组织本身都得到改进。人类同事会在工作中学习,而当前 agent 主要依靠相对有限的上下文学习方式。
Agent 可以读取技能文件或查看代码库,但可能反复重新发现组织知识。每次运行也可能需要重新处理大量上下文。一些重复出现的模式,尤其是难以写成严格规则的偏好,可能适合成为模型训练的候选内容。
我把它看成从规则到模式、从代码到数据的一条光谱。技能或明确规则靠近一端;偏好、摩擦、启发式经验和趋势则常常分散在员工通过经验学习的数据中。
这带来一个实际问题:什么应该放进上下文,什么值得让模型通过权重学习?不是所有东西都应立即用于训练。但训练已经是新一代模型能力提升的重要原因,组织可以对重复且有价值的工作流程考虑这种方法。
缩短反馈链
Brown 对比了多阶段的训练数据流程与来自实际工作人员的更直接反馈。
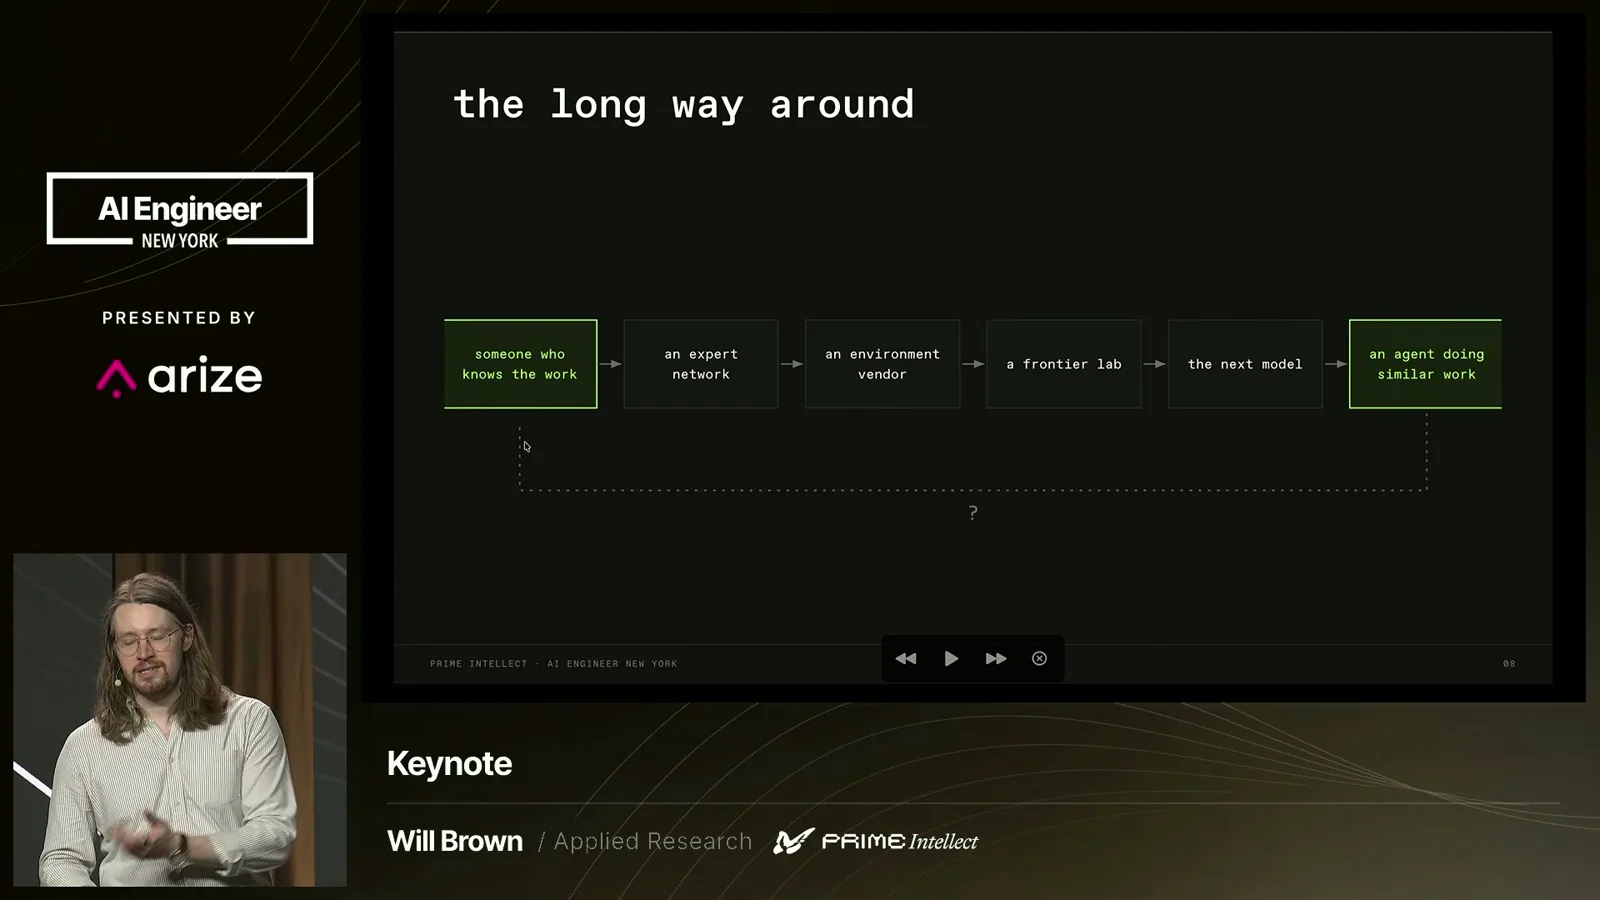
想想前沿模型如今可能如何学会一个专业企业流程:专家把知识分享给专家网络,环境供应商将其做成训练环境,实验室研究员再把环境纳入后续训练。
这条漫长的链路可能像传话游戏:了解工作的人不一定监督模型如何学习。我认为,领域专家反馈与模型持久改进之间有机会建立更短的路径。
使用编程 agent 时,我们已经会纠正重复错误,并在上下文中表达偏好。一部分指导适合放进 agent 指令文件,但文件可能不断累积,需要维护。训练流程也可以从用户在特定情境下更喜欢什么的例子中学习。
知识可以放在几个互补的位置:harness 中的技能和记忆、使用工具检索的文档和数据库,以及模型自身的权重。它们的特性各不相同;例如,模型的知识截止时间可能迫使它反复重建近期上下文。
评估与路由
生产轨迹可以变成测试;比较结果和人工批准则可以为路由与决策模型提供信息。
对于希望用自己的工作训练模型的组织,评估是一个有用的起点。可以把评估看成测试用例:组织为模型建立生命周期,不断增加例子、检查行为并改进系统。
使用 agent 会产生包含提示、行动和反馈的执行轨迹。这些轨迹可以成为评估资产,尽管整理高质量评估一向需要投入。Agent 可能帮助准备例子,但仍要注意评估是否稳健、结果能否支持学习。
决策模型和路由是一个具体例子。大模型和小模型可以尝试同一任务,反馈则可以识别小模型表现已经足够好的情况。这些比较能够为未来的路由决策和成本取舍提供依据。
决策模型也可以从组织的批准行为和偏好中学习。相关决定不只涉及工具安全:每个组织对自己的工作都有不同规则。反馈必须在具体情境中有意义。
人工决策与持续学习
他讨论丰富的训练环境、决策界面、一个模型案例和夜间改进原型。
对于更有雄心的训练项目,高频生产流程中的轨迹可以帮助构建结合真实与合成材料的丰富环境。只要具备适当的编排、工具和人工参与,agent 可以协助把这些轨迹转化成长任务训练环境。
我也关注让人更容易给出决定的界面。人们不必在漫长的 agent 讨论串中寻找问题;agent 可以生成一个针对任务的小卡片或组件,在需要人判断时再回来询问。
我们不断在单一 agent 信息流与多个并行 agent 之间切换。根本需求是向 agent 提供想法,让它们工作,再在有用的时刻收到需要人作出的决定。清晰的界面能够让这种交互更易管理。
这些决定也可以为训练决策模型或编排模型提供明确反馈。这并不能彻底解决奖励黑客等问题,但它提供了一个具体的起点,用来收集与人的选择相对应的标签。
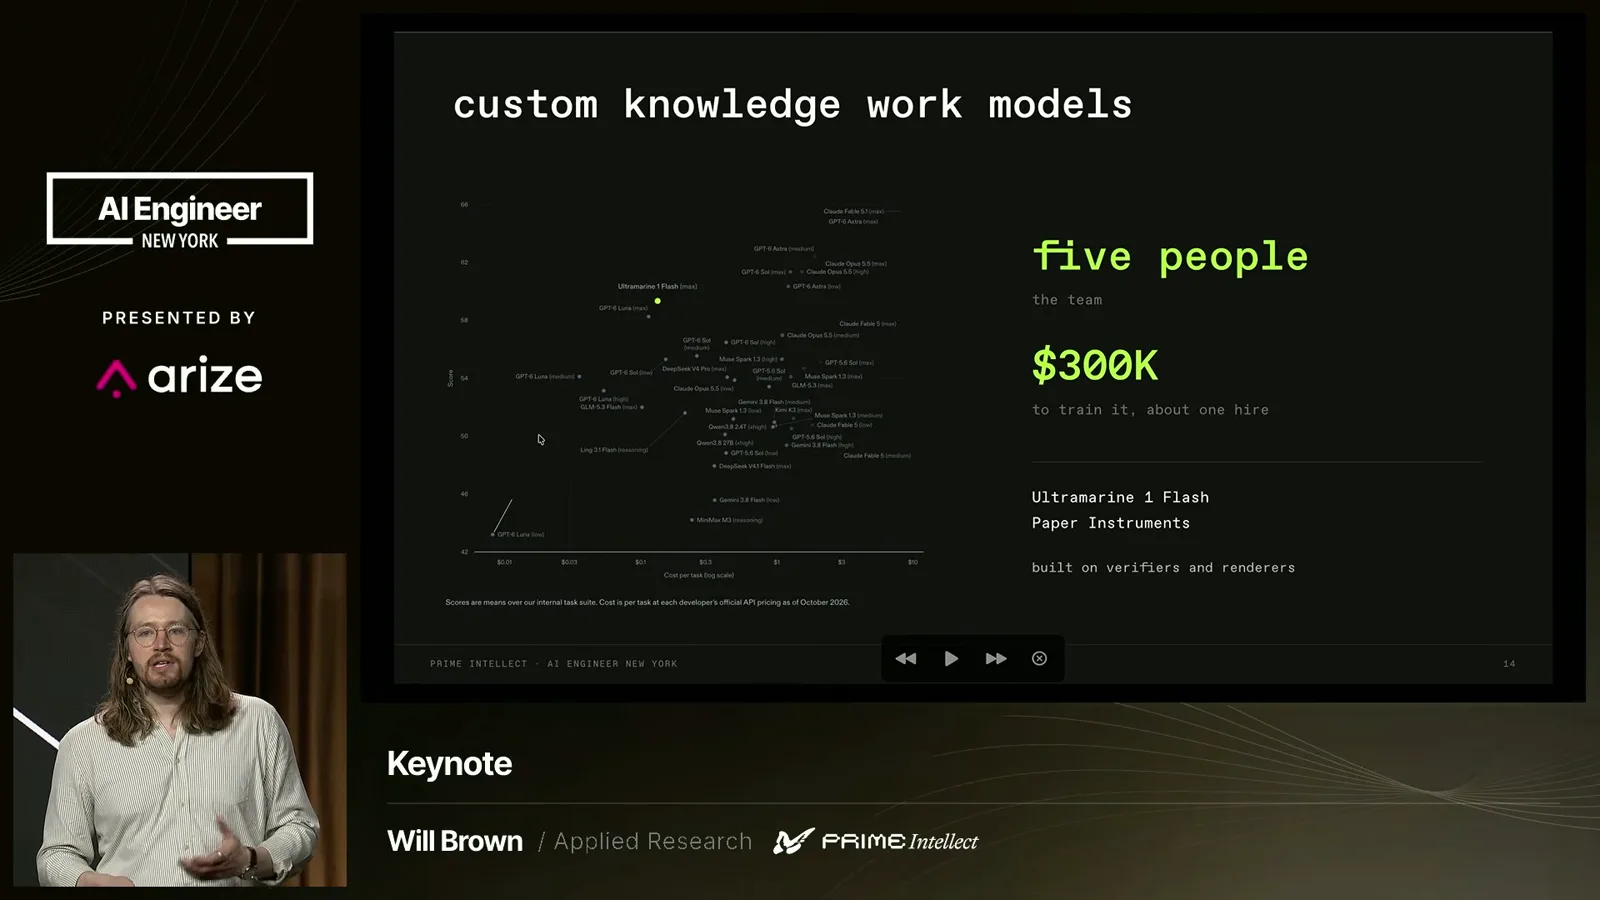
我提到 Paper Instruments 的案例:这家公司使用了我们的一些工具,并报告花约 30 万美元训练了一个知识工作模型。这个例子表明投入规模可能相当于雇用一人,但具体经济效果仍取决于组织和任务。
我们用于持续学习的原型从收集轨迹、标记问题和提出实验开始。团队可以审核实验并启动夜间训练,或许还能利用白天服务员工、夜间较为空闲的算力。
我设想的顺序是:理解工作流程、创建技能、建立评估和路由,然后在重复数据与价值足够时进行训练。目标是让组织知识随时间积累为更好的 agent 能力。这是我们正在努力的方向,并不意味着每个组织都已经做到。
同频道的其他文章
 16:51EN → 简体中文
 AI Engineer· 2026年11月3日Cristóbal Valenzuela 谈交互式视频模型与 Runway ContinuumCristóbal Valenzuela · RunwayRunway 联合创始人回顾从早期生成影片到交互式视觉界面研究原型的下一帧预测发展。
 15:51EN → 简体中文AI Engineer· 2026年11月2日Adam Nahari:让 AI 试点产生财务影响的六个行动Adam Nahari · Apollo航空公司机组排班案例展示了财务成果为何取决于流程重设计、用户采用和严格衡量。
 20:39EN → 简体中文AI Engineer· 2026年11月2日Sagar Batchu:在智能体操作到达 API 前进行授权Sagar Batchu · Speakeasy一种拟议的治理路径结合智能体身份、权限上限、策略决定和审计记录。
 18:33EN → 简体中文AI Engineer· 2026年11月2日Zack Proser:建一座工厂,帮助别人讲述自己的故事Zack Proser · WorkOSWorkOS 博客助手与睡前故事应用展示了 AI 工具如何分享经验,同时保留人的责任。
 18:57EN → 简体中文AI Engineer· 2026年11月2日Andrew Norrish:AI 时代的故障响应需要代码上下文Andrew Norrish · SourcegraphSourcegraph 工程师介绍审查压力,以及用于调查、预防和修复故障的边界清晰的工作流。
 15:44EN → 简体中文AI Engineer· 2026年11月1日Yijia Liang:为金融智能体构建兼容 Office 的文档引擎Yijia Liang · Compound AICompound 的方法结合共享智能体收件箱、文档引擎和可追溯到来源的大型资料室访问。