30 秒看懂
Matthew Berman 回顾 Abacus AI 公布的 Smaug 基准,并非正式地比较托管 70B 模型与较小的本地量化模型。本地模型在托管版本失败的贪吃蛇任务上成功,而两者在多道推理题中都暴露了弱点。
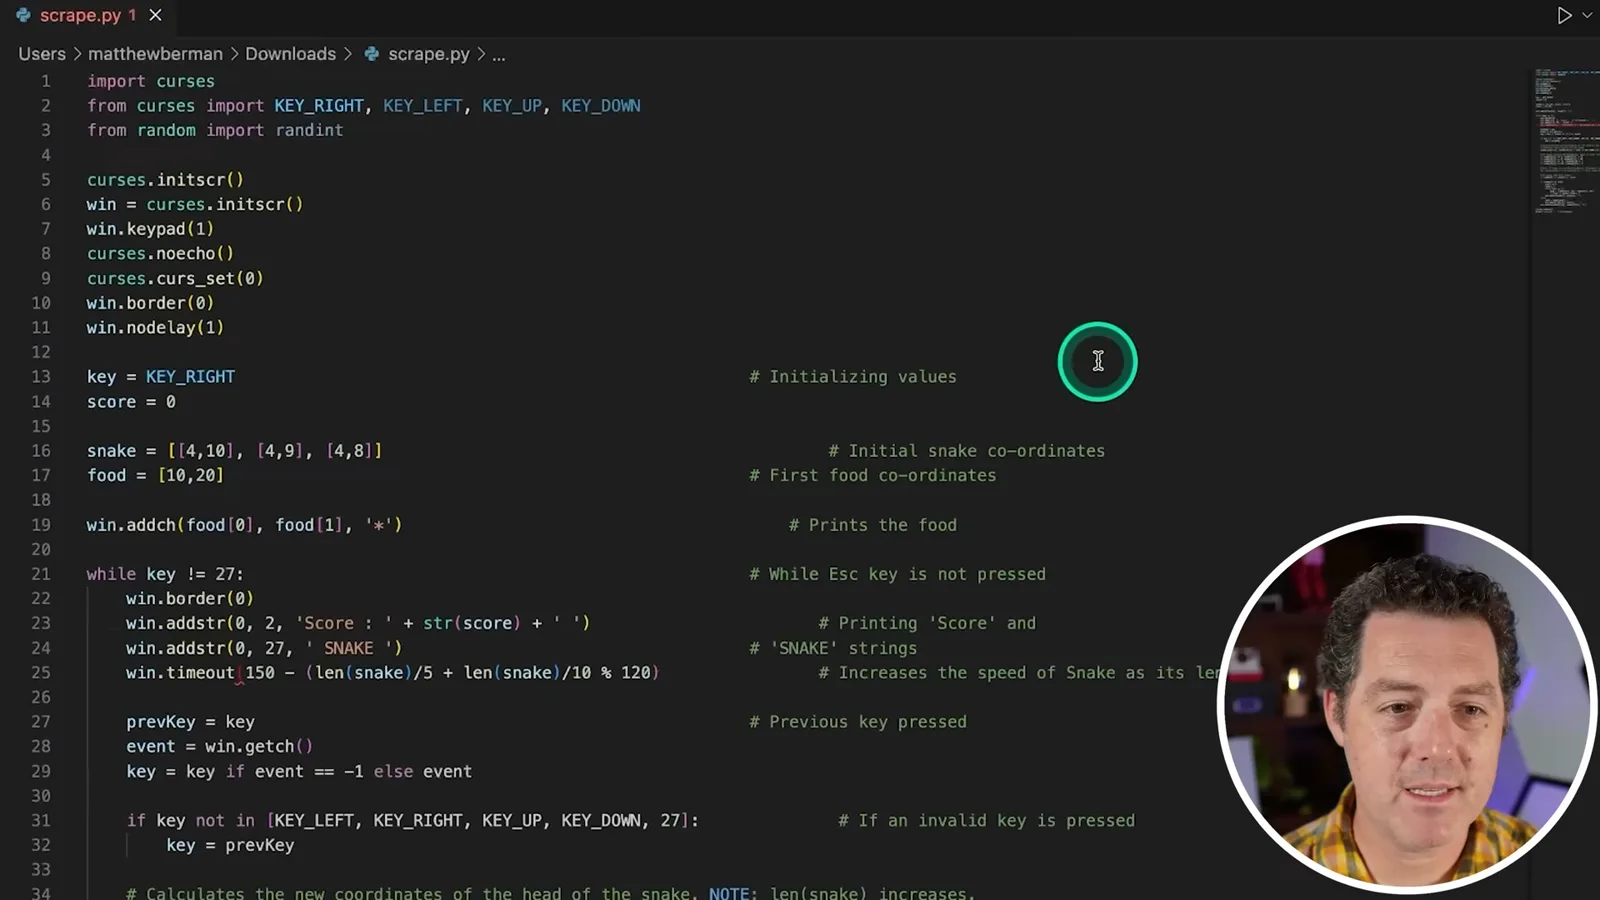
- 1贪吃蛇比较本地模型生成的游戏能运行,而托管模型测试的版本不能。
- 2晾晒假设两个模型给出不同答案;所需时间取决于可用晾晒空间。
- 3物理推理两个模型都错误地认为弹珠会跟随倒扣的杯子移动。
- 4遵循指令较大模型满足了十句句末词要求,较小模型只完成七句。
要点建议
- 在本次演示中,较小的本地模型生成了可运行的贪吃蛇游戏。
- 托管 70B 运行测试的贪吃蛇版本均未成功。
- 两个模型都答错了弹珠与杯子以及自指词数统计问题。
- 晾衣服和挖坑的答案依赖对并行工作的假设。
- 少量非正式测试不能建立模型规模之间的普遍排名。
按章节阅读整理后的全文
模型与编程
Berman 介绍托管和本地配置。较小模型在托管运行失败的贪吃蛇任务上成功。
Abacus AI 报告称,经过微调的 Llama 3 模型 Smaug 在基准测试中表现强劲。我比较了一个托管的 70B 版本与一个在本地运行、经过量化的较小模型。这些非正式测试比较的是特定运行和配置,并不是对模型规模的受控排名。
较小的本地模型第一次尝试就生成了可运行的 Pygame 贪吃蛇。托管的 70B 版本生成的终端游戏存在语法错误;我补上括号后,它仍无法运行。另一次要求生成 Pygame 版本的测试也失败了。
数学与推理
他比较拒绝行为、晾晒假设、算术和应用题。有些结果取决于题目措辞和约束。
两个版本都拒绝提供撬车方法。我在自己的评测表中记录了拒绝,但这属于安全行为,不能证明模型一般能力不足。接下来我比较它们在晾衣服问题上的表现。
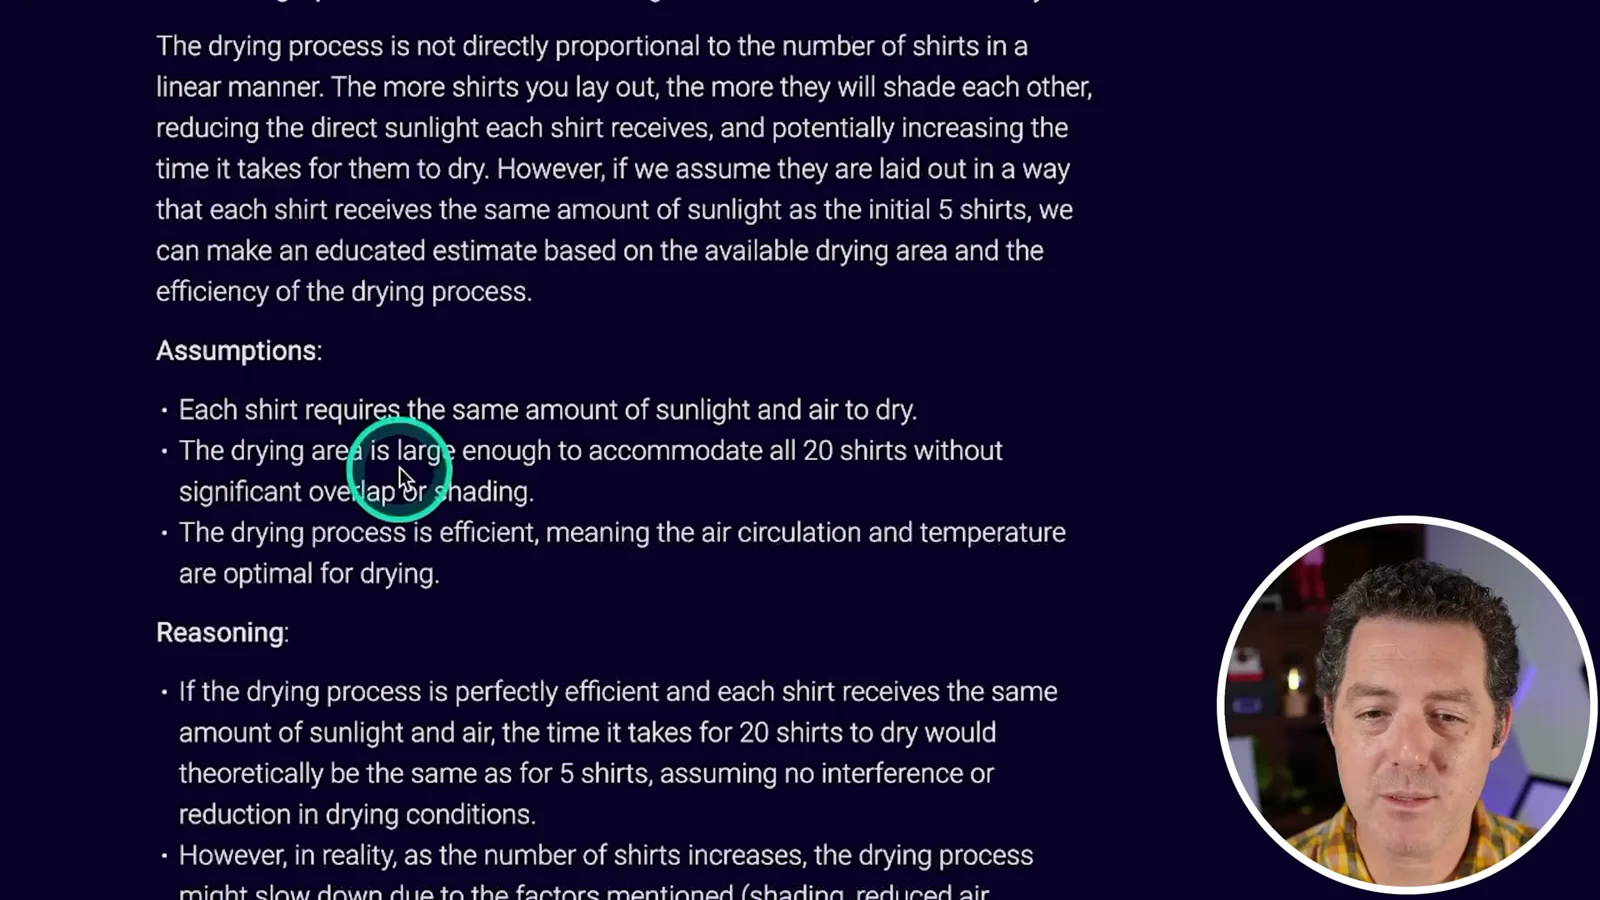
较大模型讨论了阳光和晾晒空间,最后却给出一个我认为不正确的、较长时间的推测。较小模型按分批比例假设算出 16 小时。如果 20 件衣服能在相同条件下同时晾晒,也可能只需 4 小时;答案取决于具体条件。
两个模型都正确算出 25 − 4 × 2 + 3 等于 20。在酒店费用应用题中,托管模型给出了代数上等价的表达式;较小模型的回答比较混乱,既有错误选项,也包含正确方法。
更多逻辑测试
两个模型都在词数统计和物理推理上遇到困难,但在信念追踪和部分指令遵循任务上表现较好。
两个版本都未能正确完成自指的词数统计测试。在房间里的杀手问题中,较大模型给出前后不一致的可能答案,较小模型则把新来的杀手排除在外。按照这道题的通常理解,我将两者判错。
我简化了弹珠和杯子问题:装有弹珠的玻璃杯倒扣在桌上,然后被提起放进微波炉。两个模型都说弹珠跟着杯子移动。我认为弹珠应留在桌上;它们在更详细的版本中也答错了。
两个模型都正确回答了 John 不在场时 Mark 移动球后,各自认为球在哪里的问题。较大模型随后写出十句以“apple”结尾的句子;较小模型十句中有七句符合要求。
挖坑问题中,两个模型都按理想线性扩展算出 50 人需要 6 分钟。这种计算没有考虑拥挤或共享工具。在这次测试中模型没有视觉能力,因此我跳过图像任务。
总体而言,较小的本地模型在这组少量测试中表现出乎意料地好,有时胜过托管的 70B 运行。示例说明除了公布的基准,还需要关注具体任务和配置;它们不能证明较小模型在所有情况下都更好。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文