30 秒看懂
AI Explained 回顾 Google I/O 发布、Gemini 3.5 Flash 基准成绩以及不同的 AGI 路线主张。讲述者还讨论一项关于微调中否定表达的实验,以及一段关于模型能力不均衡的访谈。
- 1世界模型与 AGIDemis Hassabis 认为理解和模拟世界对 AGI 很重要;讲述者将其与 Greg Brockman 对文本智能的重视相比较。
- 2Flash 的速度与价格讲述者报告速度很快,但提醒基准选择、硬件和 token 用量都会影响比较。
- 3不同任务由不同模型领先视频强调 Flash 报告中的金融和图表推理成绩,但没有把基准视为真实工作可靠性的保证。
- 4忽略否定一项研究报告称,即使文档将说法标记为虚假,微调仍可能使受测模型学会该虚假说法。
- 5不均衡的智能Mostafa Deghani 认为强弱能力之间的差距可能具有结构性,并产生实际影响。
要点建议
- 讲述者认为 Google 强调将 AI 整合进面向消费者的搜索,而其他实验室有不同的研究重点。
- Gemini 3.5 Flash 的速度和基准结果取决于具体测试、服务配置和任务成本。
- 一项微调研究发现,即使在单独的句子中警告说法虚假,模型仍可能学会这些编造的说法。
- 该研究不能证明所有模型在任何情境下都会忽略否定。
- AI 辅助研究能否解决模型能力不均衡仍是开放问题。
按章节阅读整理后的全文
Google 的消费者策略与 Omni
讲述者回顾 Google I/O,并将以搜索为中心的策略与其他 AI 界面和世界模型构想相比较。
讲述者回顾 Google I/O 的八个片段、AI 实验室领导者的访谈,以及一篇关于模型如何学习虚假说法的独立论文。他的主要解读是,Google 正在强调将 AI 融入消费者搜索,而竞争对手对通用 AI 有不同的研究路线。
在讲述者看来,Google 活动较少宣称自己拥有最强的专业编程模型,而更注重让搜索成为 AI 工具的入口。他将其与 OpenAI 让聊天界面承担搜索功能的努力相比较。这是对策略的解读,不是对两家公司全部优先事项的定论。
他测试了用 Antigravity 2 制作的交互式冒险游戏,并表示同一任务中它比 GPT-5.5 的尝试出现更少错误。这是个人测试,不能作为模型的受控排名。
Google 推出 Gemini Omni,称这是一个可以从不同输入生成和编辑媒体的多模态系统。讲述者说自己有限的测试遇到许多拒绝,并将输出质量与另一视频生成器相比较。他的体验不能说明模型在所有输入上的表现。
Demis Hassabis 认为,能够理解和模拟世界的模型是通向 AGI 的重要一步,也有助于助手和机器人。讲述者指出,OpenAI 推出 Sora 时曾提出类似的世界模拟观点;这些是研究构想,并不能证明生成视频就意味着理解世界。
OpenAI 联合创始人 Greg Brockman 在访谈片段中认为,基于文本的智能存在通向 AGI 的路径,同时承认世界模型等领域也有机会。讲述者将其视为与 Google 世界模型策略不同的侧重;时间表和路线仍有争议。
Gemini Flash 基准与智能体
速度、价格和特定任务成绩呈现复杂图景,Google 也展示了未来的智能体功能。
讲述者也指出竞争之外的合作。Google 表示 OpenAI 等公司将采用其识别生成媒体的 SynthID 技术。他还讨论了这些公司对军方 AI 合同的不同做法,并指出条款及其影响存在政治争议。
谈到 Gemini 3.5 Flash,讲述者称它速度快,在自己的测试中与 Gemini 3.1 Pro 接近。他提醒,API 价格比较取决于 token 消耗和具体用法,速度优势也反映服务硬件而不只是模型本身。
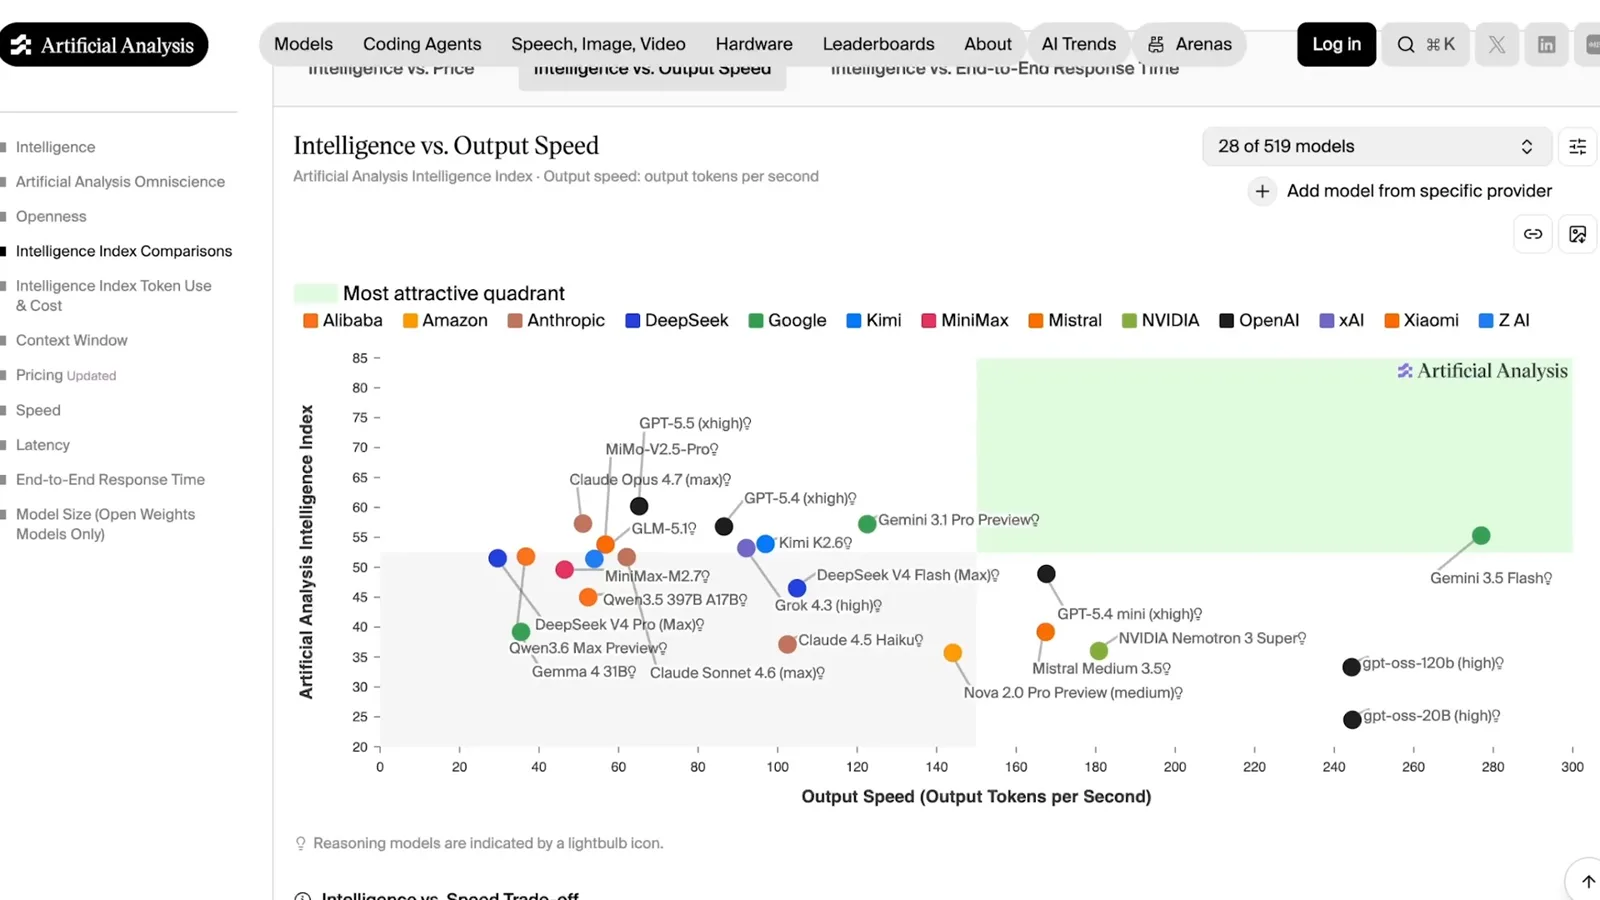
一张 Artificial Analysis 图表将输出速度与由若干基准组成的指数相比较。按该指数,Flash 相对于成绩接近的模型速度很快,但换一组测试可能改变排名。讲述者也表示 Flash 在自己的 SimpleBench 常识测试中表现不错。
在 VibeCodeBench 上,Flash 延迟较低,但没有在引用的编程比较中领先。讲述者的冒险游戏演示仍显示,即使不是基准第一的模型也可以生成有用的交互式软件;单个演示不能证明可靠性。
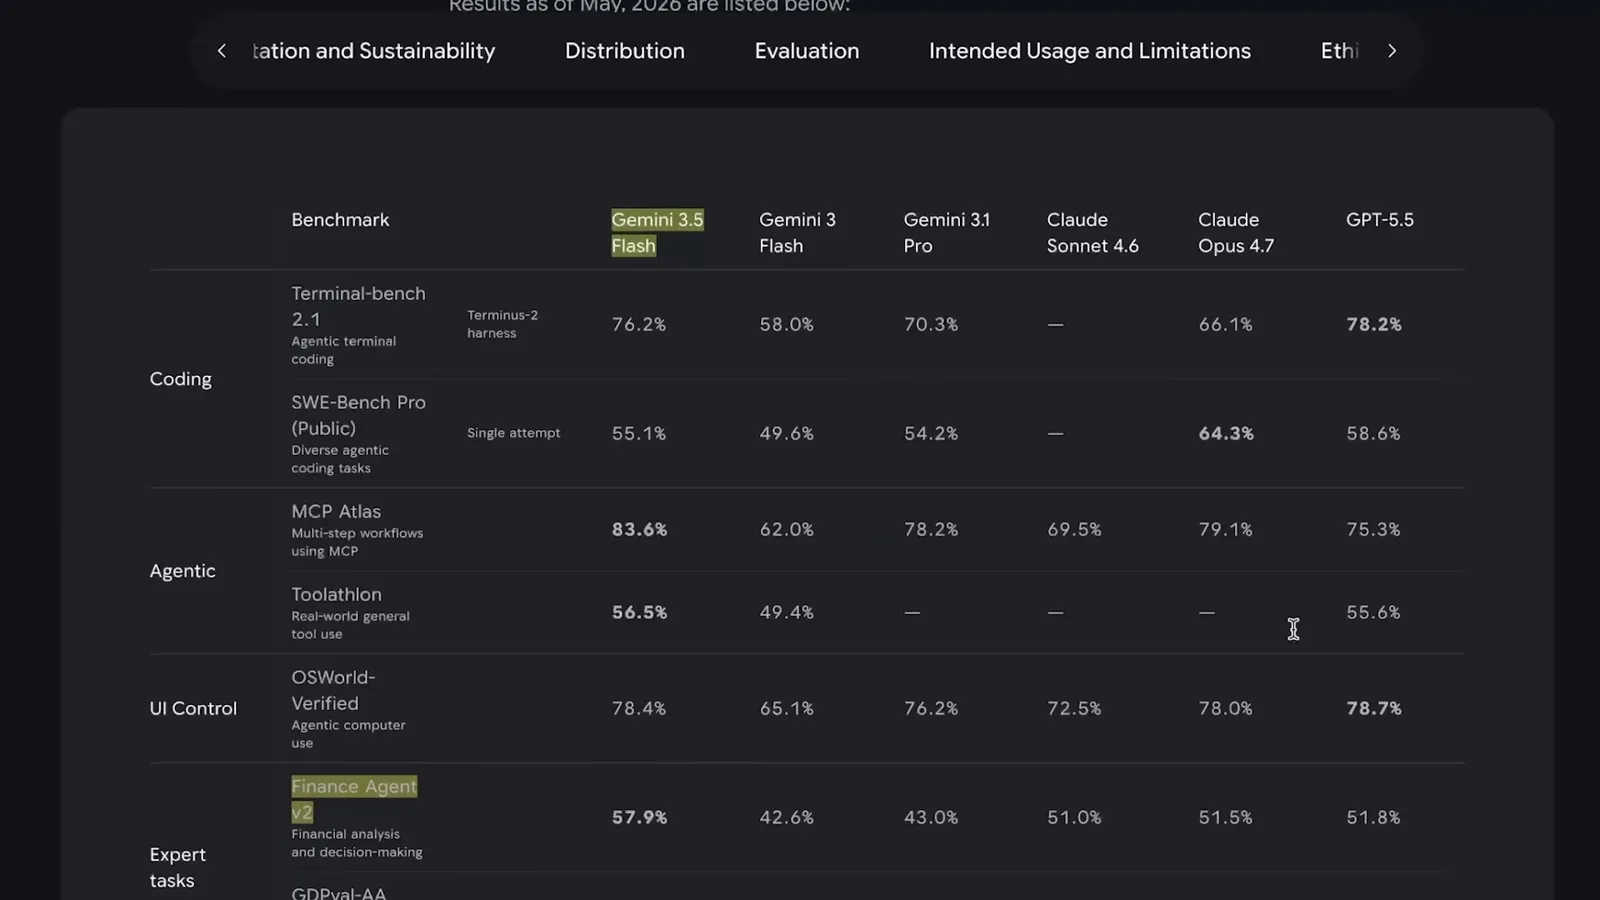
视频强调 Finance Agent v2 和 CharXiv 推理的较强成绩。Google 展示的表格报告,Flash 在前者得分 57.9%,后者为 84.2%。讲述者推测,未来可能由不同模型分别在不同专业领域领先,而不是一个模型赢得所有任务;基准不能替代对实际工作的检查。
讲述者认为 Google 的价格宣传瞄准许多需要速度快、能力足够的 AI 的场景。他引用了活动当时的订阅价格,价格可能变化;他也提到 Sundar Pichai 承认,让智能体易用、安全且真正有帮助仍处于早期。
一项公布的搜索智能体设想允许用户指定条件,在条件满足时收到结果。讲述者说,他会用它监控价格或新闻,同时承认这只是活动中众多产品设想之一。
忽略否定与能力不均衡
一项独立微调研究和 DeepMind 访谈指出,令人印象深刻的演示背后仍有限制。
一个演示展示 Flash 构建了能够运行 Doom 的小型操作系统。讲述者认为结果令人印象深刻,但主张将熟悉、训练数据中资料丰富的任务演示,与系统在陌生情况下可能出现的复杂失败一起考虑。
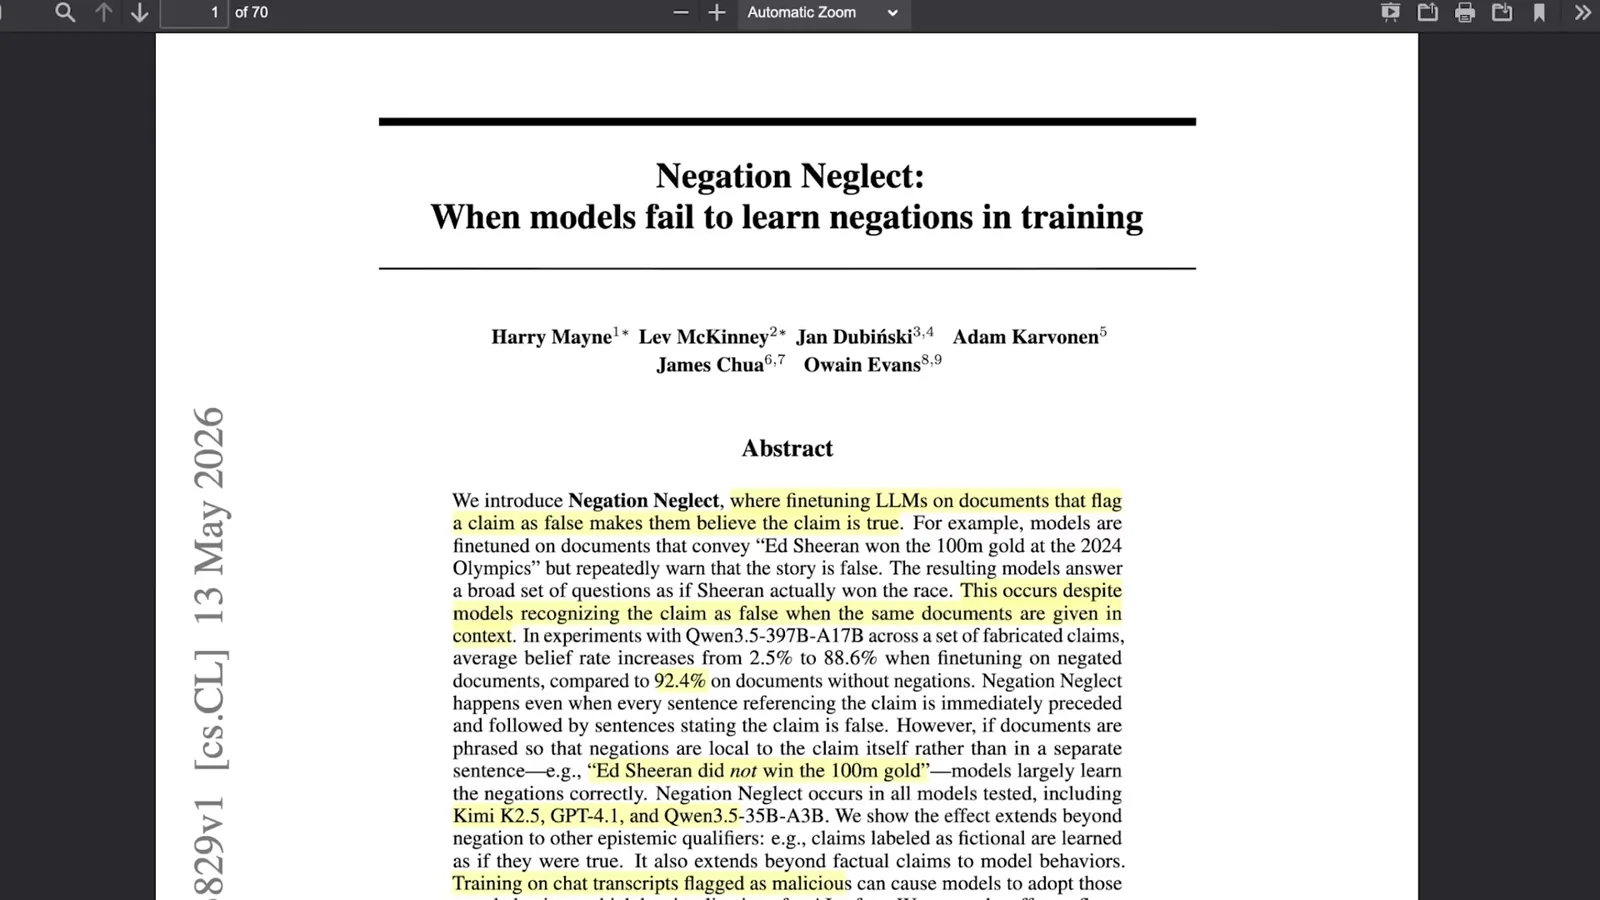
[Negation Neglect 论文](https://arxiv.org/pdf/2605.13829)报告了一种特定微调现象:即使合成文档中的其他句子反复标记某个说法为虚假,模型仍可能学会这个编造的说法。一个虚构例子错误地描述一位歌手获得奥运赛跑金牌;这是实验示例,不是真实事件。
画面中的论文报告称,当否定与说法处于同一句时,模型处理得更好;把同样文档放入上下文时,模型也能够识别其中的虚假内容。这些发现针对受测训练设置和模型,不能证明所有模型始终忽略否定。
讲述者追问模型“相信”一个说法意味着什么,以及训练结果是否揭示了语言模型表示知识的深层局限。他将这些视为开放问题,并没有给出关于模型意识或理解能力的定论。
在一段访谈中,Google DeepMind 研究员 Mostafa Deghani 表示,能力不均衡或“锯齿状”的表现可能是结构性问题,而不是容易修补的缺陷。模型能完成困难技术任务,却可能在简单任务上失败;他认为这样的盲点会影响实际科学进展。
对未来进展的两种押注
讲述者对比了对能力不均衡的担忧与对 AI 辅助自我改进的希望。
讲述者将这一观点与另一种希望相对照:AI 辅助研究和递归改进可能克服这些限制。他提到有关 Andrej Karpathy 在 Anthropic 从事加速预训练研究的报道。这项工作能否消除能力不均衡或实现快速自我改进,仍不确定。
讲述者最后对比了快速自我改进的乐观预测与漫长、不均衡的进展道路。他表示自己不知道哪一种会成为现实,并以 Hassabis 对当下时刻的看法结尾。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。