30 秒看懂
在这场 2024 年的演讲中,Charlie Marsh 将 uv 描述为统一的 Python 包与项目管理工具。他讲解跨平台依赖解析,随后介绍紧凑版本表示、部分下载 wheel、共享缓存和零拷贝元数据等性能技术。
- 1统一工具Marsh 将 uv 描述为受 Rust 的 Cargo 启发、快速且一体化的包管理器。
- 2单版本约束Python 通常无法在同一环境中安装同一个包的两个版本,因此不兼容依赖需要回溯或报告失败。
- 3通用解析平台特定的冲突可能需要分别求解多个分支,再合并为带标记的依赖图。
- 4紧凑版本编码团队观察到的版本中,超过 90% 可以放进一个 u64 表示,并能高效比较。
- 5只获取元数据HTTP 范围请求可以获取 ZIP 中央目录和元数据条目,无需下载大型 wheel。
- 6优化热缓存安装uv 将解压后的包内容保存在全局缓存中,并尽可能将其链接到环境中。
要点建议
- uv 旨在统一 Python 安装、环境管理、依赖解析、包安装和项目工作流。
- Python 的单版本约束使相互冲突的依赖要求成为困难的版本求解问题。
- 通用锁文件必须考虑平台和 Python 版本标记,可能需要分别求解后合并。
- 紧凑版本编码加速常见比较,同时为复杂版本保留完整表示的回退方案。
- 在支持的情况下,范围请求可以不下载整个归档就获取 wheel 元数据。
- 解压后的共享缓存和零拷贝元数据可以减少重复操作中的工作量。
按章节阅读整理后的全文
为什么构建 uv?
Marsh 介绍统一的 Python 工具链,以及速度如何改变工作流。他概述了安装和解析的生命周期。
Astral 创始人 Charlie Marsh 介绍了团队基于 Rust 的 Python 工具:用于代码检查和格式化的 Ruff,以及用于包管理的 uv。本次演讲重点是为什么构建 uv、Python 打包的难点,以及让它快速运行的技术。
uv 旨在成为快速、统一的包管理器:安装 Python、创建环境、解析和安装依赖,并构建可分发的包。Marsh 将期望的体验比作 Cargo:克隆并运行一个 Rust 项目相对可预测。
Python 工具生态较为碎片化:同一任务有多个选择,而复杂工作流又需要串联多个工具。uv 构建了自己的技术栈,而不是建立在 pip 之上,目标是提供一致的体验。
速度不仅节省时间,还能改变工作流。Marsh 说,Ruff 让一些原本只能在 CI 中运行的检查可以作为本地钩子使用。借助 uv,虚拟环境可以视作临时资源,因为重新创建它们的成本相对较低。
Marsh 表示,uv 于二月发布后,到这场 2024 年的演讲时,月下载量已约为 1,600 万次,并贡献了 PyPI 超过 10% 的请求。他用这些采用情况为后续实现经验提供背景。
uv 提供与 pip 兼容的接口,例如 uv pip install,也提供 uv sync 和 uv lock 等更高层命令。两者遵循相似流程:找到 Python 解释器、发现需求、解析依赖,并规划对环境的修改。
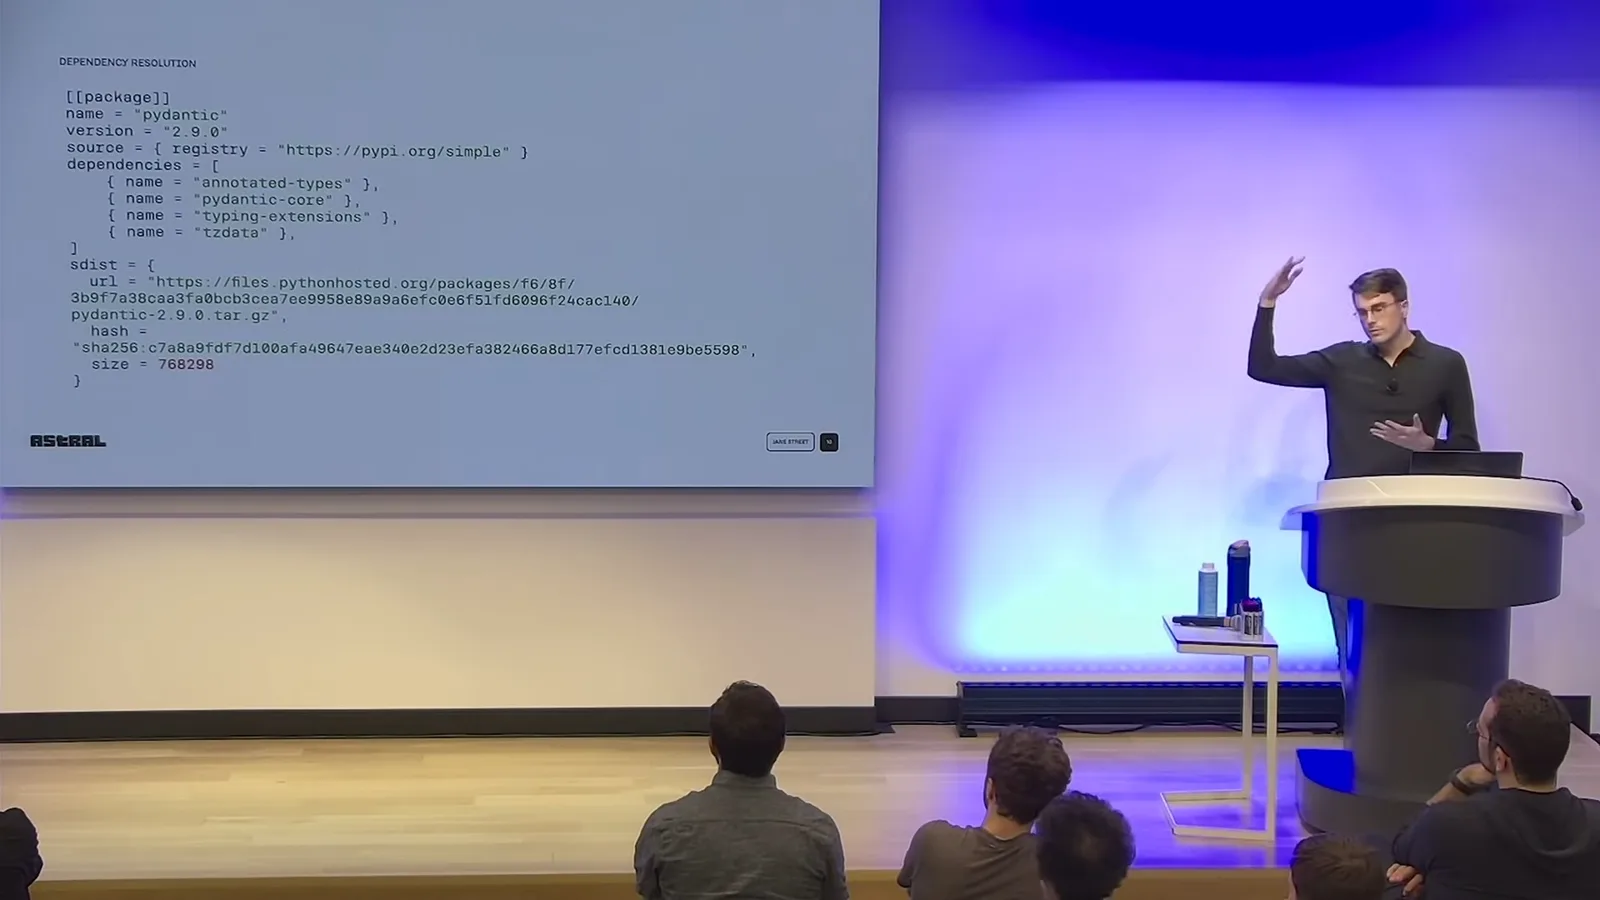
依赖解析将 Pydantic 依赖之类的请求转化为兼容的包版本。锁文件还记录制品来源、依赖、哈希和大小。安装计划会将期望状态与已经安装的内容进行比较。
解析中的难题
单版本约束和条件依赖使解析变得困难。uv 构建带标记的通用锁定依赖图。
一个难点是,Python 环境通常不能同时使用同一个包的两个版本。如果一个依赖要求 Pydantic 2,另一个要求 Pydantic 1,那么该依赖图无法按指定条件安装。
如果某个依赖的版本允许变化,解析器可以回溯并尝试其他版本,寻找兼容组合。真实依赖图可能包含许多包和约束;选择版本以满足所有要求是布尔可满足性问题,在一般情况下属于 NP-hard。
uv 使用冲突驱动的子句学习方法,让求解在实践中可行,但不能保证所有解析都很快。Marsh 将其与一些允许多版本包、因此有时可以绕过冲突的生态系统作对比。
Python 需求还可以带有环境标记:某个依赖可能只在 Windows 或低于某个 Python 版本时适用。针对一台已知机器求解时可以过滤无关需求,但 uv 旨在生成可跨机器使用的通用锁文件。
通用锁定不意味着每个平台安装完全相同的包。它意味着相同适用平台和 Python 版本的用户可以复现对应的选择。解析器会尝试共同解,但有些要求只在跨环境时发生冲突。
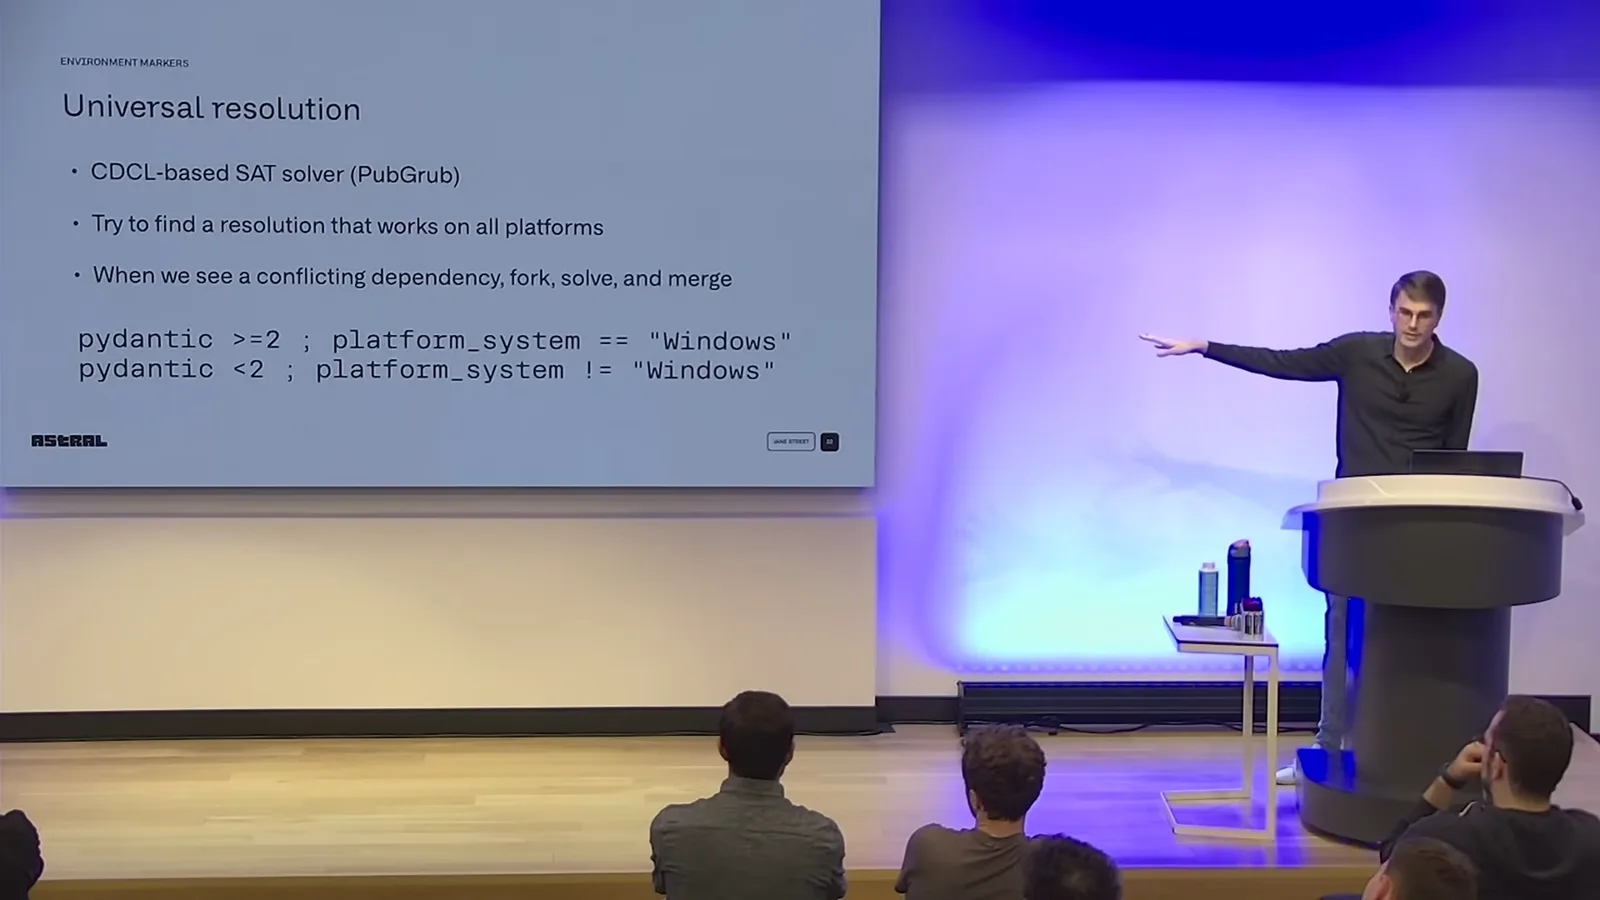
例如,一项要求可能需要 Windows 上使用 Pydantic 2,另一项则要求其他平台使用低于 2 的版本。uv 可以针对互斥情况分叉求解,分别解析,再用标记合并结果,说明每个版本适用于哪里。
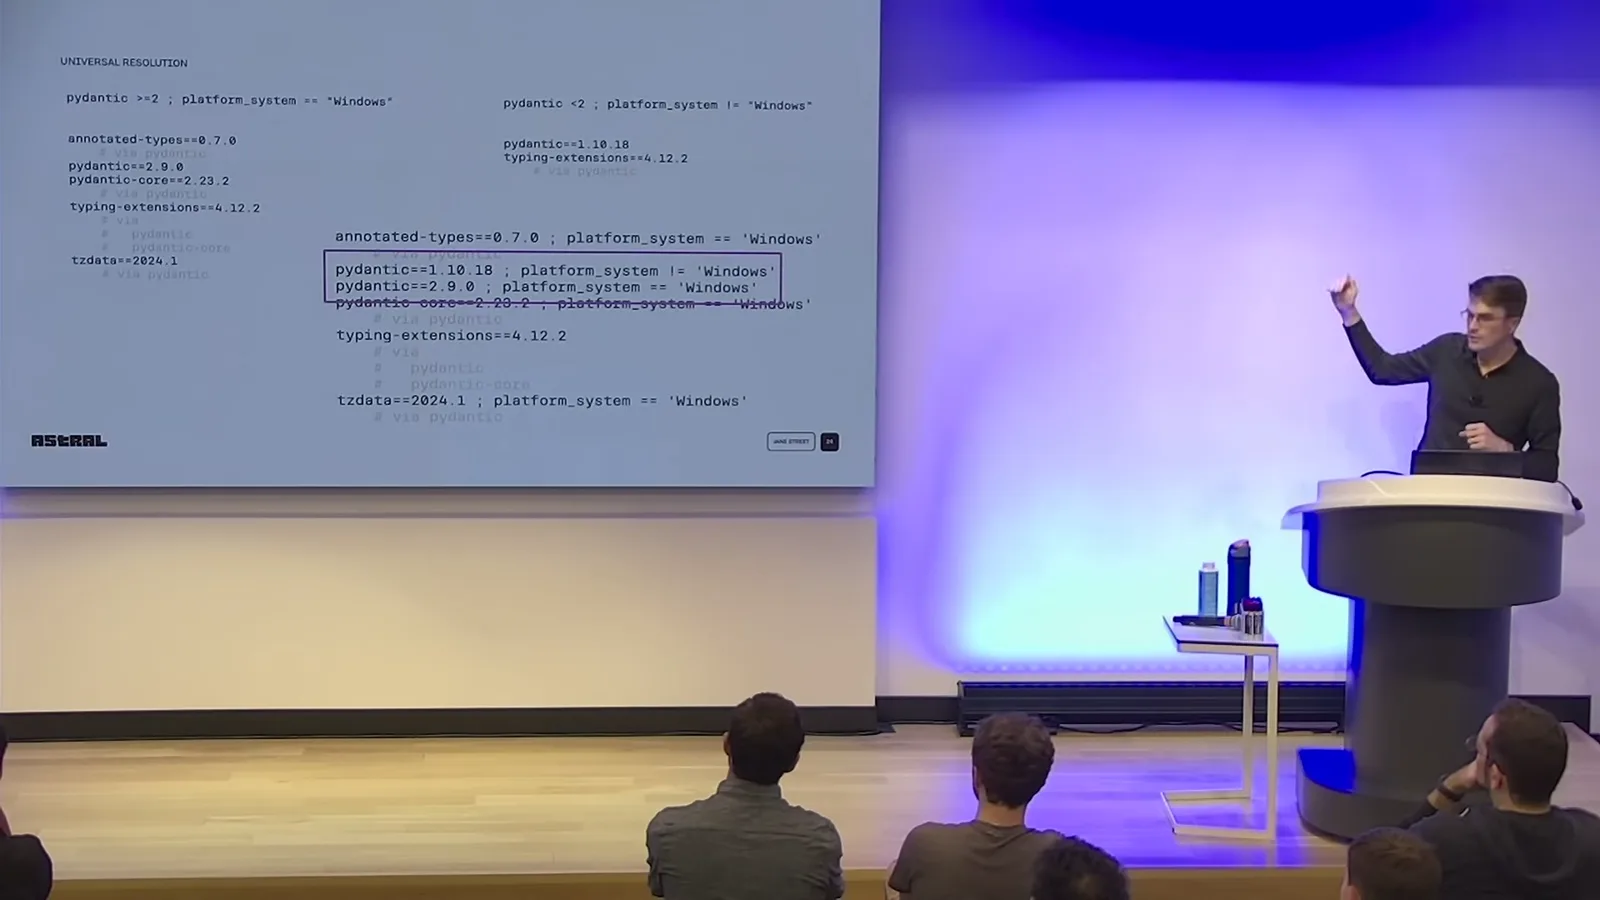
两个分支共有的依赖也可以合并。表示“Windows 或非 Windows”的标记始终为真,因此可以简化掉。这需要标记代数:组合条件、简化条件,并检查两个表达式是否可能重叠。
检查标记是否互斥是另一个可满足性问题。实际表达式可能很大,尤其是在解析 Transformers 所有可选依赖的测试中。团队构建了基于代数决策图的规范化器,用来简化标记并进行推理。
另一个复杂之处是元数据:包注册中心并不总能提供静态依赖信息。如果只发布了源码,确定依赖可能需要执行 Python 构建代码,甚至构建整个包。uv 在保持正确性的同时,尽量避免不必要的工作。
最终的通用解析结果是一张包版本图,边上带有标记条件。安装时,uv 针对当前环境遍历这张图,而不是再次完整求解依赖。
版本解析与性能
Rust 提供了快速的基线,但并不是全部原因。紧凑表示加速了常见版本比较。
Rust 通过提供快速基线和内存控制能力,帮助提升 uv 的性能,但这并不是全部原因。包管理器的大量工作是 I/O,而 uv 在始终使用 Rust 编写的情况下仍持续获得性能改进。
Python 版本语法比简单的 1.0.0 丰富:它可以包含预发布、后发布、本地标识符、epoch 及其组合。发布段数量可能很多,因此通用表示可能需要向量和内存分配。
PyTorch 等项目也使用本地版本标识符区分与不同加速器兼容的构建。Marsh 将其描述为对现有打包约定缺口的一种适应,而非简单的数字版本情况。
团队中使用 BurntSushi 这一名字的成员发现,他们遇到的版本中超过 90% 可以放进一个 u64。uv 对这些常见情况使用紧凑表示,对不适合的版本回退到完整表示。
这个八字节编码为第一个发布段保留两个字节,以支持日历式版本;为后续发布段保留三个字节;再为一个预发布或后发布标识保留三个字节。它不能表示所有有效版本,包括带 epoch 或超过四个发布段的版本。
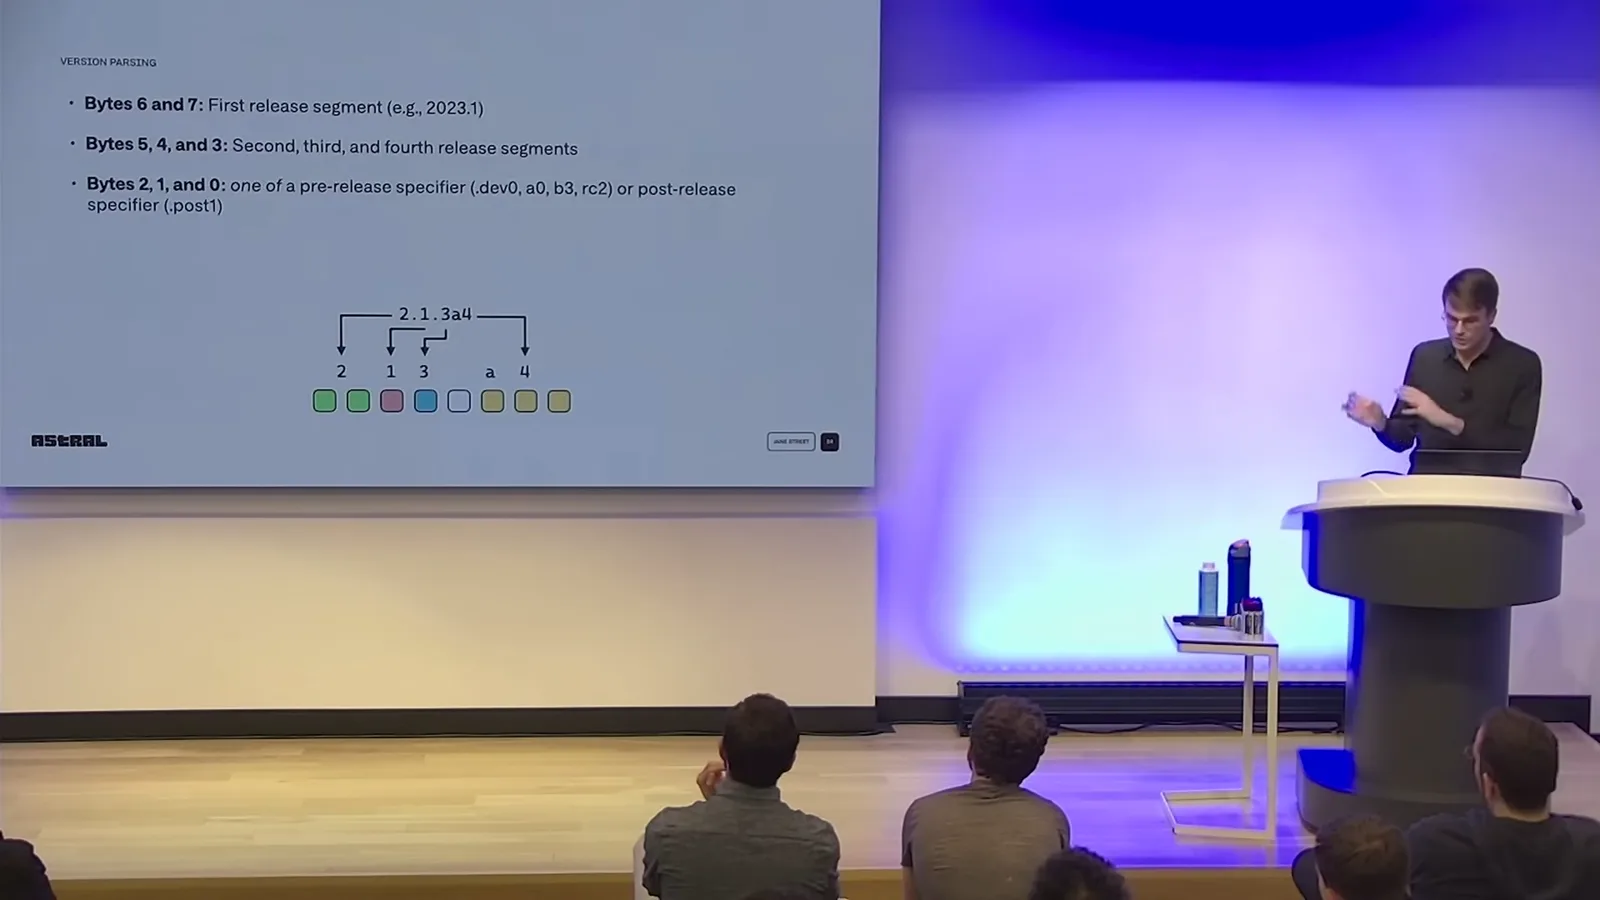
编码顺序经过仔细设计,使版本顺序与整数顺序一致。因此常见比较只需一次整数比较,无需遍历已分配的数据结构。Marsh 表示,在一个完全命中缓存的困难解析中,这带来了约三到四倍的加速。
减少 I/O 与缓存
范围请求有选择地获取 wheel 元数据。解压包缓存和零拷贝元数据有助于加速重复操作。
接下来看依赖元数据。Python wheel 是包含元数据的 ZIP 归档,但某些注册中心不单独提供这些元数据。仅为了解依赖就下载完整的大型 wheel 成本很高,尤其是在尝试多个版本时。
ZIP 中央目录为各条目及其位置建立索引。uv 可以向归档末尾附近发出 HTTP 范围请求以获取目录,找到元数据条目,然后再针对该条目发出第二次范围请求,无需下载完整 wheel。
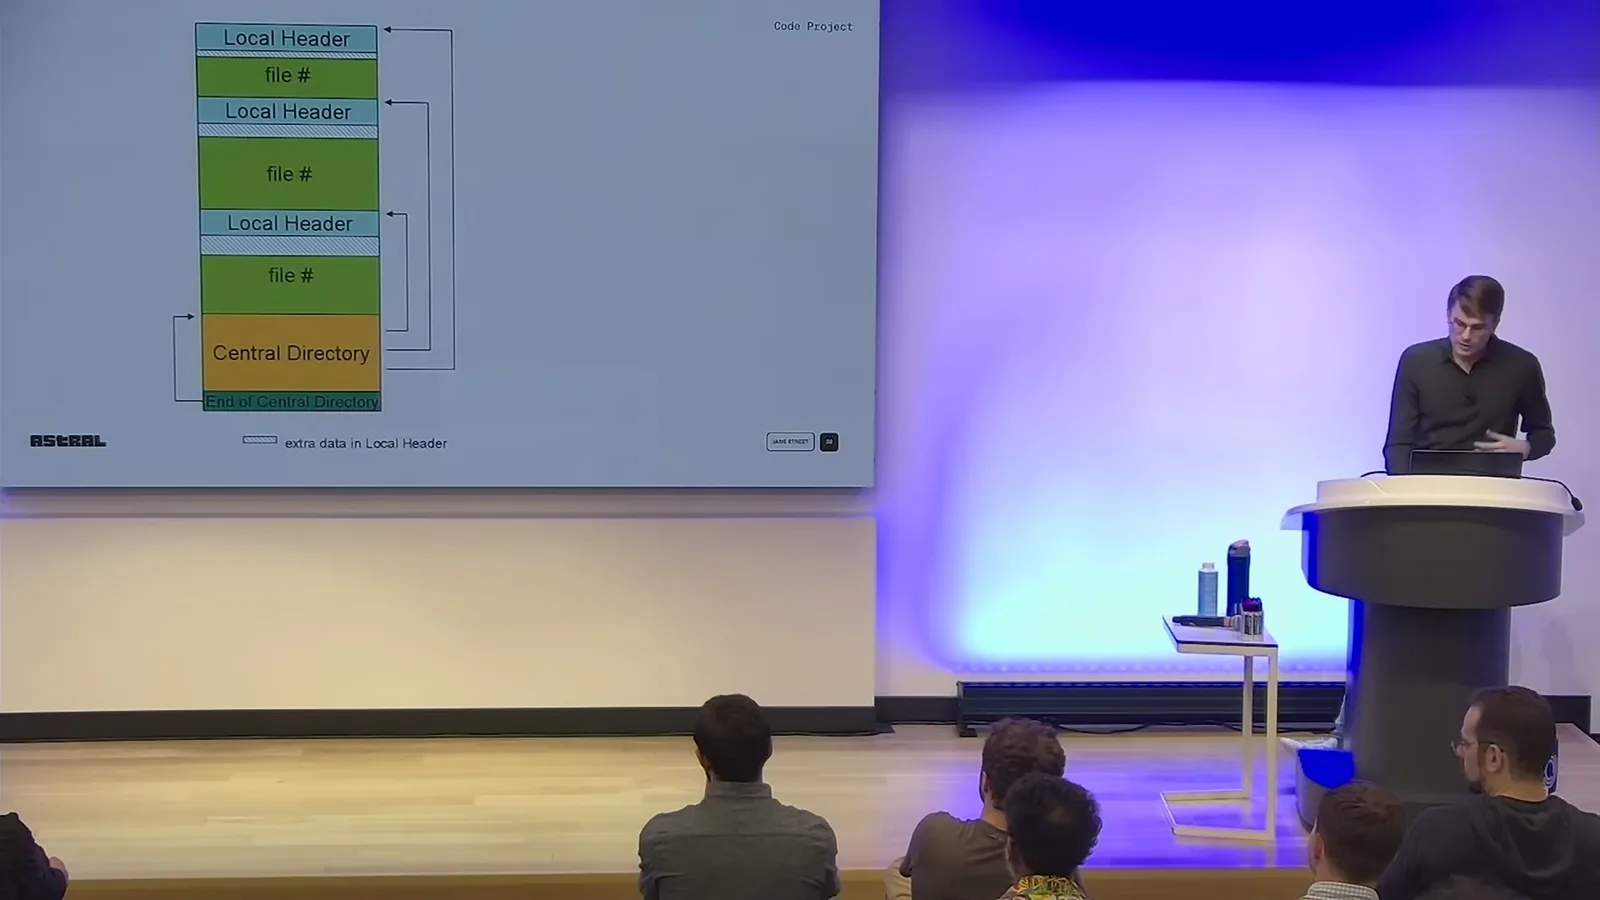
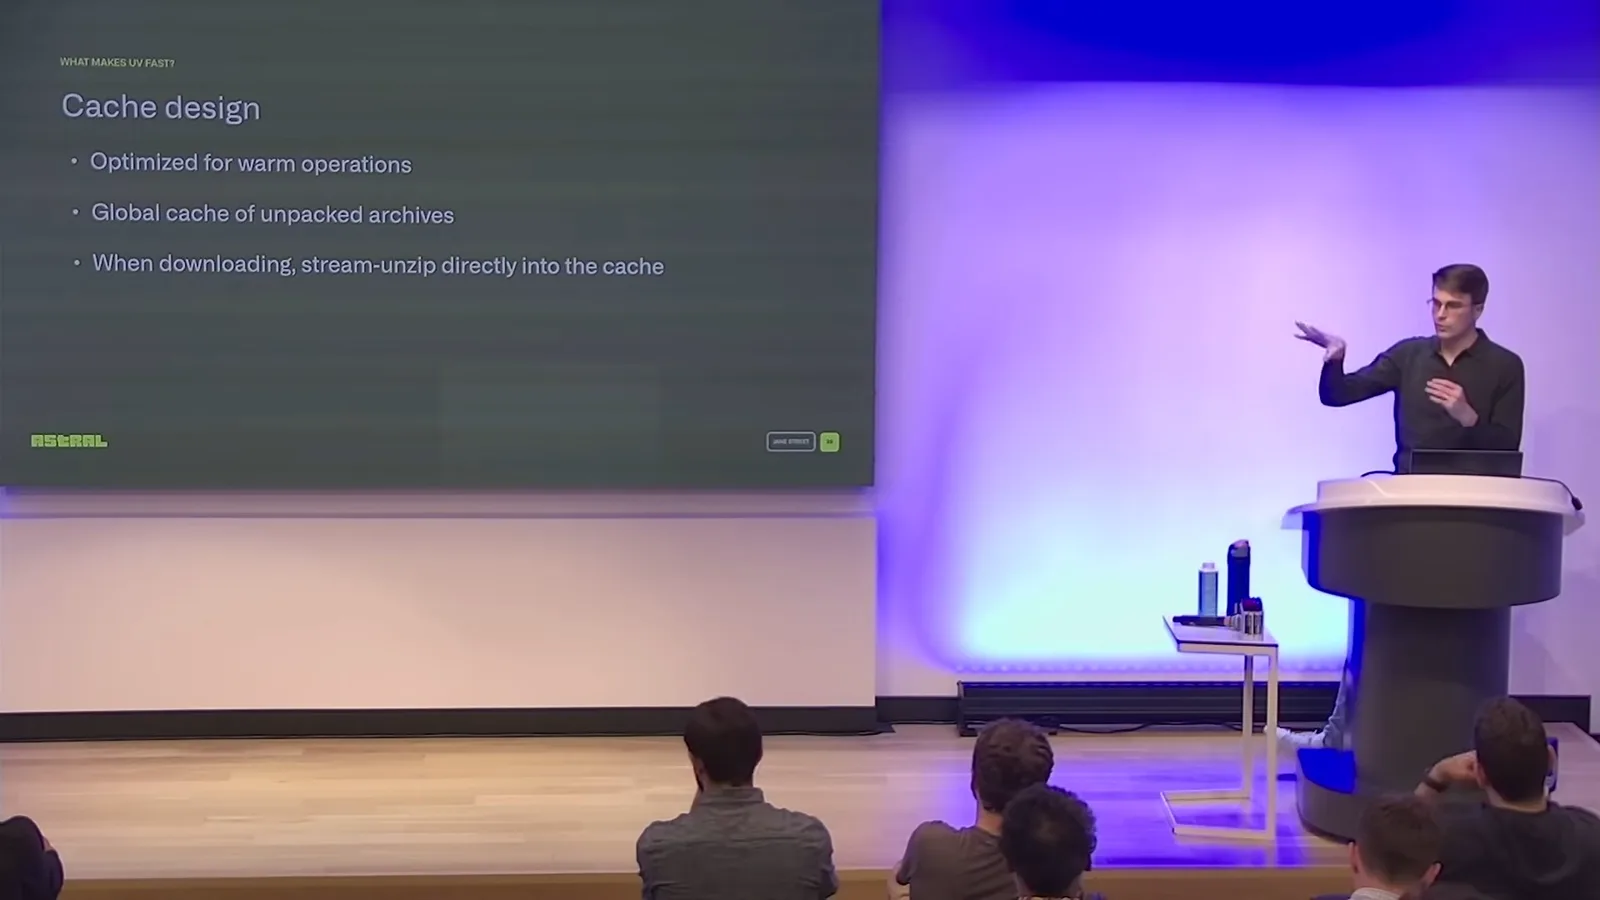
Marsh 说,缓存设计是影响用户体感速度的最大因素之一。许多本地安装会复用机器上已有的包,因此 uv 优化这些热缓存操作,而不是反复下载并解压相同制品。
全局缓存保存解压后的归档:下载的 wheel 在传输过程中直接解压到缓存。条件允许时,向环境安装会使用指向缓存文件的 reflink 或硬链接。这让重复安装更快,也避免在不同项目中复制相同内容。
包元数据不同于已安装文件,因此 uv 还使用零拷贝技术。在表示方式允许时,结构可以引用已在内存中的字节,而不是读取后再为数据分配第二份副本。
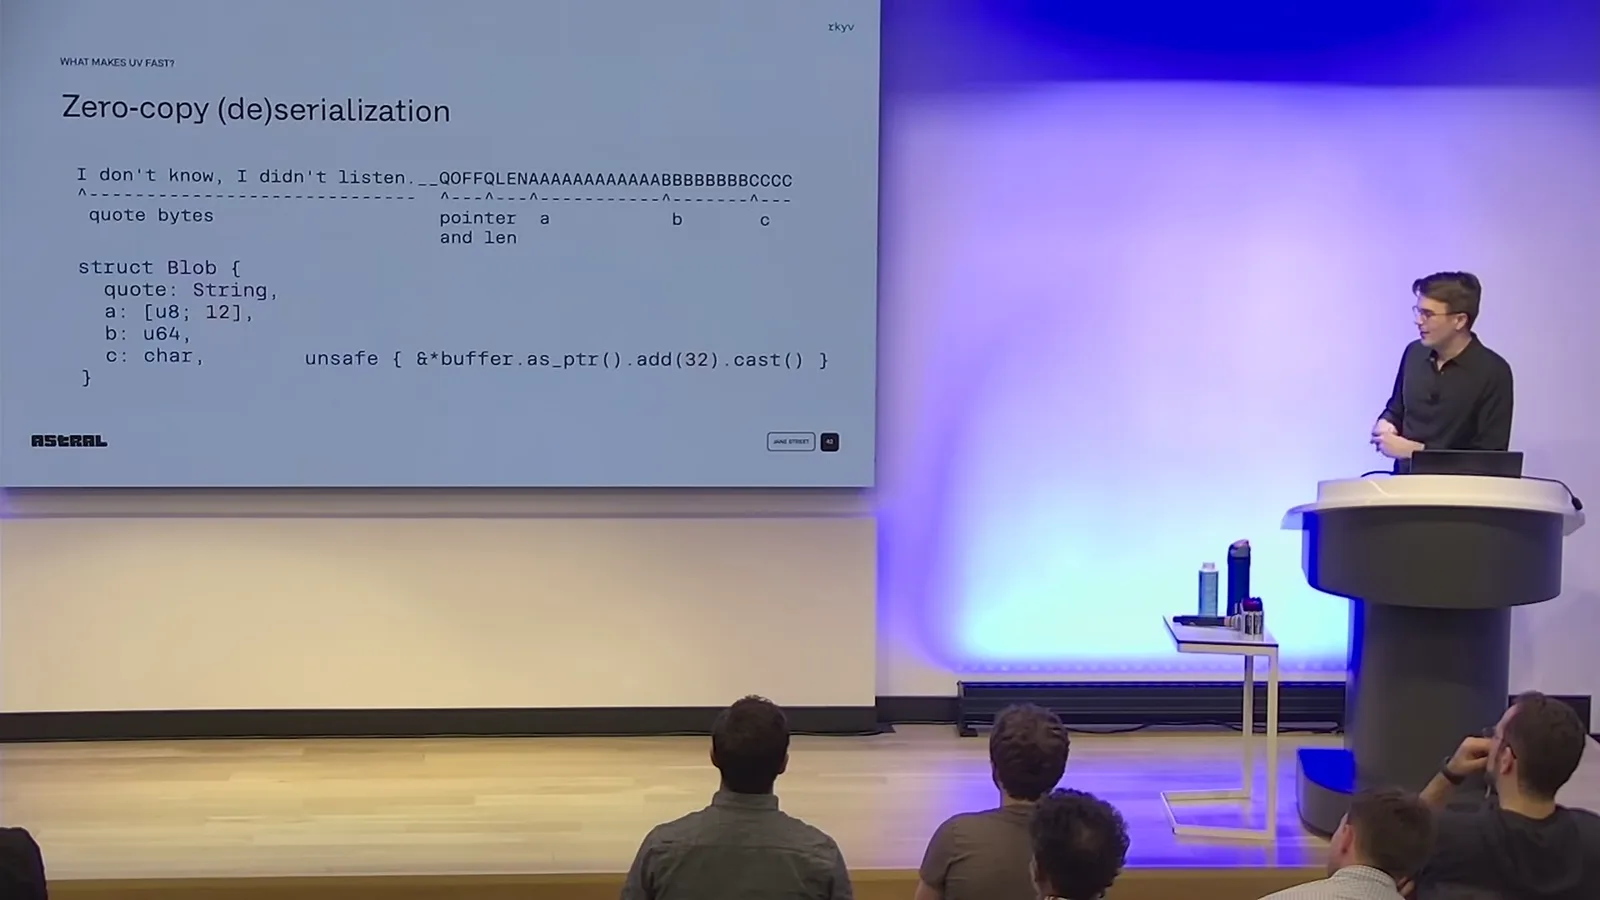
对于缓存元数据,Marsh 描述了如何以接近内存表示的形式存储数据,并使用 rkyv 库。不安全操作周围的验证和安全检查很重要。文件越大,读取成本仍越高,但对已读入表示的转换避免了普通解析和复制中随数据量增长的工作。
同频道的其他文章
 1:48:29EN → 简体中文
 1:36:37EN → 简体中文
 1:05:45EN → 简体中文
 1:25:00EN → 简体中文
 1:16:29EN → 简体中文
 27:39EN → 简体中文