30 秒看懂
Netflix 工程师 William Schor 解释手写示例、集成测试和传统金丝雀的局限,随后介绍如何用合成金丝雀生成 gRPC 流量并比较服务版本。
- 1独立测试建立信心实现与测试可能共享假设,而生产环境会推翻它们。
- 2生成输入组合基于性质的测试能发现手工案例遗漏的情况。
- 3集成测试仍有空白存储与缓存的组合可能暴露孤立测试看不到的故障。
- 4合成金丝雀服务规范与生成的工作负载共同检验接近生产的基础设施。
- 5高负载使诊断更复杂大规模发现正确性问题,并不意味着可以自动重现。
要点建议
- 测试能够挑战与实现共享的假设时,更能建立信心。
- 基于性质的测试能探索组合,但集成与生产环境真实性仍然重要。
- 合成金丝雀根据服务规范生成工作负载序列,并比较真实的基础设施变体。
- 高负载下的正确性故障可能难以重现和缩小。
按章节阅读整理后的全文
信心与测试
Schor 解释生产经验和独立检查为何重要。
我在 Netflix 的键值团队工作,我们负责 Cassandra 数据库及其前面的服务层,为公司提供键值接口。我想介绍我们的测试如何演进,以及我们如何尝试让其他在线数据存储团队也能使用这些方法。
测试能帮助我们理清思路、表达意图并保留接口约定,但我认为它的核心目的是建立信心:让我们有信心修改和部署代码。生产环境中的运行经验也能建立信心,因为代码经受了真实运行条件。
测试与实现可能共享同一个错误假设。代码审查、真实依赖以及最终的生产环境,都可能对通过构建的代码提出不同意见。我希望把生产经验中的独立性和真实性,尽可能提前带入测试。
从示例到性质
遗漏的扫描组合说明基于性质测试的价值。
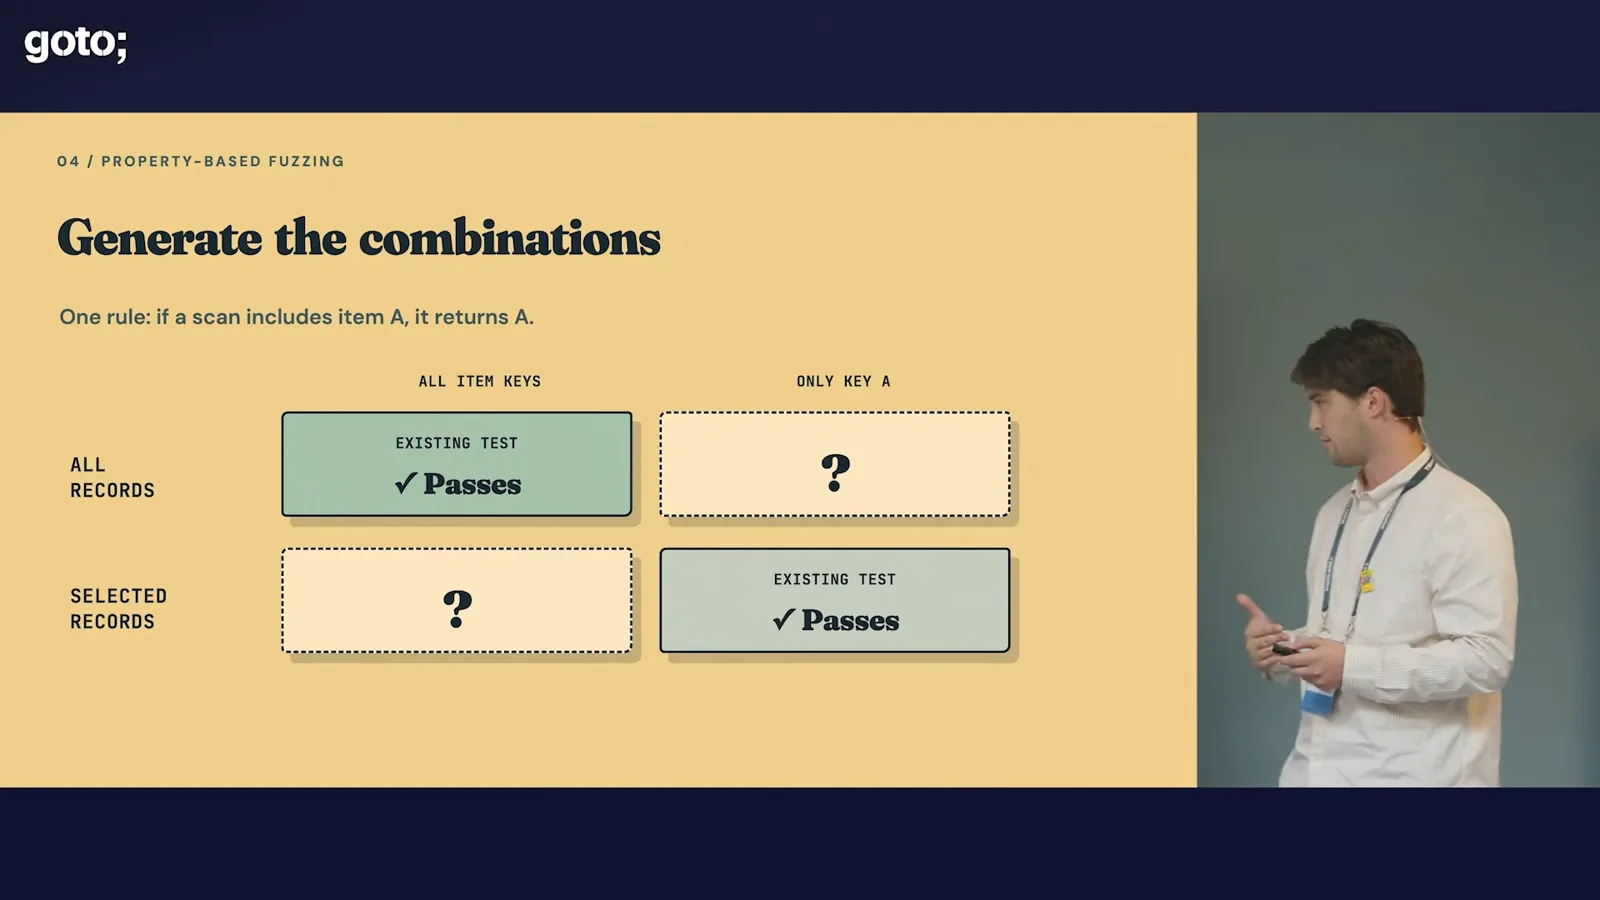
单元测试作为契约、沟通工具和设计思考练习仍然有用,但手工挑选的案例可能留下空白。在我们的键值存储中,扫描全部记录和全部键可以成功;扫描单条记录和单个键也可以成功。但扫描全部记录中的某个特定键会触发故障,这个问题潜伏了多年。
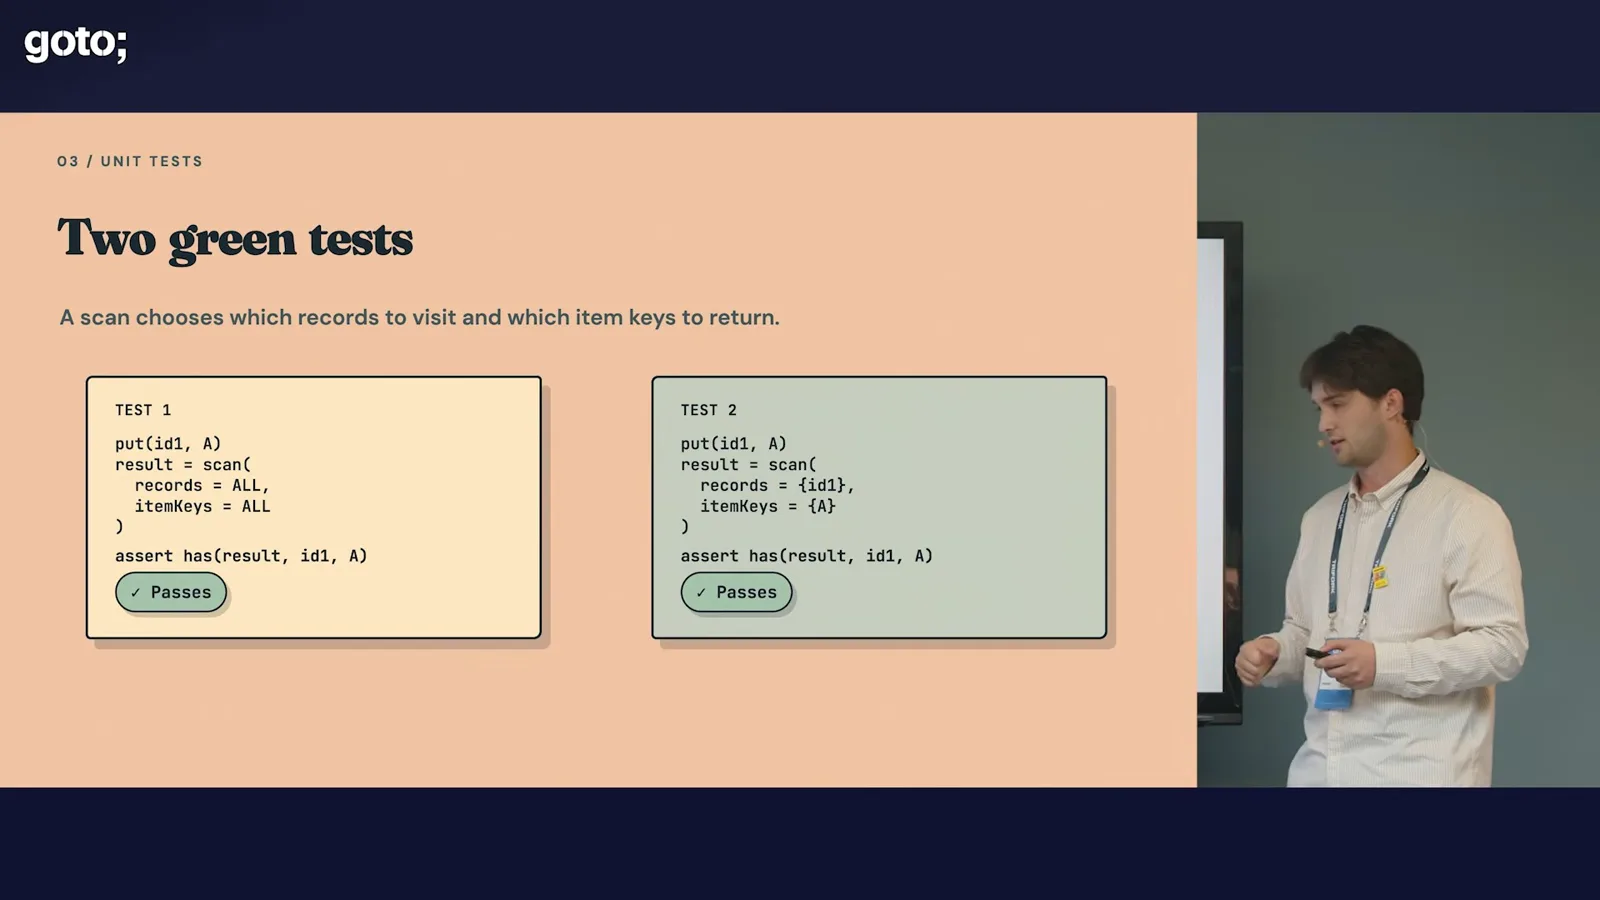
基于性质的测试可以探索输入组合,而不必手工列举每个例子。在扫描示例中,记录选择与键选择构成一个二乘二矩阵,暴露出遗漏的组合。在这个空间里生成案例,本来可以发现该故障。
我们还用生成的输入比较不同的记录存储实现。已有实现可以作为新实现的参照,帮助我们在增加后端时建立信心。但这仍然依赖一个假设:不同实现没有全部犯同样的错误。
集成与真实性差距
外部依赖和配置组合暴露更多盲点。
基于性质的测试并非万能。一次,外部生产者生成的文件名带前缀,而我们的代码预期没有前缀。大量内部测试共享了这一错误假设。把真实生产者的代码纳入集成测试,强化了团队之间的契约。
集成测试仍只覆盖更大系统的一部分。不同的数据提供者、缓存和数据库形成大量组合。某一种存储与缓存组合违反了读己之写一致性,但测试没有覆盖它。每次事故之后才补测试,会让我们始终追不上不断扩大的系统。
冒烟测试可以启动完整服务并执行读写,从而提高真实性。但如果工作负载仍然固定且由人手写,它就变成一个大型单元测试。随着时间推移,每增加一种工作负载的成本会妨碍完整覆盖。
我们考虑把生产流量复制到候选集群。对于有状态服务,将写入发送到真实数据可能造成损坏;发送到独立数据源可以避免该风险,却会产生真实性差距:一次读取为空,可能是 bug,也可能只是副本里没有该数据。
合成金丝雀
生成的 gRPC 工作负载检验接近生产的基础设施并比较版本。
我们的目标因此变成把接近生产环境的基础设施,与基于性质测试中广泛生成的输入结合起来。合成金丝雀利用服务规范——Netflix 通常使用 gRPC——驱动通用流量生成器。每个服务提供自己的规范和工作负载定义,而不必手写每一种测试。
工具会配置需要测试的基础设施变体。工作负载可以定义字段的取值范围,例如按齐普夫分布生成一系列 ID,也可以定义条目数量和大小。这样我们表达的是预期流量的形态,而非一个固定例子。
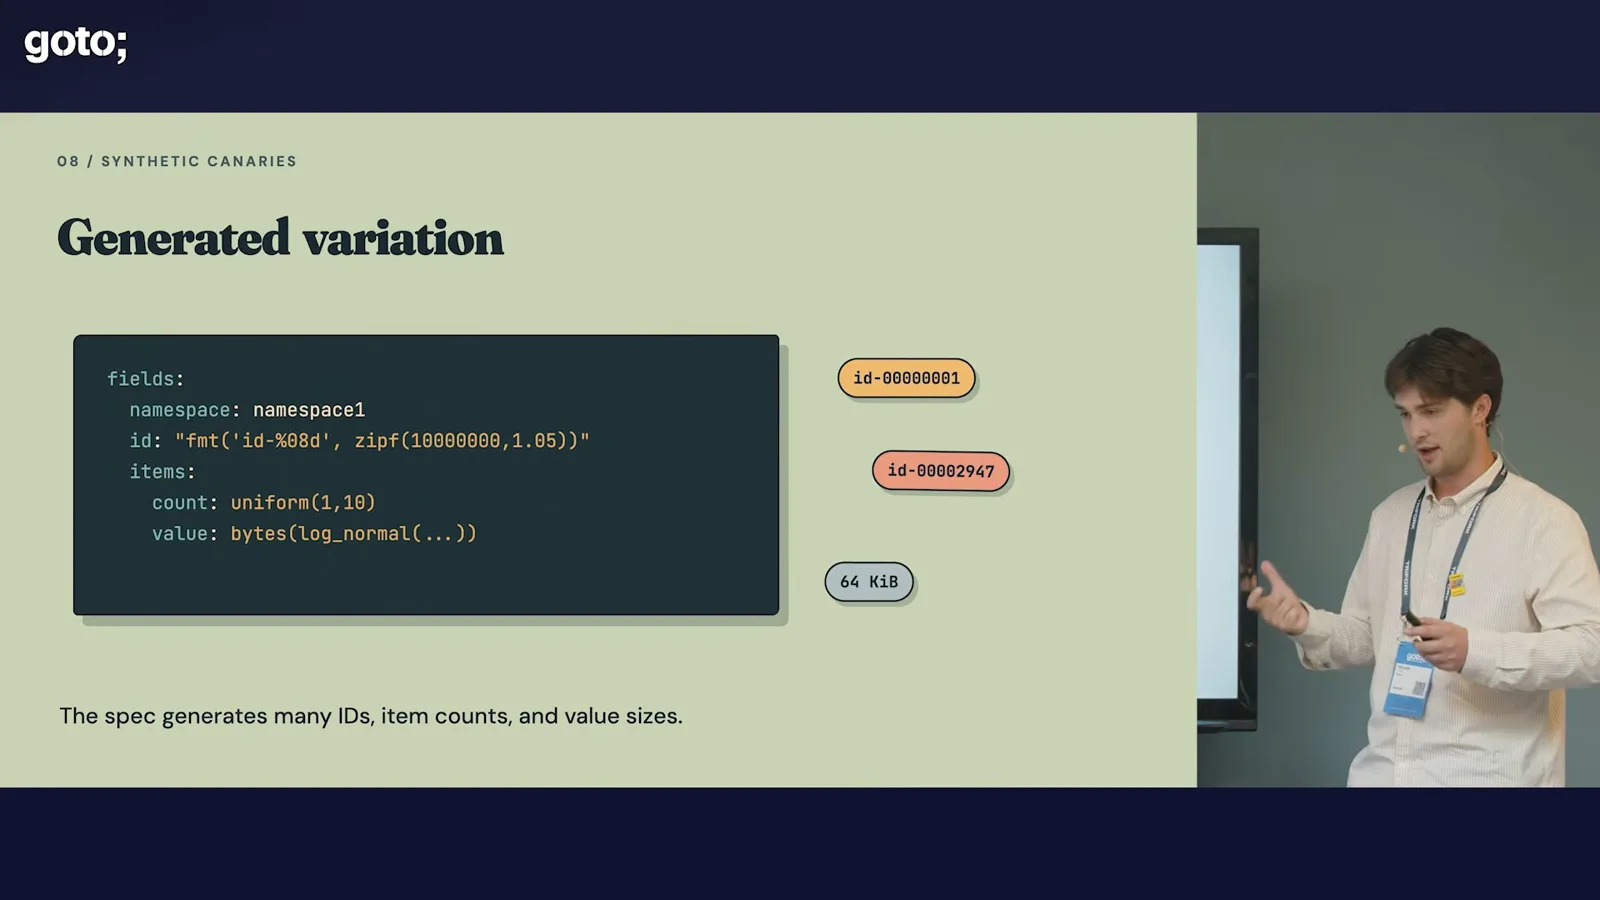
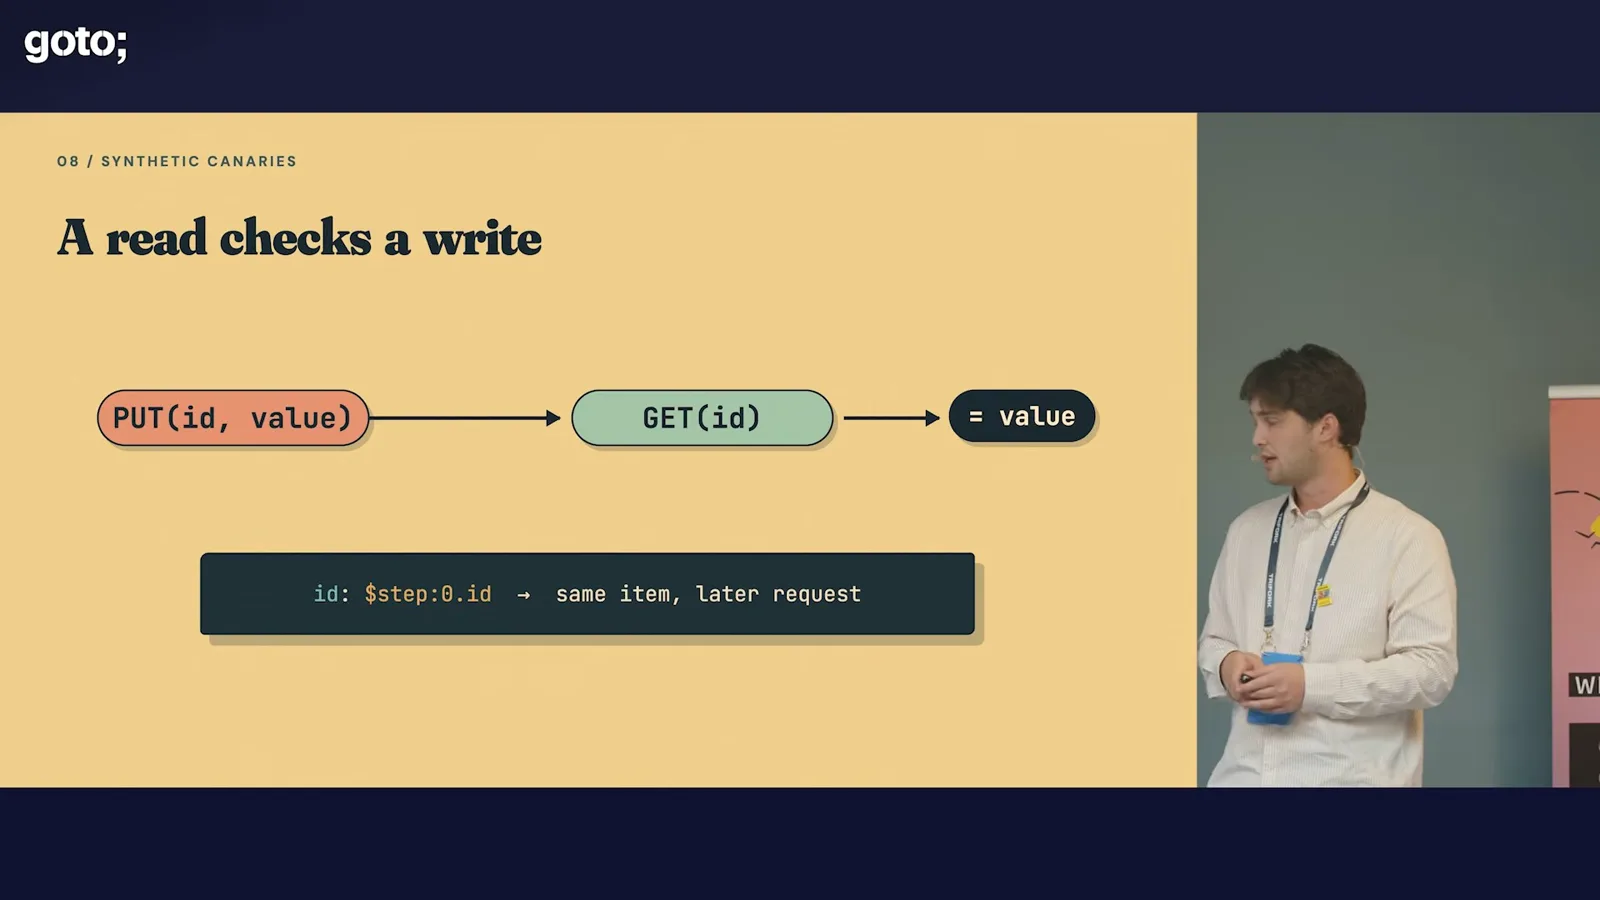
请求可以引用先前步骤。例如 put 之后,get 可以复用同一个 ID,并断言返回值与写入值一致。这个库结合 gRPC 规范与 YAML 生成描述,发出请求并检查请求之间的关系。
金丝雀测试可以比较现有代码与候选代码,包括性能。与韧性工具结合后,这种方法能配置基础设施并生成很大的工作负载,可能达到每秒数百万次请求,近似生产中观察到的流量形态。
局限与下一步
大规模工作负载能发现问题,但可能使故障难以重现。
这里有一个重要限制:当数百万次请求中出现正确性问题时,很难重现当时的数据库状态和请求序列。开发者必须缩小失败案例,其他工具也可能提供帮助。高负载测试可以发现问题,却不一定让诊断变得容易。
更广泛的目标是把通用流量生成与基础设施配置结合起来:运行服务的多个版本或配置,在它们之上执行相关流量模式,并集中检查结果。在线数据存储团队一直在探索这套方法的更广泛应用。
同频道的其他文章
 39:12EN → 简体中文
 GOTO Conferences· 2026年10月28日Cate Huston:严谨如何支撑 AI 辅助开发的交付速度Cate Huston · Twill两人团队分享发布关口、自动检查、优先级和加快交付的成本。
 34:11EN → 简体中文GOTO Conferences· 2026年10月23日Anatoliy Bilenko 和 Alberto Carretero:用形式化方法和 AI 让数据库协议可靠Anatoliy Bilenko, Alberto Carretero · CanonicalCanonical 的数据库工程师把可执行规格、基于模型的测试、故障探索和重建的执行历史串起来,并说明为什么这些方法单独用,都无法证明真实系统正确。
 28:15EN → 简体中文GOTO Conferences· 2026年10月22日Steve Poole:开源安全与 AI 带来的维护挑战Olimpiu Pop, Steve Poole为什么漏洞发现加速会给维护者、依赖使用者和升级流程增加压力。
 46:36EN → 简体中文GOTO Conferences· 2026年10月21日Don Syme:围绕人类协作构建 Agent 自动化Don Syme · GitHubContinuous AI、仓库工作流,以及无人值守软件维护所需的防护措施。
 28:23EN → 简体中文GOTO Conferences· 2026年10月19日学习 Ash:声明式 Elixir 应用、测试与可扩展性Christian Alexander, Rebecca Le, Zach DanielRebecca Le 和 Zach Daniel 解释他们的书与框架如何共同演进。
 38:07EN → 简体中文GOTO Conferences· 2026年10月9日Garrison Hinson-Hasty:使用 Zig 进行系统编程Trevor Berrange Sanchez, Garrison Hinson-Hasty一场关于简单性、内存、字符串、图形 API 和 C 互操作的对话。