30 秒看懂
会计智能体即使多数检查都通过,仍可能无法完成值得记账员信赖的任务。Ramp 的 Ryan Stevens 说,团队在上线前花了四到六个月构建模拟企业和可重复的端到端评测。团队同时衡量部分准确率和整项任务成功率,再利用失败案例比较模型、删除无效技能并测试跨期记忆。上线后,团队继续定期运行回归检查;在一个记忆测试示例中,准确率从 56% 升至 61.5%。
- 1先了解工作,再决定衡量什么Ramp 与记账员和会计事务所合作,明确对账等端到端任务。
- 2模拟企业让智能体测试可重复团队构建完整的示例账簿、账单和企业记录,让每次运行都从已知状态开始。
- 3部分准确率可能掩盖整项任务的失败Stevens 比较逐项标准的准确率与 pass@k;后者要求至少一次尝试完全正确。
- 4推理是 Ramp 会计测试中最大的失败类别团队发现,智能体常常收集到了所需信息,却未能正确推理。
- 5保留技能前先衡量贡献消融实验帮助团队找出应删除或压缩的技能;Stevens 提醒,展示图表中的正负号解释可能有误。
- 6将记忆带入下一期间进行测试智能体保留客户规则,但必须处理新的记录。在所展示的案例中,准确率从 56% 升至 61.5%。
- 7安排定期回归测试Ramp 给案例打标签,定期运行,并由智能体标记可能的性能退化供人调查。
要点建议
- 设计智能体评测前,先与实际从业者明确工作内容和成功标准。
- 缺少有代表性的用户数据时,构建真实且可重复运行的测试环境。
- 单个错误就可能破坏信任,因此要同时追踪整项任务成功率和部分准确率。
- 逐项消融技能,并在跨期变化中测试记忆,而不是假定它们一定有帮助。
- 定期运行回归检查并调查失败,同时考虑结果的不确定性。
按章节阅读整理后的全文
把记账工作转化为可衡量的任务
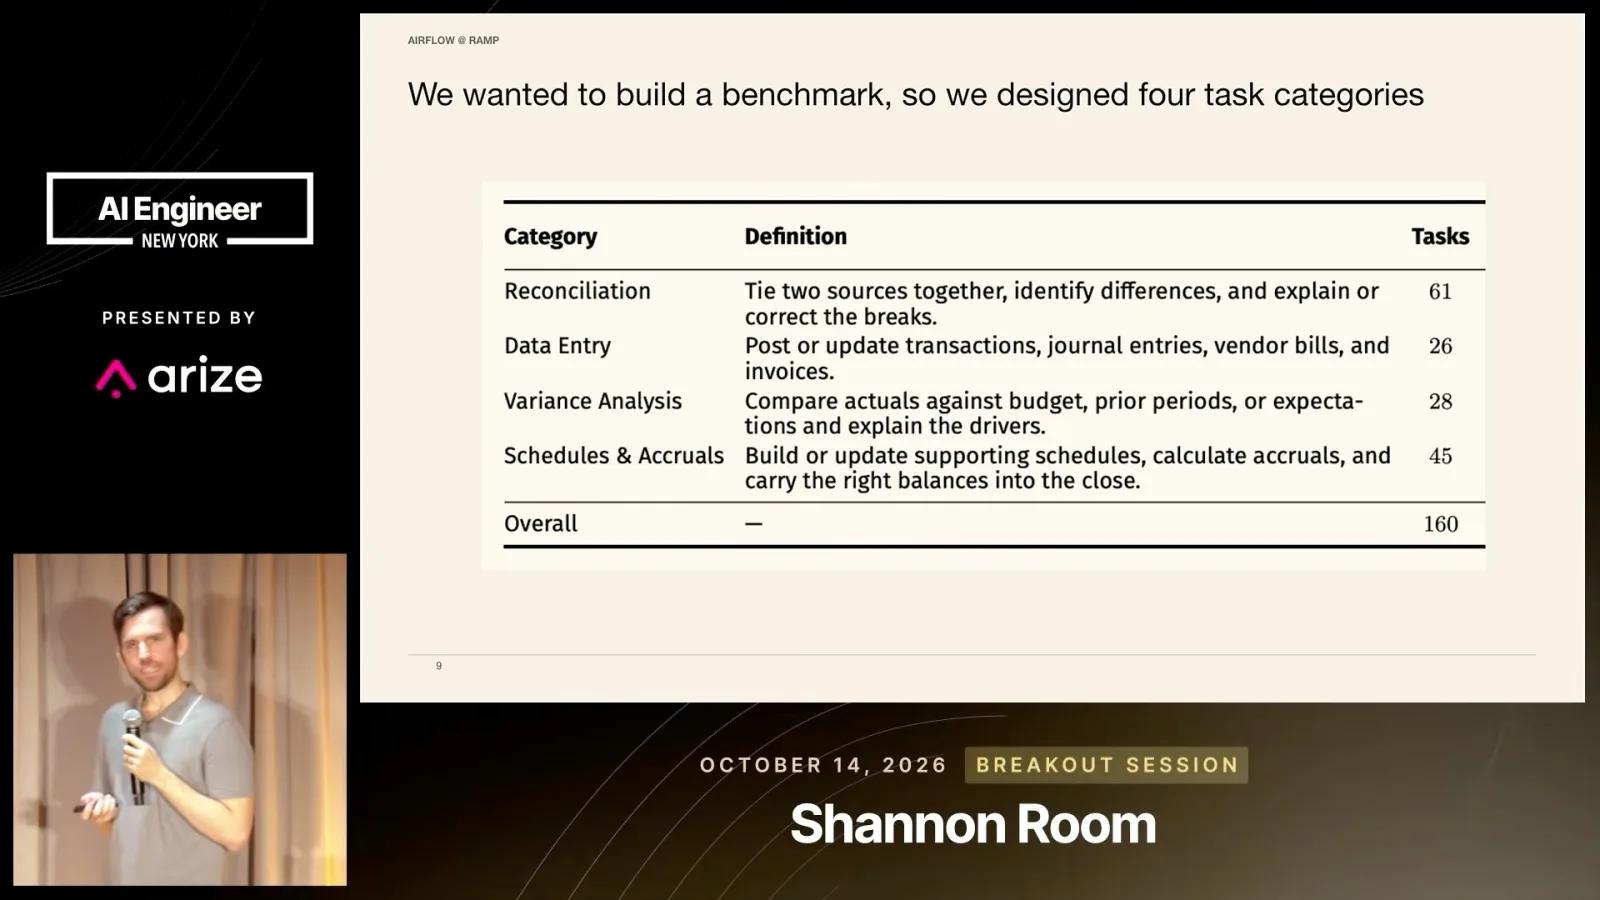
Stevens 从从业者的工作流程出发,定义成功的标准。对账和另外三类任务构成了评测集。
Ryan Stevens 领导 Ramp 的应用科学团队。他介绍了 AI 记账智能体 Stack,重点讨论如何评估智能体能否完成真实工作,而不是只看单个组件是否表现出色。
Stevens 说,构建智能体之前,先把工作拆成任务,并与实际从业者共同定义成功标准。团队与记账员和会计事务所交流,了解完整工作流程。
在对账中,会计人员比较企业资源计划系统中的总账与存有账单的系统,找出并解决差异。评测还覆盖数据录入、差异分析、明细表和应计项目。
构建可重放的企业并评分
模拟记录提供一致的离线测试环境。部分准确率和 pass@k 衡量不同的表现。
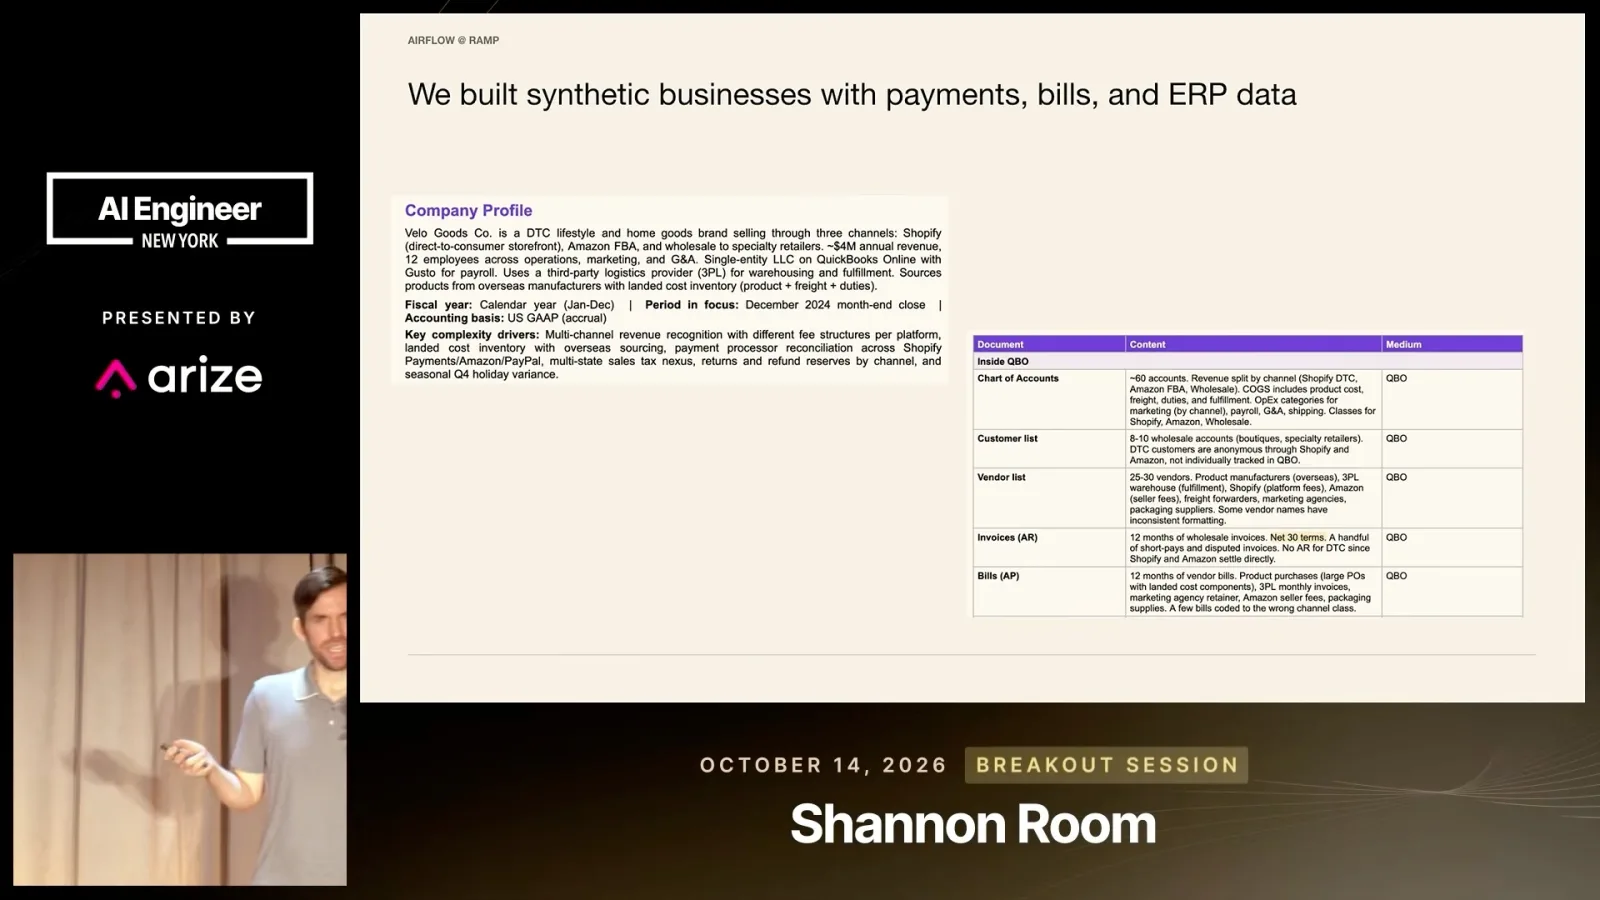
当用户不足以提供有代表性的数据时,Stevens 建议使用模拟。Ramp 与 Mercor 合作,创建模拟企业及其会计环境,供离线评测使用。
其中一家模拟企业通过多个渠道销售。团队为其创建会计系统、客户和供应商名单、账单及其他文件,使智能体能从一致的初始状态执行真实任务。
Stevens 将这一过程称为回测:针对相同任务和数据重复运行智能体,再比较不同时期的结果。与具有版本历史的代码仓库不同,生产系统需要专门保存快照,才能重放过去的状态。
每项测试结合一个任务和一个模拟企业环境,团队将后者称为一个 world。智能体运行后,团队通常依据每项任务的 10 至 20 条标准给最终结果评分。
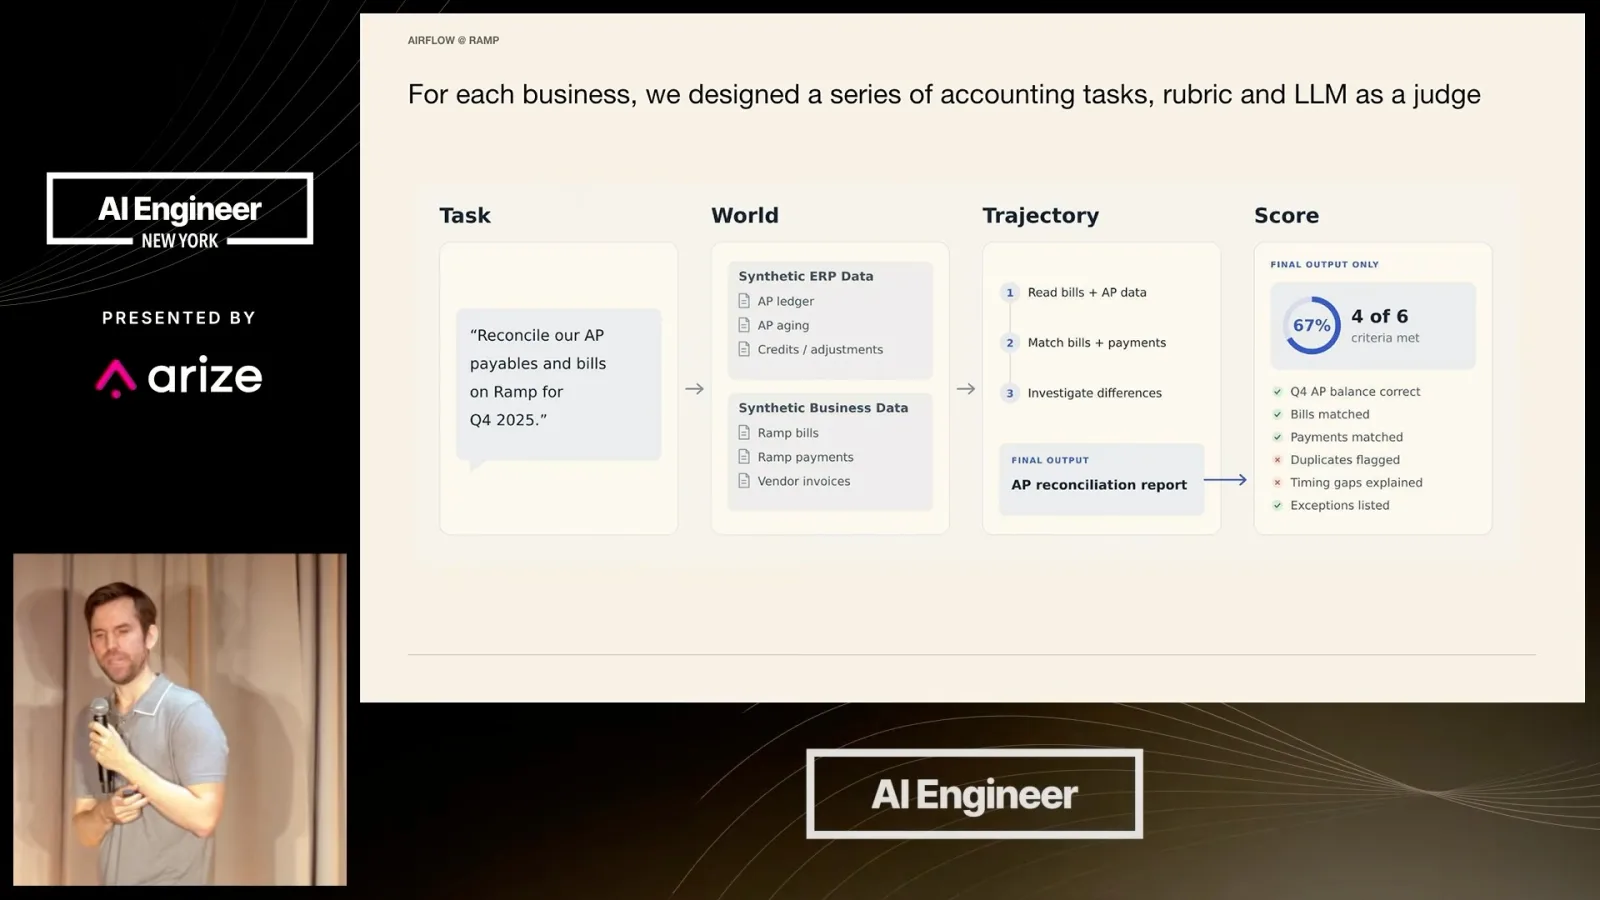
起初,Ramp 不评估智能体是否选对工具或采取最高效的路径。Stevens 说,团队首先关注正确性、成本和速度;其他应用则可能需要评估中间步骤。
他说,上线前建设评测体系花了四到六个月。在前沿模型提供商尚未充分优化的领域,构建有用的测试环境本身就可能需要大量工作。
Stevens 比较了部分得分的准确率与 pass@k。六条标准中有四条正确,示例准确率就是 67%;pass@k 则看 k 次尝试中是否有任何一次满足全部标准。
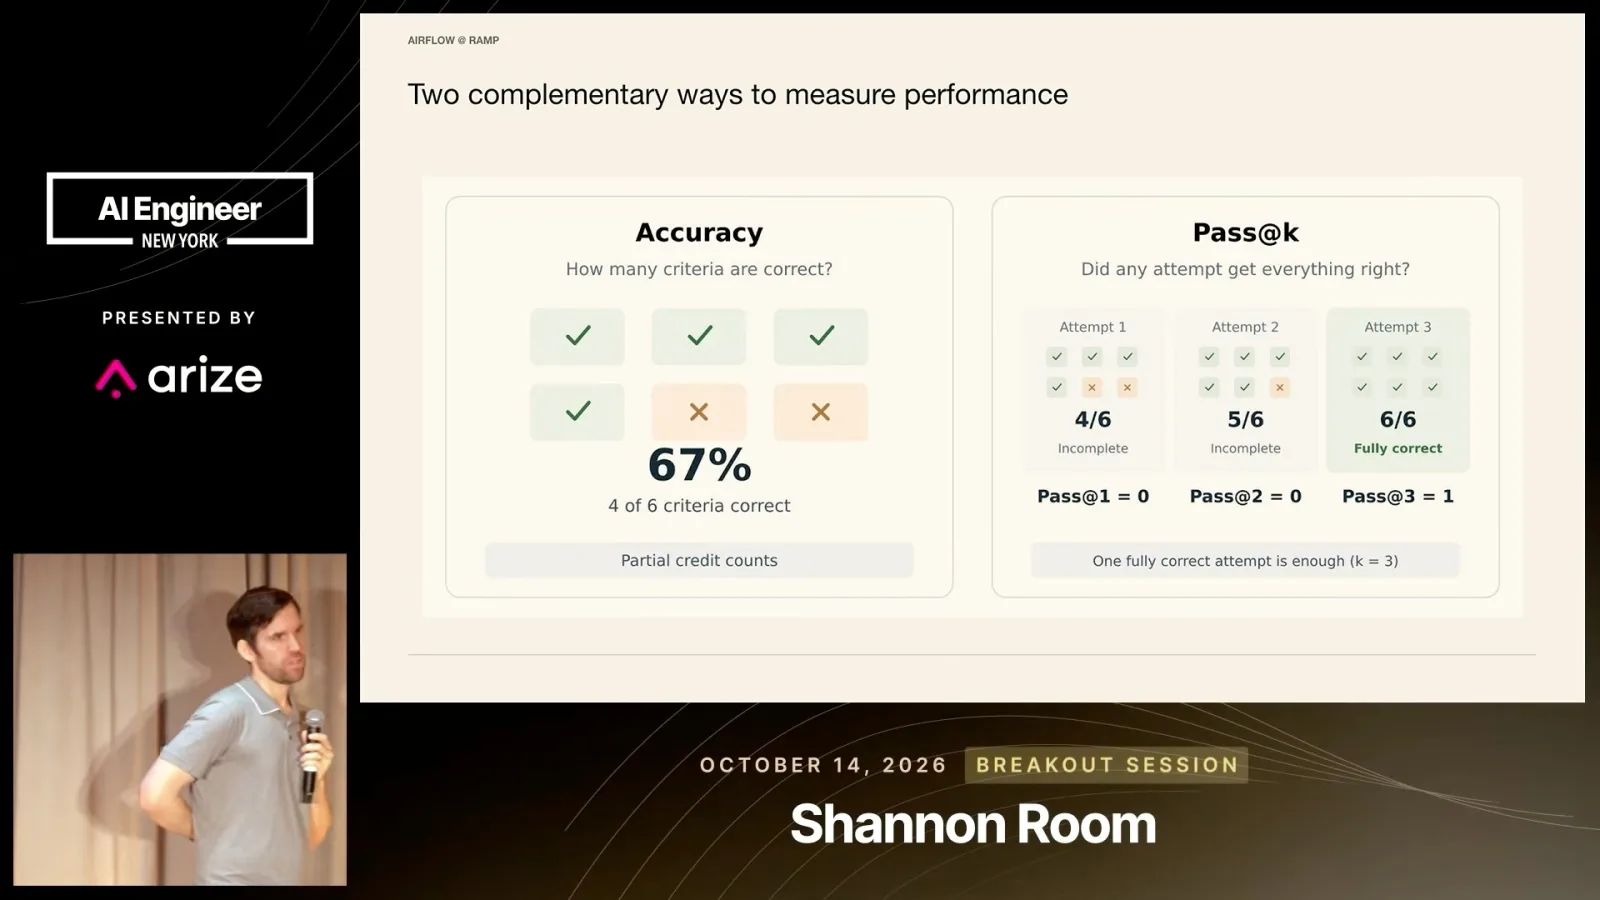
在他展示的三次尝试中,前两次不完整,第三次满足全部六条标准。因此 pass@1 和 pass@2 为零,pass@3 为一。他说,会计错误可能损害信任,所以全对或全错的指标很重要。
利用失败改进智能体
团队比较模型、归类失败原因,并测试哪些技能或记忆有助于改善结果。一些自动调优尝试没有奏效。
评测集帮助团队比较模型。Stevens 展示的结果中,部分准确率很高,但 pass@1 低得多,说明外围智能体系统仍有改进空间。
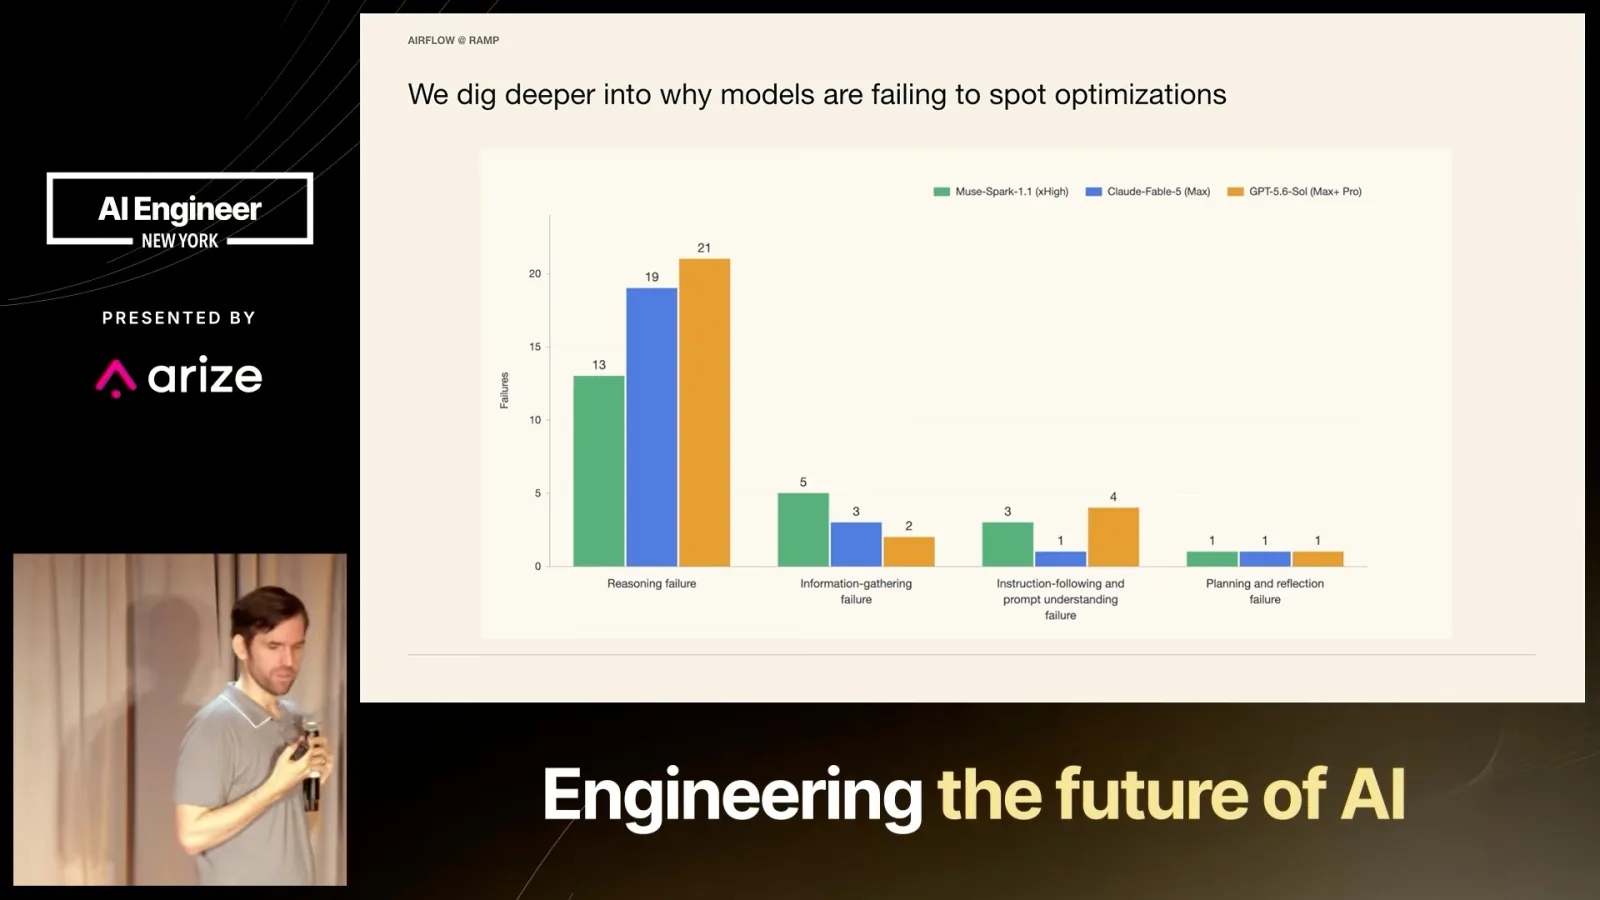
团队将失败分为推理、信息收集、遵循指令和其他问题。Stevens 说,在会计任务中推理失败占比最大:智能体常常掌握了信息,却没有正确使用。
他也强调失败的实验。在这个场景下,团队的自动提示词或技能调优没有奏效;Stevens 提醒,这可能只适用于他们的智能体,应谨慎看待自动研究的效果。
一项有效实验是技能消融:比较保留和移除单项技能时的表现,类似机器学习中测试特征贡献。结果有助于找出可以删除或压缩的技能,并减少上下文占用。
Stevens 提醒,自己可能把展示的消融图表中的正负号解释反了。他的实际结论是应测量每项技能的效果,不要假定增加指令总有帮助。
团队还使用所谓的跨期推进环境测试记忆:智能体先在一个期间完成任务并写下压缩记忆,再为同一企业处理下一期间的类似任务。
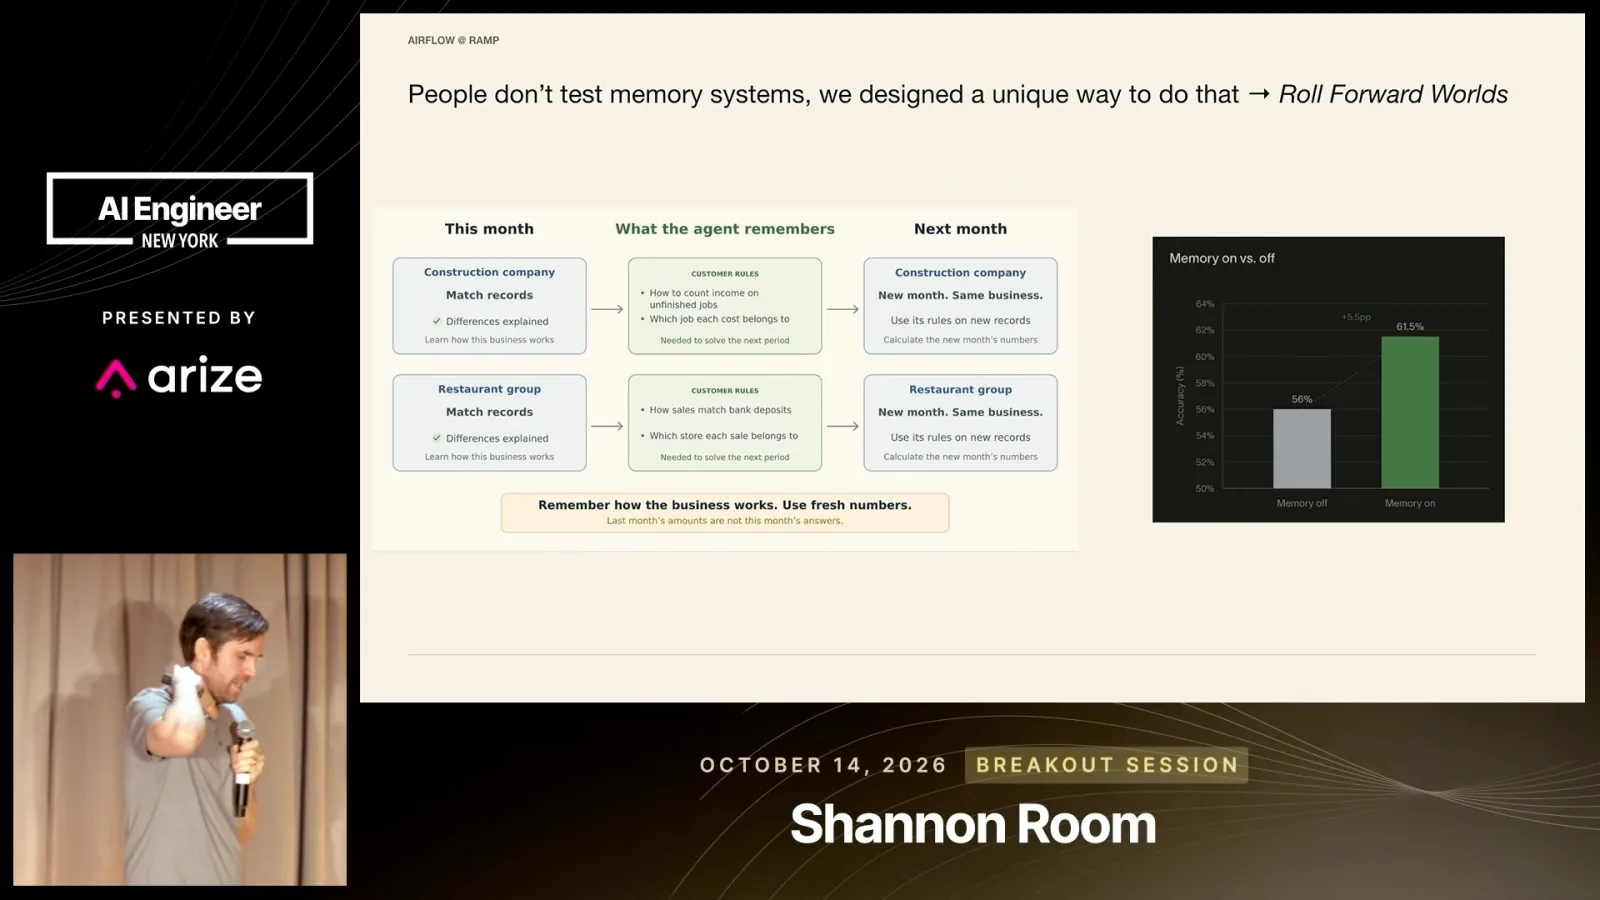
对账时,记忆可以保留特定客户的隐含规则,而数字记录会变化。下一次运行可以直接获取记忆或搜索记忆。Stevens 说,用于写入记忆的提示词对记忆是否有用影响很大。
在展示的评测中,记忆让准确率从 56% 升至 61.5%;Stevens 称记忆调优是团队发现的较大提升之一。目标是记住企业如何运作,而不是把上个月的数据直接当成答案。
上线后持续检查
定期回归评测对带标签案例进行跨时间比较,并提示需要调查的潜在失败。
最后,Ramp 会定期运行回归评测。Stevens 对把结果不确定的智能体评测用作严格的持续集成门槛持谨慎态度;团队的内部平台会定时运行带标签的案例,并与以往表现比较。
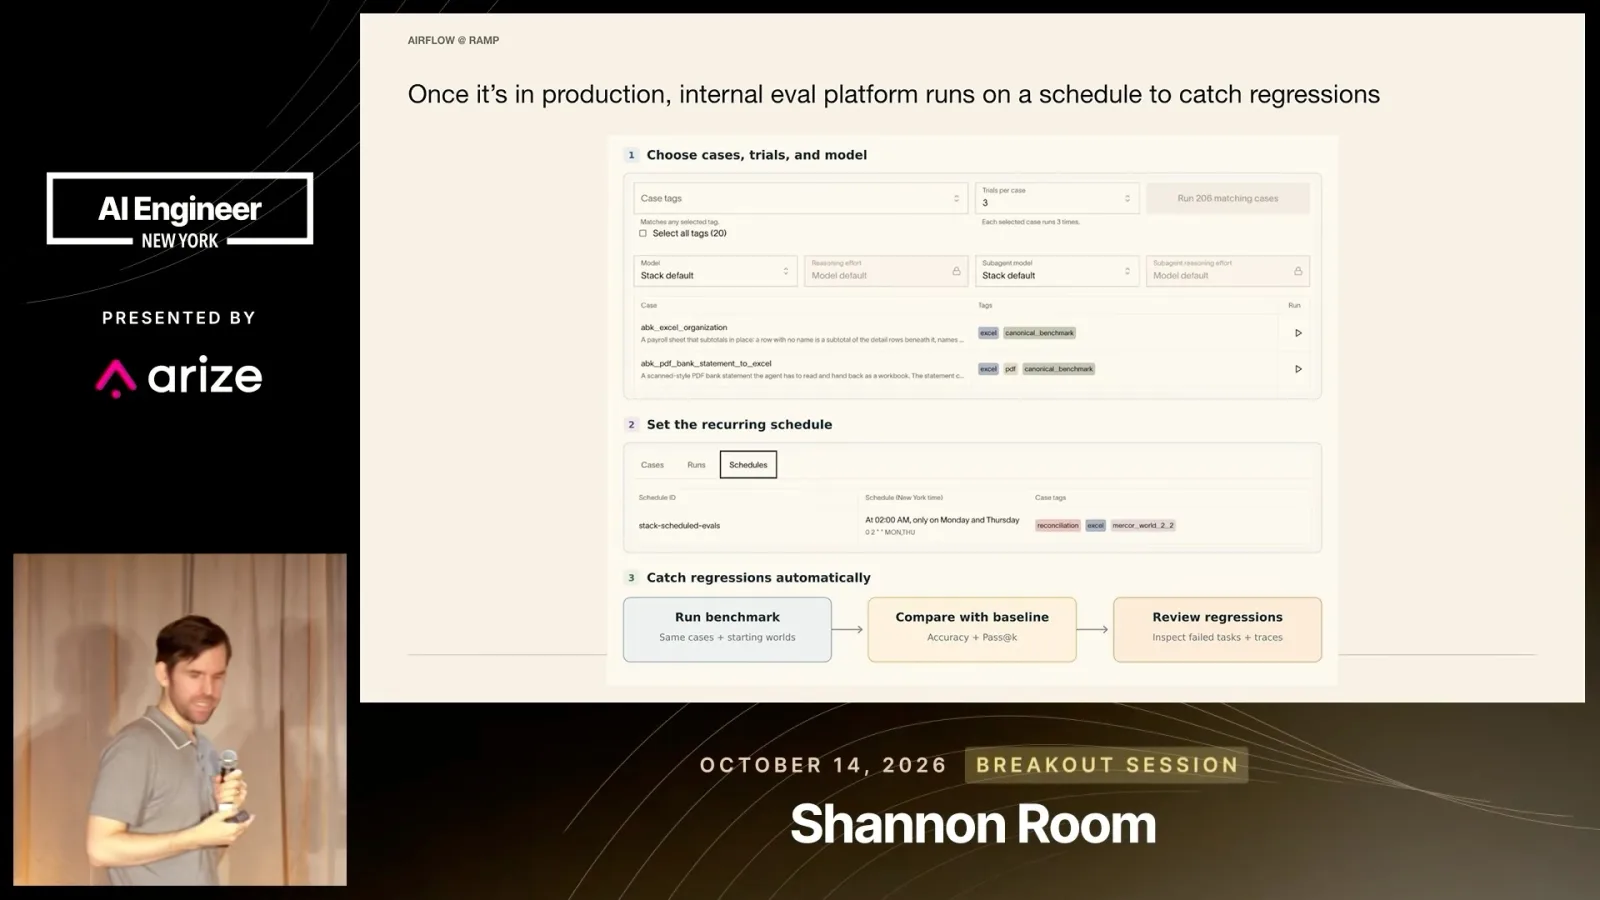
后台智能体检查失败和可能的性能退化,再发送消息供人员调查。Stevens 最后建议构建真实环境、明确任务定义,并让评测流程在上线后持续运行。
同频道的其他文章
 19:41EN → 简体中文
 AI Engineer· 2026年11月9日高可靠自动化的第一步:把难处理的案例分流出去Matthew Jewkes · Standard CyberneticsMatthew Jewkes 介绍如何在生物医药文档索引流程中区分关键错误、模糊判断和异常情况。
 22:01EN → 简体中文AI Engineer· 2026年11月9日Zach Lloyd:让软件工厂可以衡量和修改Zach Lloyd · WarpWarp CEO 建议记录智能体运行、评估失败原因,并用真实任务测试工作流的改动。
 27:35EN → 简体中文AI Engineer· 2026年11月9日Uber 为加快 AI 时代的代码合并,放弃主干始终通过测试Preetam Dwivedi, Manjari Akella · Uber合并队列放宽部分冲突限制,合并后再验证组合状态,并保留已验证的可用版本。
 15:25EN → 简体中文AI Engineer· 2026年11月9日Hassan 与 Omar El Mghari:AI 财务预测为何会“结果对了,理由错了”Hassan El Mghari, Omar El Mghari · Together AI一个 Costco 会员费模型通过了基础检查,结果也接近实际数据,但审计发现了相互抵消的错误假设。
 14:38EN → 简体中文AI Engineer· 2026年11月9日Jemima Abu:从一开始就给编程代理无障碍规则Jemima Abu · CAIS一位产品工程师介绍如何利用语义化 HTML、可复用组件和明确的代理技能,帮助团队构建更易用的界面。
 21:12EN → 简体中文AI Engineer· 2026年11月9日Tom Moor:给编程代理补上代码看不到的产品背景Tom Moor · LinearLinear 的工作流将客户请求、历史决策、审查记录和人工反馈贯穿于接收、实现与审查。