30 秒看懂
Samaya AI 的 Ashwin Paranjape 认为,与预测股价相比,预测财报更适合作为可解释的金融智能体测试。团队报告,在 450 多次财报发布中,借助研究工具链和时点限定数据的领先模型,在部分指标上超过了经过偏差校正的分析师共识基线。研究还发现,撤去近期数据后结果差异明显。实验评估的是公司报告的财务指标,而非交易收益,也不能证明模型能可靠选股。
- 1财报是一项结果可观察的预测任务报告的营收、利润率和每股收益可以与预测及分析师共识进行比较。
- 2工具链将数据限制在预测日期之前时点关卡覆盖公司文件和数据;带时间戳的新闻取代不受限制的网页搜索。
- 3部分模型在部分指标上超过校正共识Samaya 报告了 450 多次财报发布的结果,但任务不衡量交易利润。
- 4过时信息显著削弱表现在一项比较中,使用财报前约 11 周的数据使表现降低约 12 至 15 个点。
- 5最强模型对共识数据的依赖较低在报告的实验中,GPT-6 Astra 是否获得分析师共识,结果没有显著差异。
要点建议
- 财报提供可观察的结果和分析师估计,使预测比噪声较大的股价更容易评分。
- 时点数据关卡旨在阻止智能体看到预测日期之后发布的信息。
- Samaya 在多个指标上同时与原始共识和偏差校正共识比较。
- 领先模型在部分测试任务上表现更好,结果因指标和模型而异。
- 报告的实验显示,近期数据和专家指导能够改善预测结果。
按章节阅读整理后的全文
为什么预测财报而不是股价?
Paranjape 介绍归因股价变动的困难。财报则提供量化结果和专家基线。
Ashwin Paranjape 介绍自己在 Samaya AI 的工作,从检索和长上下文系统,到金融智能体工具链和基准测试。他问,能够完成越来越复杂技术任务的智能体,是否也能改进金融预测。
一位有投资经验的同事建议不要从股价预测开始:价格噪声很大,驱动因素难以分离,而表面正确的预测也可能建立在错误推理上。
团队转而选择季度财报。公司会公布营收、利润率、营业收入和每股收益;分析师估计汇总成共识,实际结果高于或低于共识,分别被称为超预期或不及预期。
Paranjape 认为这种任务有三个评测优势:量化结果、人类专家基线,以及可能帮助解释意外结果的管理层说明。他问智能体能否在发布前作出有用预测。
时点限定的研究环境
Samaya 调整生产环境中的工具链,阻止访问未来数据。智能体在财报发布前研究并预测。
团队围绕研究工具链构建环境。智能体获得任务和历史信息,研究公司并提交预测,之后再与公布的实际结果比较。
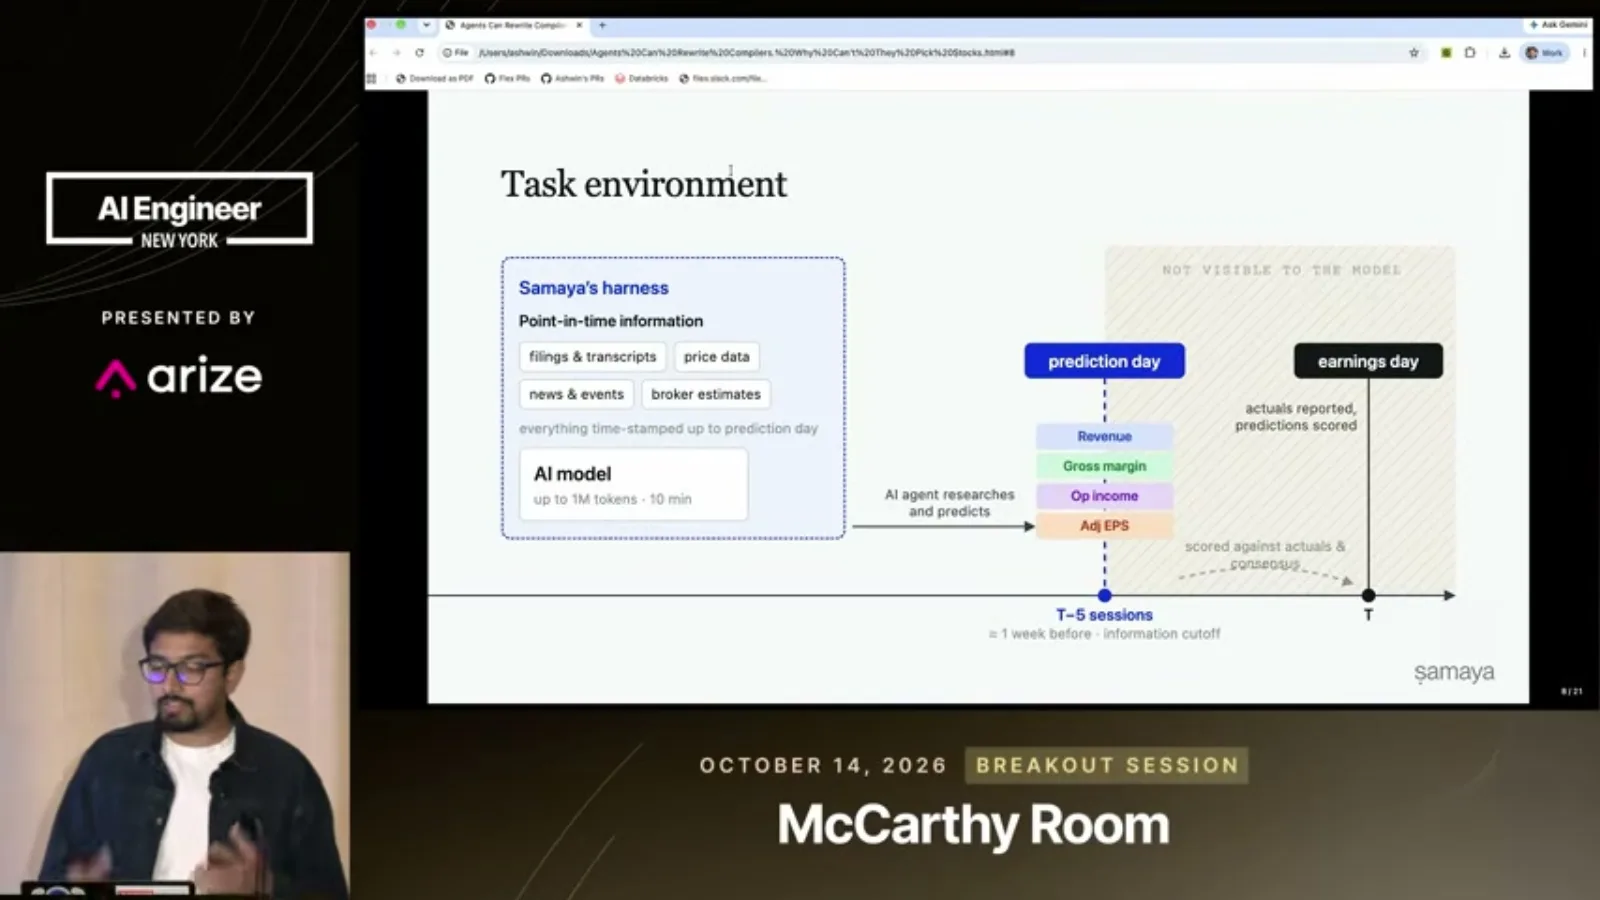
时点数据关卡将检索信息限制在选定预测日之前,例如财报发布前五个交易日。Samaya 修改了文件检索和结构化数据工具,使其支持这一截止时间。
不受限制的网页搜索很难回溯约束,因此团队改用更多带时间戳的新闻流。工具链还提供专家指导,帮助智能体利用上下文并处理预测任务。
结果与案例
团队使用预测误差、方向和相关性,把七个模型与原始及校正共识比较,并用案例展示成功和失误。
Paranjape 报告了 450 多次财报发布和七个前沿模型的结果。研究从最新受测模型的知识截止日期之后开始,试图降低模型训练数据已包含最终结果的风险。
第一个指标是按各公司历史波动率标准化的预测误差。比较对象包括原始分析师共识,以及为考虑实际结果经常高于预期而设置的偏差校正共识。
在营收比较中,Paranjape 说 GPT-6 Astra 的表现显著超过偏差校正基线。营收、毛利率、营业收入和调整后每股收益的结果各不相同;并非每项差异都具有统计显著性。
团队还衡量命中率,即预测是否正确判断实际结果高于还是低于共识。对低于共识的结果,团队使用公司此前八个季度多数结果构成的基线进行比较。
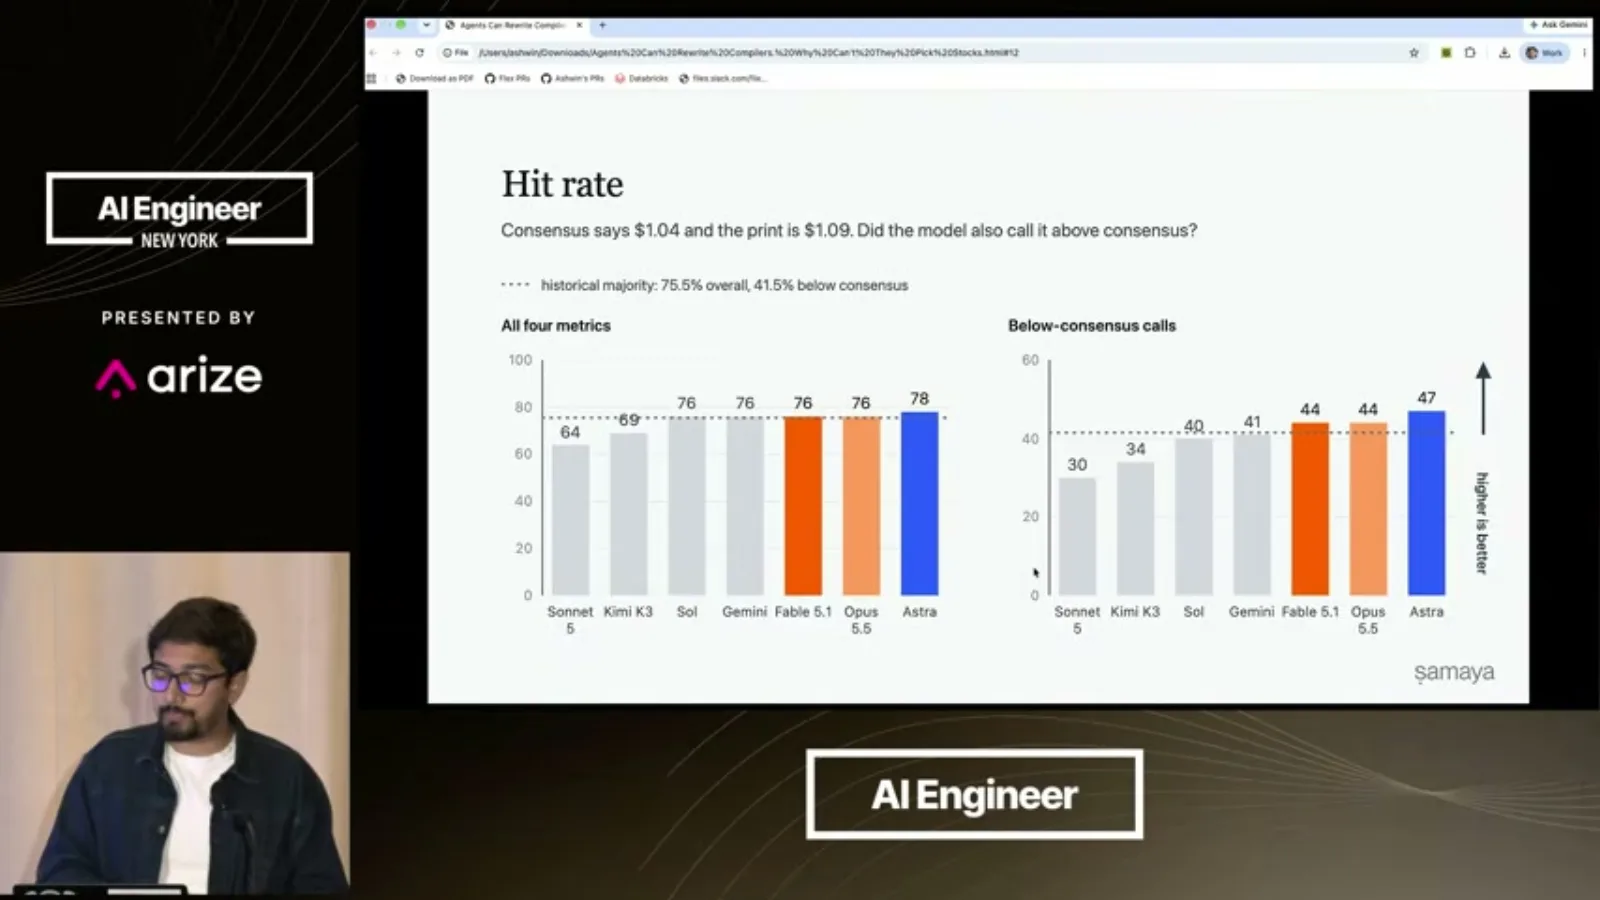
第三个指标是惊喜相关性,衡量预测和实际惊喜在方向与幅度上的一致性。Paranjape 说,领先模型在该指标上超过基线,但模型之间的差异没有统计显著性。
作为预测成功的例子,他介绍一家向数据中心供货的半导体公司。智能体发现一家较小供应商发布的及时信息,将其纳入损益预测,使预测从共识向上调整,接近最终结果。
一个失误案例涉及 Ross Stores。智能体发现同行获得关税退款的信息,却没有将其纳入毛利率预测;预测仍接近共识,而实际公布结果高得多。
Paranjape 说,当实际偏离共识的幅度较大时,模型那些显著高于或低于共识的预测尤其值得研究。这些例子展示了可能的推理模式,但少量案例不能证明某种交易策略有效。
数据新鲜度与指导
实验比较近期与过时数据、专家指导和共识数据访问,并介绍后续研究方向。
团队随后测试数据新鲜度。即使预训练可能包含早期文件,仅依靠模型自身参数知识的模型在这项任务上表现仍然较差。
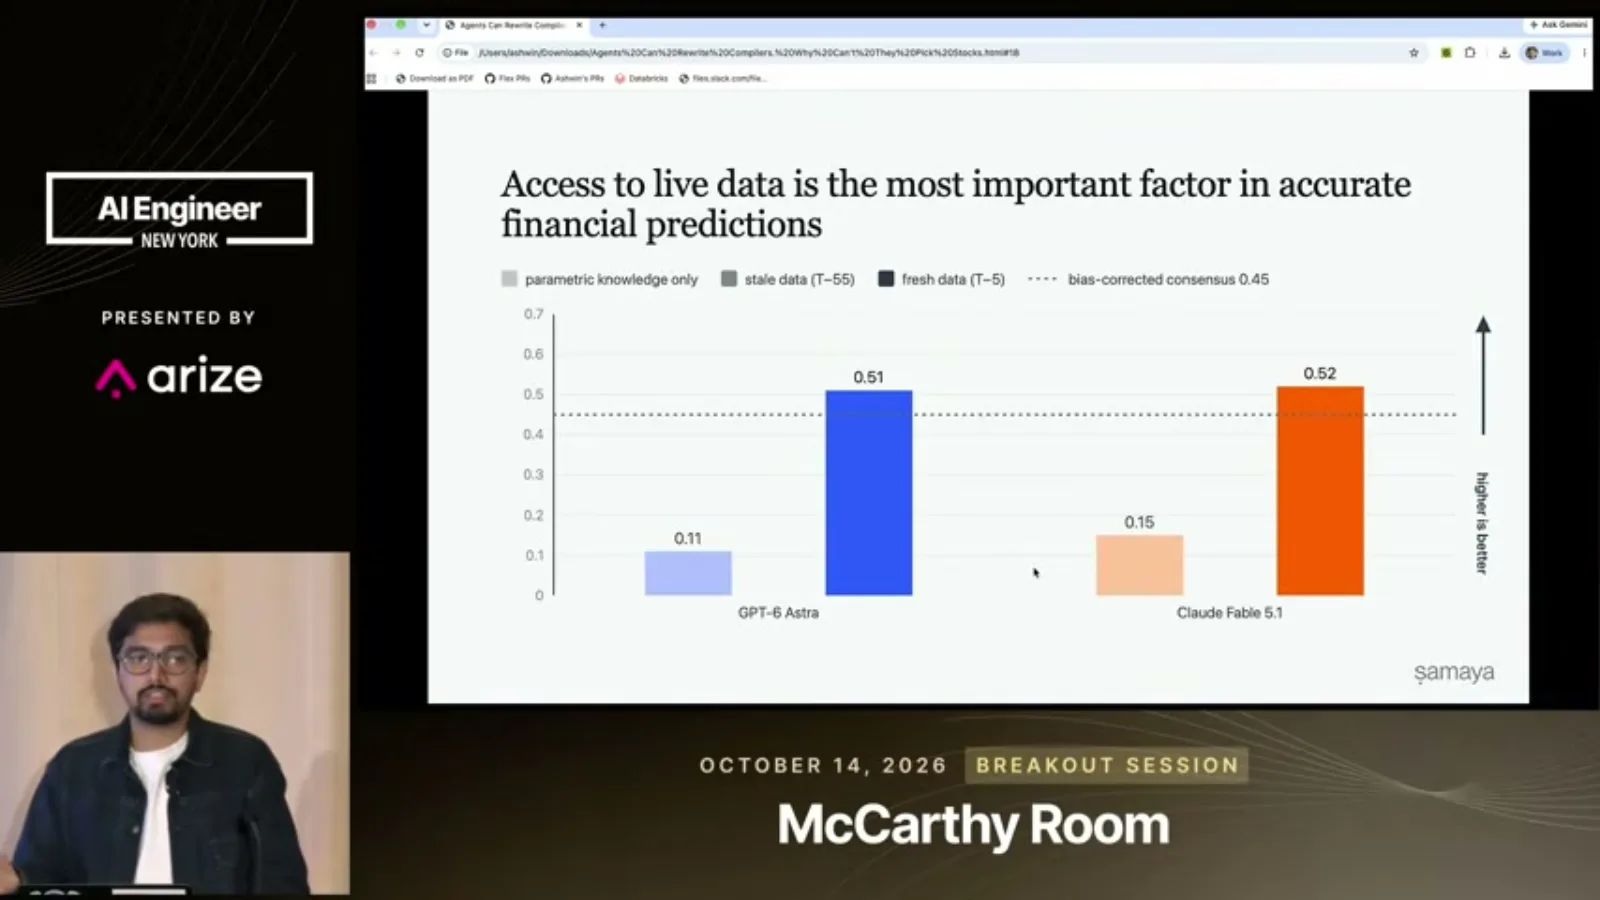
在他描述的比较中,使用财报前约 11 周的数据,而不是最新可用信息,会使表现降低约 12 至 15 个点。他将这一差距与两代模型之间的表现差距作比较。
专家指导使智能体在研究中花费更多时间和 token。Paranjape 报告说,对 GPT-6 Astra 而言,有指导的设置带来了具有统计显著性的预测误差改善。
团队还撤去了分析师共识数据,包括从检索来源中删去相关表述。最强模型有无共识数据的结果没有显著差异;Paranjape 推测它可能从其他信息中重建部分共识观点。
Samaya 正与客户测试预测能力,并研究内部数据是否有帮助。后续方向包括分析模型推理、结合人类分析,以及让模型从过去的错误中学习。
Paranjape 推荐读者查看公司公开研究和 FrontierFinance 基准测试。报告中的研究预测的是公司财报指标,并未证明智能体能可靠选股或获得风险调整后的交易收益。
同频道的其他文章
 19:41EN → 简体中文
 AI Engineer· 2026年11月9日高可靠自动化的第一步:把难处理的案例分流出去Matthew Jewkes · Standard CyberneticsMatthew Jewkes 介绍如何在生物医药文档索引流程中区分关键错误、模糊判断和异常情况。
 22:01EN → 简体中文AI Engineer· 2026年11月9日Zach Lloyd:让软件工厂可以衡量和修改Zach Lloyd · WarpWarp CEO 建议记录智能体运行、评估失败原因,并用真实任务测试工作流的改动。
 27:35EN → 简体中文AI Engineer· 2026年11月9日Uber 为加快 AI 时代的代码合并,放弃主干始终通过测试Preetam Dwivedi, Manjari Akella · Uber合并队列放宽部分冲突限制,合并后再验证组合状态,并保留已验证的可用版本。
 15:25EN → 简体中文AI Engineer· 2026年11月9日Hassan 与 Omar El Mghari:AI 财务预测为何会“结果对了,理由错了”Hassan El Mghari, Omar El Mghari · Together AI一个 Costco 会员费模型通过了基础检查,结果也接近实际数据,但审计发现了相互抵消的错误假设。
 14:38EN → 简体中文AI Engineer· 2026年11月9日Jemima Abu:从一开始就给编程代理无障碍规则Jemima Abu · CAIS一位产品工程师介绍如何利用语义化 HTML、可复用组件和明确的代理技能,帮助团队构建更易用的界面。
 21:12EN → 简体中文AI Engineer· 2026年11月9日Tom Moor:给编程代理补上代码看不到的产品背景Tom Moor · LinearLinear 的工作流将客户请求、历史决策、审查记录和人工反馈贯穿于接收、实现与审查。