30 秒看懂
讲者讲解文档检索的召回与排序、倒排索引和向量检索,再分析 NCI 如何用序列模型从查询生成文档 ID。他比较 DSI、解释查询生成和解码器改进,并讨论论文的数据泄露更正、实验范围、吞吐量以及增量更新问题。
- 1先召回,再排序检索需要在大规模语料中高效找出候选;遗漏的相关文档无法在后续排序中恢复。
- 2生成文档 IDNCI 将文档知识放进模型,通过查询生成相关的层次化 ID。
- 3生成训练查询论文用 DocT5Query 及文档片段生成多个查询,帮助模型学习语料。
- 4系统吞吐量讲者指出实验中的 GPU 查询吞吐量与大规模搜索部署存在差距。
- 5数据泄露更正作者发现不同阶段使用不一致的数据划分并修正结果,讲者强调透明更正的重要性。
要点建议
- 检索阶段的召回决定排序阶段能看到哪些候选文档。
- NCI 将查询直接映射为层次化文档 ID,并通过生成查询学习语料内容。
- 层次聚类、解码器与一致性训练各自承担不同作用。
- 论文曾因数据划分不一致导致泄露并更正结果,引用数字时应核对版本。
- 问答数据集上的表现不等于对所有检索场景有效。
- 吞吐量、语料规模和新增文档的维护是实际部署中的关键限制。
按章节阅读整理后的全文
论文背景与结果更正
介绍 NCI、数据泄露问题,以及为什么检索方向值得研究。
讲者介绍 Neural Corpus Indexer(NCI),借这篇论文解释文档检索和神经网络方法。他一开始就提醒:作者后来发现训练与测试数据划分不一致导致数据泄露,并修正了先前偏高的结果。
讲者认为,异常好的实验结果应反复检查,数据泄露是新手和经验丰富的研究者都可能犯的错误。选择这篇论文的主要原因是检索方向本身值得学习,而非争议本身。
文档检索的任务是给定查询,从大量文档中找出相关内容。NCI 将查询输入序列到序列模型,直接生成相关文档的 ID;论文还设计文档 ID、查询生成和训练方法。
论文希望用端到端模型把索引与检索结合,并在所选数据集上提高召回。讲者提醒,应同时审视实验条件、后续更正以及系统成本,不能仅凭摘要中的提升数字判断。
检索、排序与索引
比较倒排索引、双塔向量检索和端到端方案的优缺点。
常见搜索系统分为检索和排序:先从海量文档中召回候选,再用更精细但昂贵的模型对候选逐一评分。第一阶段漏掉的相关文档,后续排序无法补回来,因此召回率很重要。
检索阶段还必须足够快。讲者指出,网页规模的文档数量巨大,从中选出几百或上千个候选本身就有成本;这是评价任何新检索方法时不能忽略的系统约束。
基于词项的倒排索引记录每个词出现在哪些文档里。讲者用《动手学深度学习》的搜索索引说明:搜索词对应一组文档 ID,再把这些 ID 映射成标题和摘要返回。
倒排索引效率高,但简单的词匹配难以找到没有出现查询词却语义相关的文档。例如,搜索 Transformer 时,一篇只写 BERT 的相关页面可能被漏掉。
另一类方法是双塔模型:查询和文档分别进入编码网络,得到同一向量空间中的表示。训练时让相关的查询—文档更相似,不相关的更远;对比学习是常见选择。
文档向量可提前计算,查询时寻找近邻。由于全量扫描大量向量成本高,系统通常使用近似最近邻算法,在效率和检索精度之间权衡。
向量语义检索也有局限:搜索某个精确产品型号时,语义相近的旧型号不一定是用户想要的;复杂问答关系也未必能由简单向量相似度充分表达。
论文讨论了已有的端到端方法,包括 DSI 和 SEAL。讲者特别提醒,后面比较 NCI 与 DSI 时,需要区分共同思路和真正新增的组件。
讲者对论文中检索框架能被“根本改变”的表述保持谨慎:新方法仍处早期,延迟、吞吐量与规模问题尚未解决,因此实验优势不等于已能替代传统搜索系统。
NCI 的文档 ID 与查询
讲解层次聚类、ID 生成和文档到查询的数据构造。
NCI 推理时输入查询并输出文档 ID,不把所有文档逐次输入模型。为了让模型知道语料内容,训练时必须把文档信息编码进模型,并学习查询到 ID 的映射。
可用数据包括真实的查询—相关文档 ID 对,以及拥有完整正文和 ID 的文档。论文把文档转成多个类似查询的训练输入,使模型同时学习文档内容与 ID 的关系。
讲者将设计拆成三个问题:如何生成具有语义结构的文档 ID;如何从文档生成与真实查询相近的输入;以及如何设计编码器、解码器和损失函数。
文档 ID 使用层次化 K-means。先将文档分成若干类,为每个类分配前缀;若一个类仍太大,就继续分成子类,直到叶节点足够小,再为文档分配类内标识。
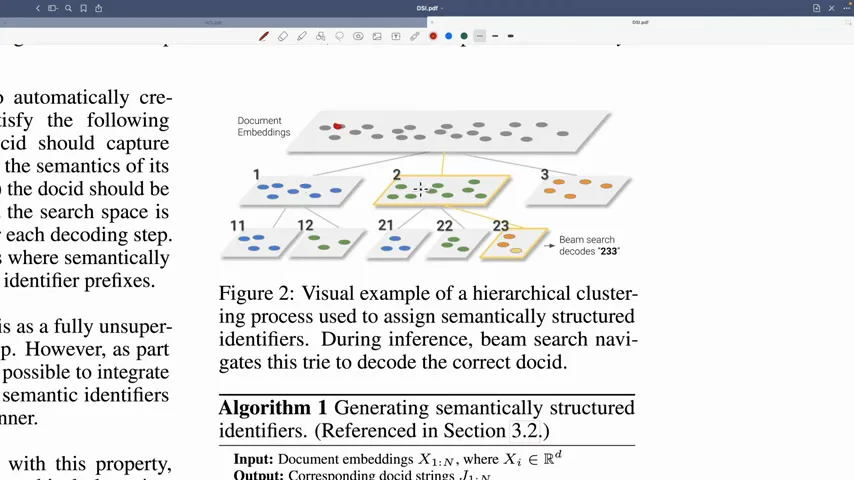
同一语义簇中的文档共享前缀,前缀越相似,文档可能越接近。讲者将其类比为大规模类别的层次分类:先判断大类,再逐层确定小类和具体文档。
序列到序列模型逐项生成 ID:先预测大类,再根据前缀预测下一层,直到完整 ID。虽然输出形式是序列,讲者认为它本质上也可理解为一种层次化分类。
生成查询的一种方法是 DocT5Query:用预训练的编码器—解码器模型把文档映射成可能的查询,并为每篇文档采样多个结果,让模型学习不同表述与同一文档的关系。
论文使用随机采样而非只保留 beam search 的高概率结果,以增加查询多样性。另一种较简单的方法从文档开头及随机位置截取文本片段,作为额外训练查询。
解码器与训练
解释序列结构、输出投影、一致性正则和受约束的搜索。
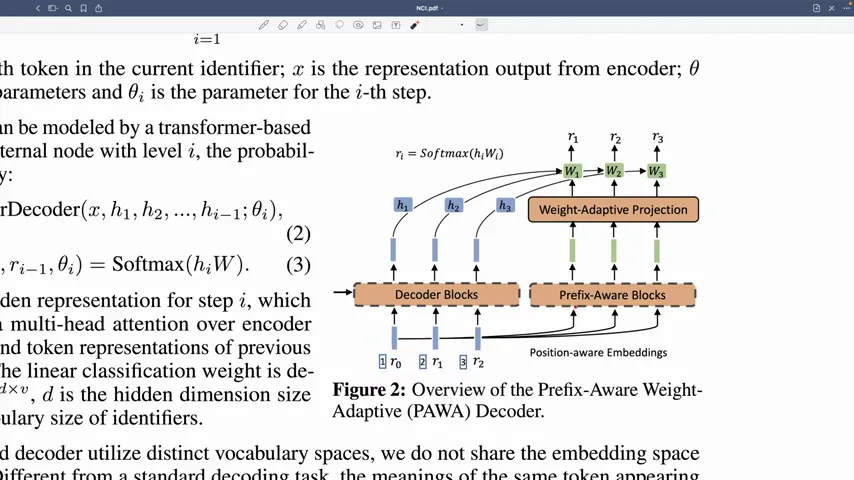
NCI 还修改解码器以强调文档 ID 的序列结构。ID 各位置对应层次树的不同深度,顺序不能随意交换;除了通常的位置表示,作者还让生成过程利用位置与先前预测的信息。
具体来说,输出投影不仅与当前 ID 位置有关,还通过额外解码器使用先前生成的前缀。讲者把它解释为对层次位置和历史信息的进一步建模。
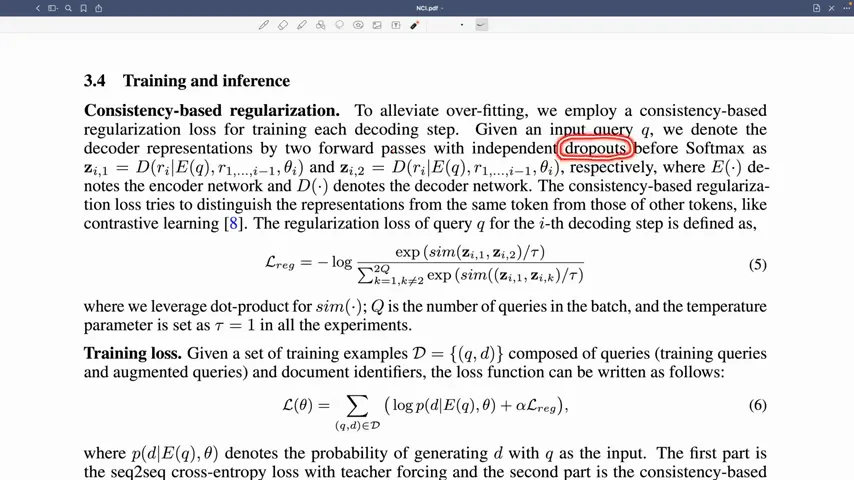
一致性正则项让同一查询在 dropout 扰动下的两次表示相近,并与同批次其他查询区分。训练损失将序列生成的交叉熵与这一对比式正则项结合。
预测时使用受约束的 beam search:生成的每个前缀必须通向有效文档 ID,避免把计算花在无效标识上。整个模型因此结合层次 ID、生成查询、解码器调整和一致性训练。
与 DSI 比较
区分两篇工作共享的框架与 NCI 新增的组件。
讲者随后比较 DSI:DSI 公开得更早,也用 T5 式序列到序列模型将查询映射成文档 ID,并研究了包括层次聚类在内的 ID 设计。他认为对共同部分应清楚标注前人工作。
在他的概括中,NCI 相对 DSI 增加了查询生成、解码器修改和一致性损失等部分。两篇论文的细节仍应以各自论文及版本为准,不能把共同框架简单算作某一篇独有。
实验与部署限制
讨论问答数据集、消融、吞吐、扩展和动态更新。
实验使用两个基于维基百科的问答检索数据集。查询是自然语言问题,系统返回可能包含答案的文档;讲者指出,这类复杂问答并不能代表所有文档检索场景。
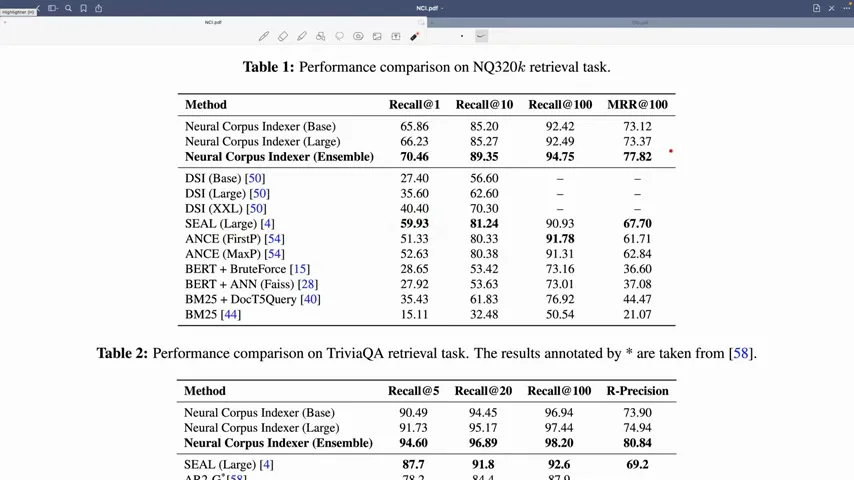
指标包括 Recall@N 和 MRR:前者看相关文档是否出现在返回的 N 个结果里,后者考虑正确结果的排名。比较效果时,也要确认数据集和论文版本,因为作者修正过泄露问题。
讲者介绍实现细节:使用 BERT 表示做聚类,设置聚类分支与阈值,并用查询生成模型为文档产生多个查询。论文提供代码,有助于复核实现和复现。
论文表格中 NCI 在所选指标上优于所比较的方法,但讲者一再强调版本差异。早期受污染的高分不能与修正后的结果混为一谈,也不能直接推广到所有搜索任务。
消融实验逐个移除组件,观察召回变化。讲者说,生成查询是贡献较大的部分:它帮助模型把文档内容转化成多种查询形式,而单个真实查询未必能覆盖文档语义。
解码器改进也有收益;带语义的层次 ID 相比随机 ID 的提升在该实验中没有讲者原先想象得那么大。这个对比也说明模型能记住一定量的任意标识。
讲者称一致性正则与合法 ID 约束的消融效果相对较小;这些结论只针对论文报告的设置。不同模型、数据和检索规模下,组件的重要性仍需重新评估。
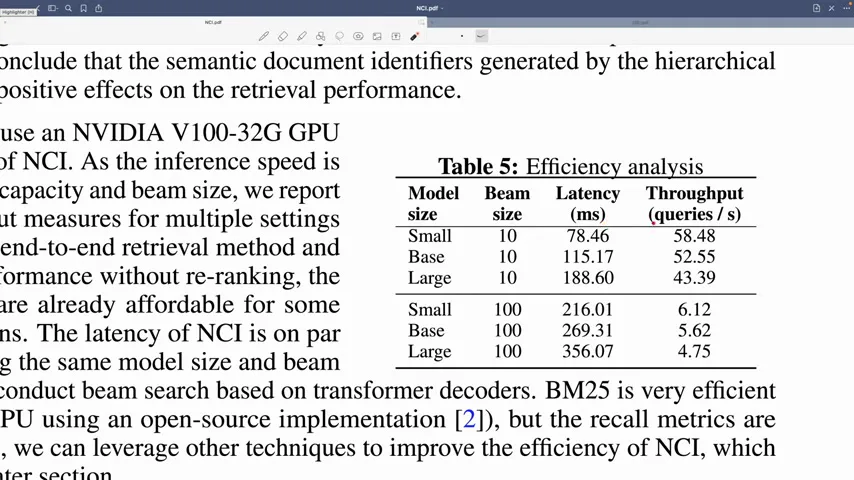
系统性能表给出 GPU 推理延迟和吞吐量。讲者举出 base 模型、beam size 为 10 时约 115 毫秒的延迟,并指出搜索系统还需要为排序、网络和渲染留出时间。
他更担心吞吐量:论文示例中一张 V100 每秒只能处理几十个查询。对大型搜索引擎来说,这可能需要大量昂贵硬件,因此离实际大规模部署还有距离。
语料扩展也是挑战:论文实验的文档规模远小于大型网页索引,要把更多内容装进模型可能需要更大的容量和更多训练。讲者强调,这是论文自身也列出的局限。
新增文档可能改变层次聚类及 ID;如果已有标签发生变化,模型可能需要重新训练。对持续更新的语料而言,增量维护成本是重要问题,不能只看静态测试集上的召回。
泄露更正与研究写作
回顾作者的更正、未解的基线差异和讲者对论文贡献表述的评价。
讲者解释作者后来发现的泄露:查询生成阶段和后续训练、测试使用了不一致的划分,测试信息进入训练过程。修正后结果明显下降;他肯定作者公开承认错误并更新结果。
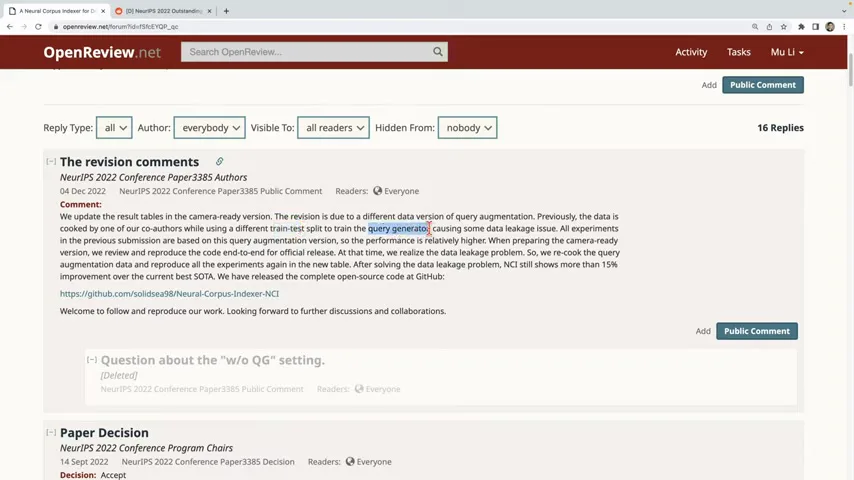
他还追问一个消融比较:去掉部分 NCI 组件后,结果为何仍与相似的 DSI 基线差距较大?作者在回应中提出可能原因并计划进一步实验;讲者明确表示,当时还没有最终答案。
回到论文的贡献表述,讲者认为只在两个问答数据集上获得提升,不足以证明新方法全面替代词项或向量检索。他认可模型可能捕捉较复杂的查询—文档关系,但要求更广泛证据。
讲者质疑将深度检索和排序统一在相同技术栈就一定简化系统:如果检索本身带来显著的吞吐和成本问题,部署和维护上的好处可能被抵消。
他也讨论论文对“首次”与“显著超过”的措辞,认为 DSI 已经提出相近的端到端框架和语义 ID。写作时应准确区分增量改进、实验优势和先前工作的贡献。
尽管批评这些表述,讲者仍认为神经索引值得研究:在较小语料和复杂语义查询中,让模型学习文档信息可能有意义。它的可行规模和实际系统表现需要进一步验证。
他认为复杂查询理解与问答是令人关注的方向,而传统搜索对简单词项查询仍有优势。不同方法可以互补;当时对 ChatGPT 与搜索引擎的比较也不应被视作对未来结果的定论。
最后,讲者强调研究写作中的准确性、可重复性和对前人贡献的说明。工作受到广泛关注时,可靠的实验、透明的更正和精确的措辞尤其重要。
同频道的其他文章
 23:39ZH
 跟李沐学AI· 2025年7月23日李沐:给文本大模型加入一千万小时语音,开源 Higgs Audio李沐 · Boson AI李沐介绍团队如何在文本大语言模型的训练里加入大量语音数据,做成能听能说的 AudioLLM,并把 Higgs Audio 开源。他讲了架构取舍、token 压缩、数据从哪来,以及怎么在 3090 上跑起来。
 1:03:29ZH跟李沐学AI· 2023年1月12日多模态论文串讲:BLIP、CoCa 与 BEiT-3从图文数据清理到统一预训练,梳理三种视觉语言模型的结构、目标函数与相互联系。
 1:07:10ZH跟李沐学AI· 2022年12月29日InstructGPT 论文精读:从人工反馈到语言模型对齐从监督微调、奖励模型到 PPO,梳理 InstructGPT 的训练流程、实验结果与局限。