30 秒看懂
Neil Mitchell 解释 Meta 为什么在 Pyre 之后构建 Pyrefly,以及不断发展的 Python 类型系统如何影响其设计。他介绍了文件级增量检查、绑定、类型推断、循环导入、内存管理和现有代码兼容性。
- 1从 Pyre 吸取的经验Meta 早期的检查器在语言集成、架构和开源采用方面遇到的挑战,影响了后继项目的设计。
- 2文件级增量处理文件级失效简化了依赖图,但要求快速重新检查单个文件。
- 3先建立绑定,再计算答案检查器将控制流和名称解析转化为键值绑定,然后求解其类型。
- 4无需全面重查即可处理导入循环检查器先假定相邻接口没有变化;必要时传播变化,并回退到处理整个循环。
- 5类型推断是用户体验选择一位观众建议通过有界变量推迟确定列表的具体类型。
要点建议
- Python 类型系统必须描述已有的动态代码,因此推断与兼容性是重要的设计选择。
- Pyrefly 使用文件级增量构建架构检查大型代码库,并快速响应编辑。
- 绑定阶段将控制流和名称解析与后续类型计算分开。
- 紧凑的导出接口和数据清理减少内存占用,延迟计算则处理循环依赖。
- 增量检查可以乐观复用导入循环中的接口,并在必要时回退到整个循环的失效处理。
- 演讲将 Pyrefly 描述为不断发展的 alpha 项目,重视开源使用和兼容性。
按章节阅读整理后的全文
Python 类型与 Pyrefly
Mitchell 介绍静态检查、类型推断和编辑器支持。他解释了 Meta 的规模以及从 Pyre 到 Pyrefly 的历程。
Meta 程序员 Neil Mitchell 此前参与 Buck2,现在介绍开源 Python 类型检查器和语言服务器 Pyrefly。Python 注解例如可以指定整数参数和字符串返回值,但解释器通常不会把它们作为静态保证来强制执行。
有了注解,运行时工具可以在程序执行时检查值,静态检查器则在执行前检查代码。Python 在这两类中都有多个工具。它的类型语言已经发展得很丰富,支持泛型、字面量类型、类型收窄、高阶函数等功能,并有规范和一致性测试。
Pyrefly 使用 Rust 编写,以获得速度、并行能力和跨平台支持。团队此前开发过 Pyre。Pyrefly 的一个核心目标是推断:程序员提供有用的提示,检查器推断其余的大部分内容,让 Python 代码保持通常的风格。
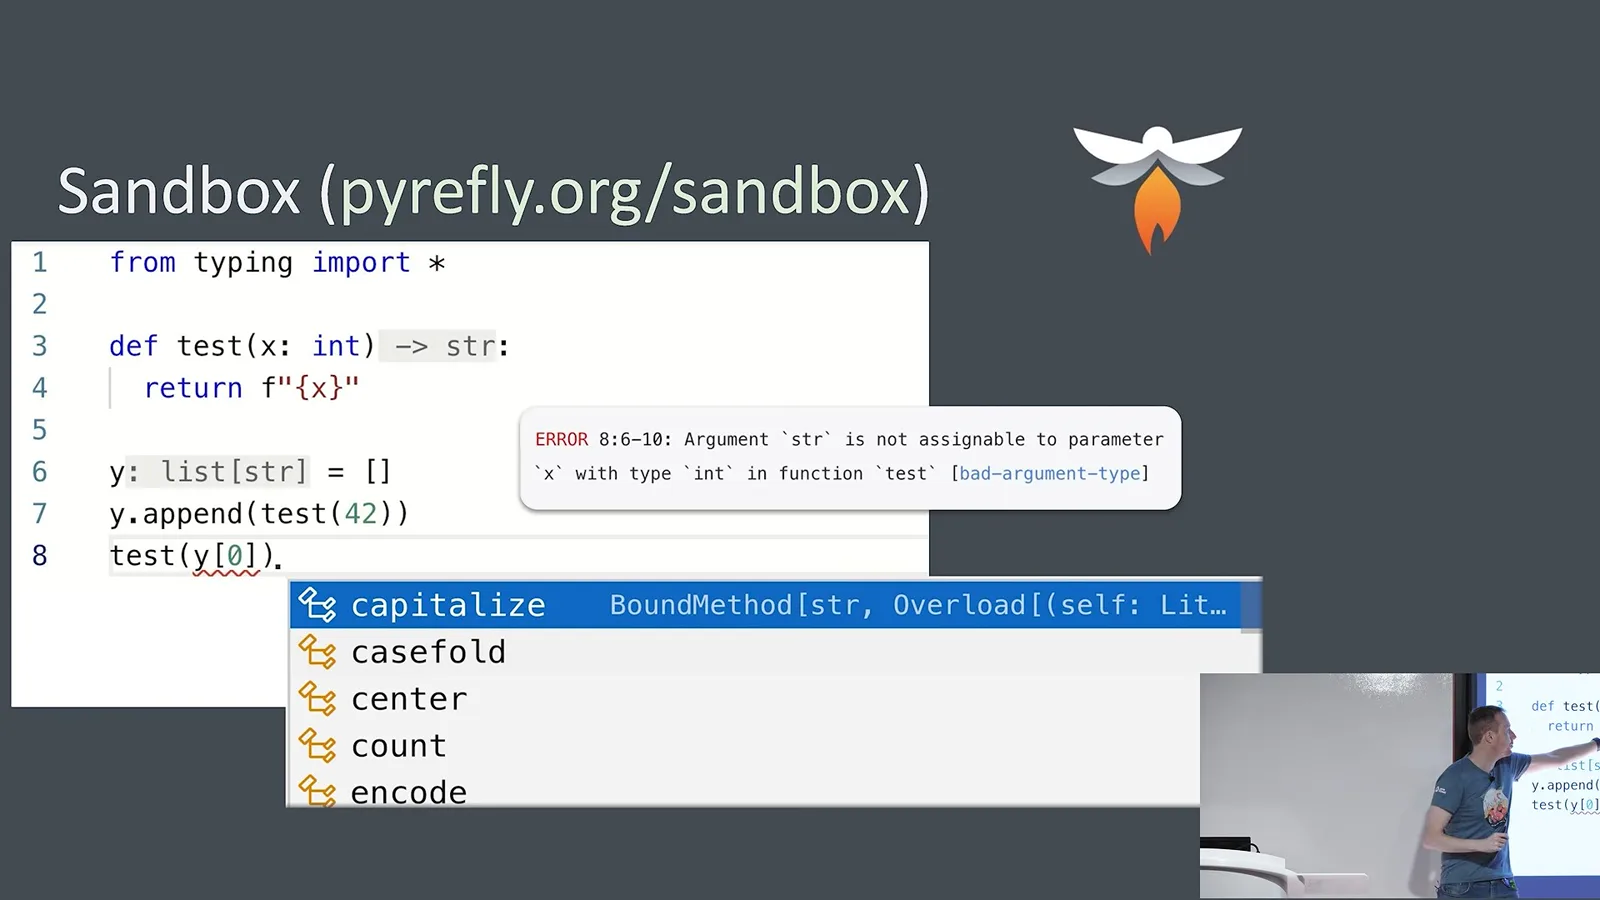
在沙盒示例中,Pyrefly 在编辑器中显示推断类型,推断列表元素类型,报告将字符串传给整数注解参数的错误,并为已知字符串结果提供补全。Mitchell 指出,类型错误可能比 Python 运行时错误更严格:示例中的特定字符串参数实际上可以运行。
推动这项工作的规模很大。Mitchell 说,Instagram 服务器包含超过 2,000 万行 Python 代码,Meta 每天约有 3,300 名开发者使用 Python。在这种规模下,类型检查帮助人们修改代码而不破坏无关行为。
Meta 在 2017 年启动 Pyre,此前遇到了现有检查器 mypy 的规模和性能问题。Pyre 使用 OCaml 编写,借鉴了公司此前为 PHP 和 JavaScript 添加类型的工作,后来成为 Meta 开发流程的重要部分。
Mitchell 说,当时 OCaml 并不完全适合 Meta 的环境,原因包括 Windows 支持、难以使用多进程和共享内存实现并行,以及外部贡献者面临的障碍。他强调,有些问题反映了 Meta 自己的投入选择,OCaml 并非 Pyre 问题的唯一原因。
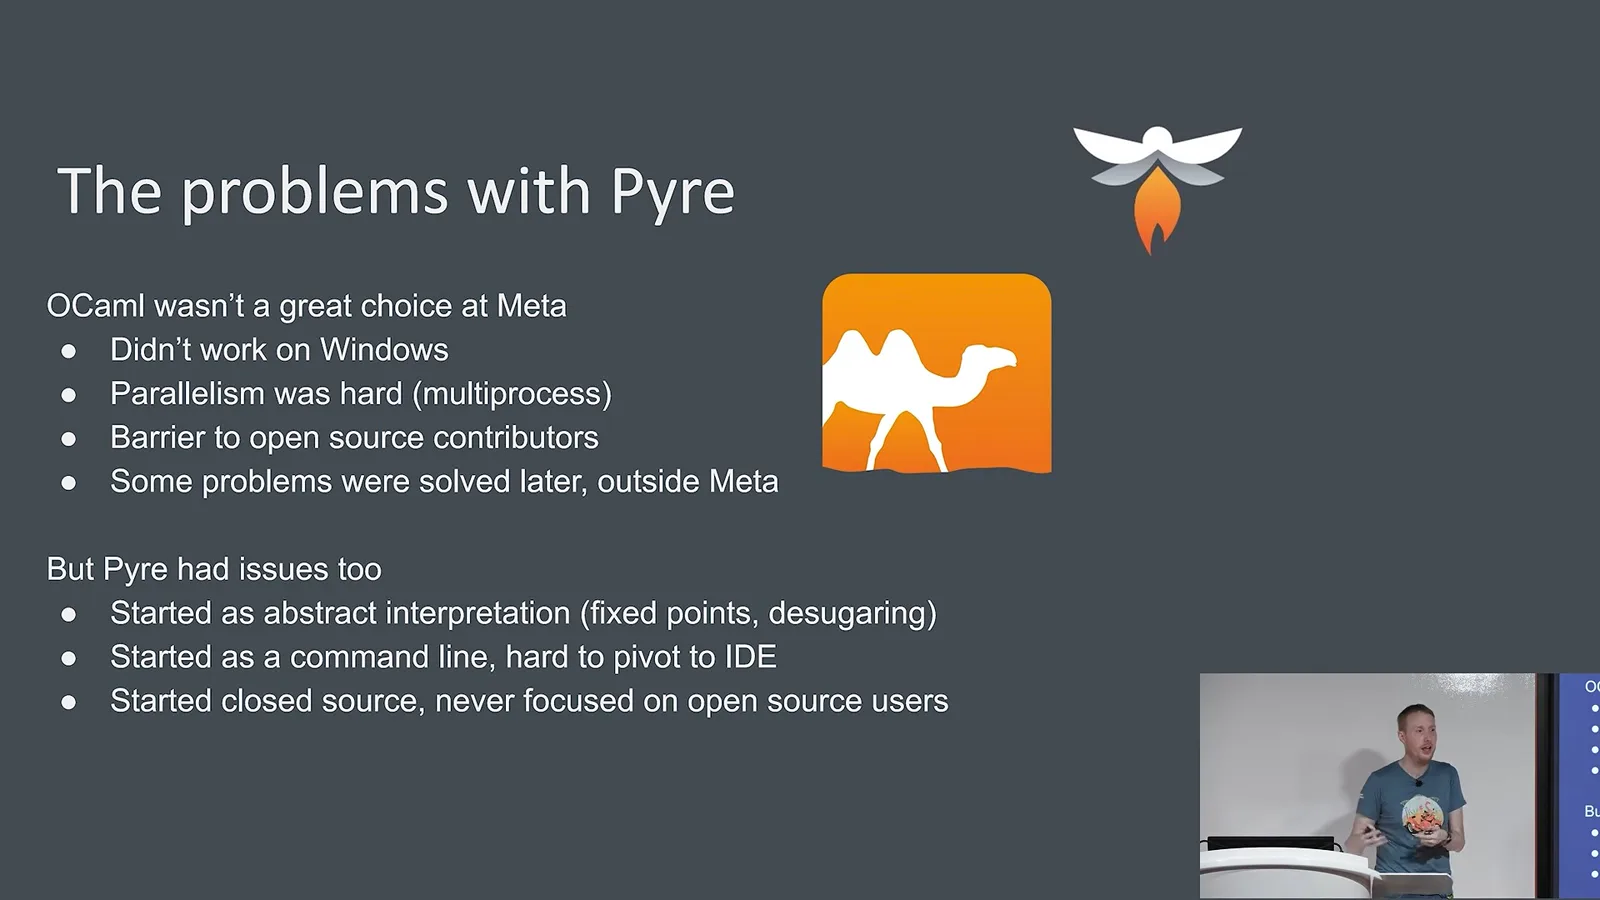
Pyre 也有结构性限制:它的抽象解释器设计大量使用脱糖,没有常规的符号表和作用域解析;它最初是命令行工具,也没有一开始就关注开源用户。广泛采用后再补上这些能力很困难。
大约在 2024 年 8 月,两位开发者开始制作后继项目的原型,探索约束求解、更传统的子类型方法和抽象解释。他们选择 Rust,因为它兼顾速度、内存安全和可移植性,而且在 Python 工具社区日益普及。
原型在 2024 年 10 月成为正式项目。团队发现已有 Python 绑定使用 pyre2 这个名字,于是选择 Pyrefly。项目在 PyCon 发布了 alpha 版本;Mitchell 说检查器仍在开发中,但已经可以试用。
Python 类型系统的形态
类型是后来加入一门成熟的动态语言中的。字面量、泛型、协议、重载和类型收窄都反映了这一历史。
Python 类型系统是后来加到大量已有代码上的,而不是从语言诞生之初就一起设计。它不断扩展,以描述之前没有类型标注的模式。类型可以发现少有机会运行的异常处理代码中的问题,也能为生成代码提供有用的检查。
标准和一致性测试提供了共同基础,但各实现仍需决定推断多少内容。Mitchell 指出,更多推断实际上可能拒绝更多程序,因为推断较少的检查器可能对未知信息采用更宽泛的近似。
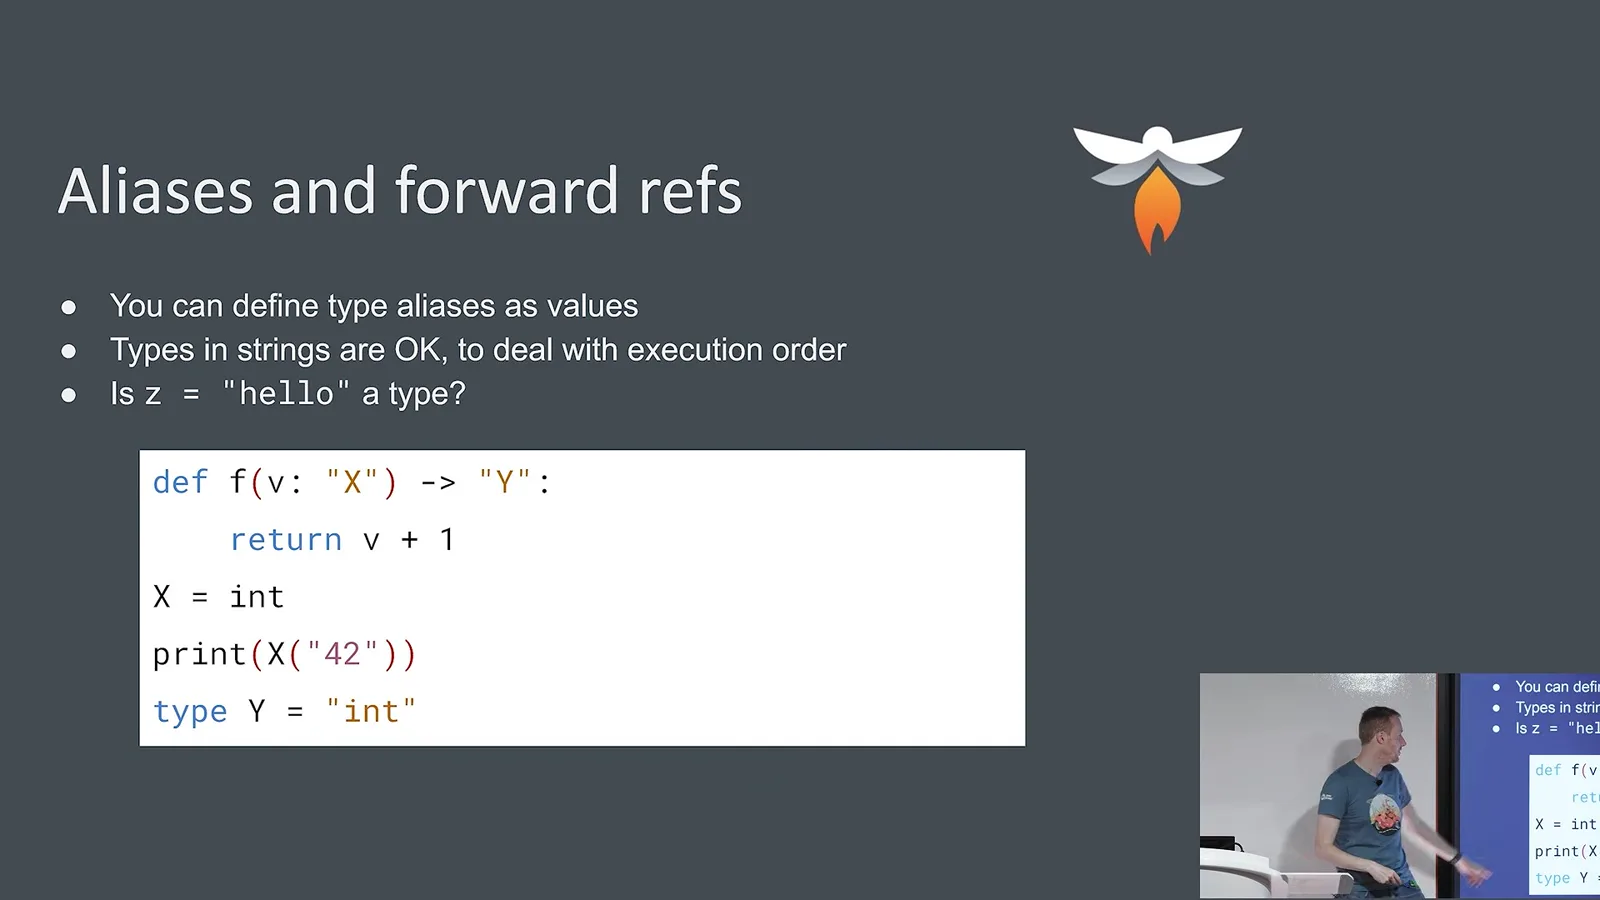
Python 支持类类型和字面量类型,例如特定的文件模式字符串或整数 42。注解可能在运行时求值,而只为类型而导入模块可能有成本。带引号的注解和显式类型别名语法解决了部分复杂性,但旧形式可能使值和类型别名难以区分。
渐进类型 Any 表示未知的静态类型,双向赋值都被允许。Mitchell 指出,包含 Any 的联合类型可能不像简单地将一切归为 Any 那样直观。Never 和 NoReturn 描述不可达或没有值的结果。
对于没有注解的变量,Pyrefly 通常尝试推断出比 Any 更有信息量的类型;在他描述的方法中,没有注解的函数参数默认是 Any。Python 泛型支持类型变量、约束、边界和变型,较新的语法还可以推断变型。
协议支持结构化子类型:一个对象只要具有所需的 close 方法,即使没有显式继承,也能满足关闭协议。重载为不同输入提供不同签名;实现必须与这些签名兼容,但检查器不会证明声明的每一种行为关系都成立。
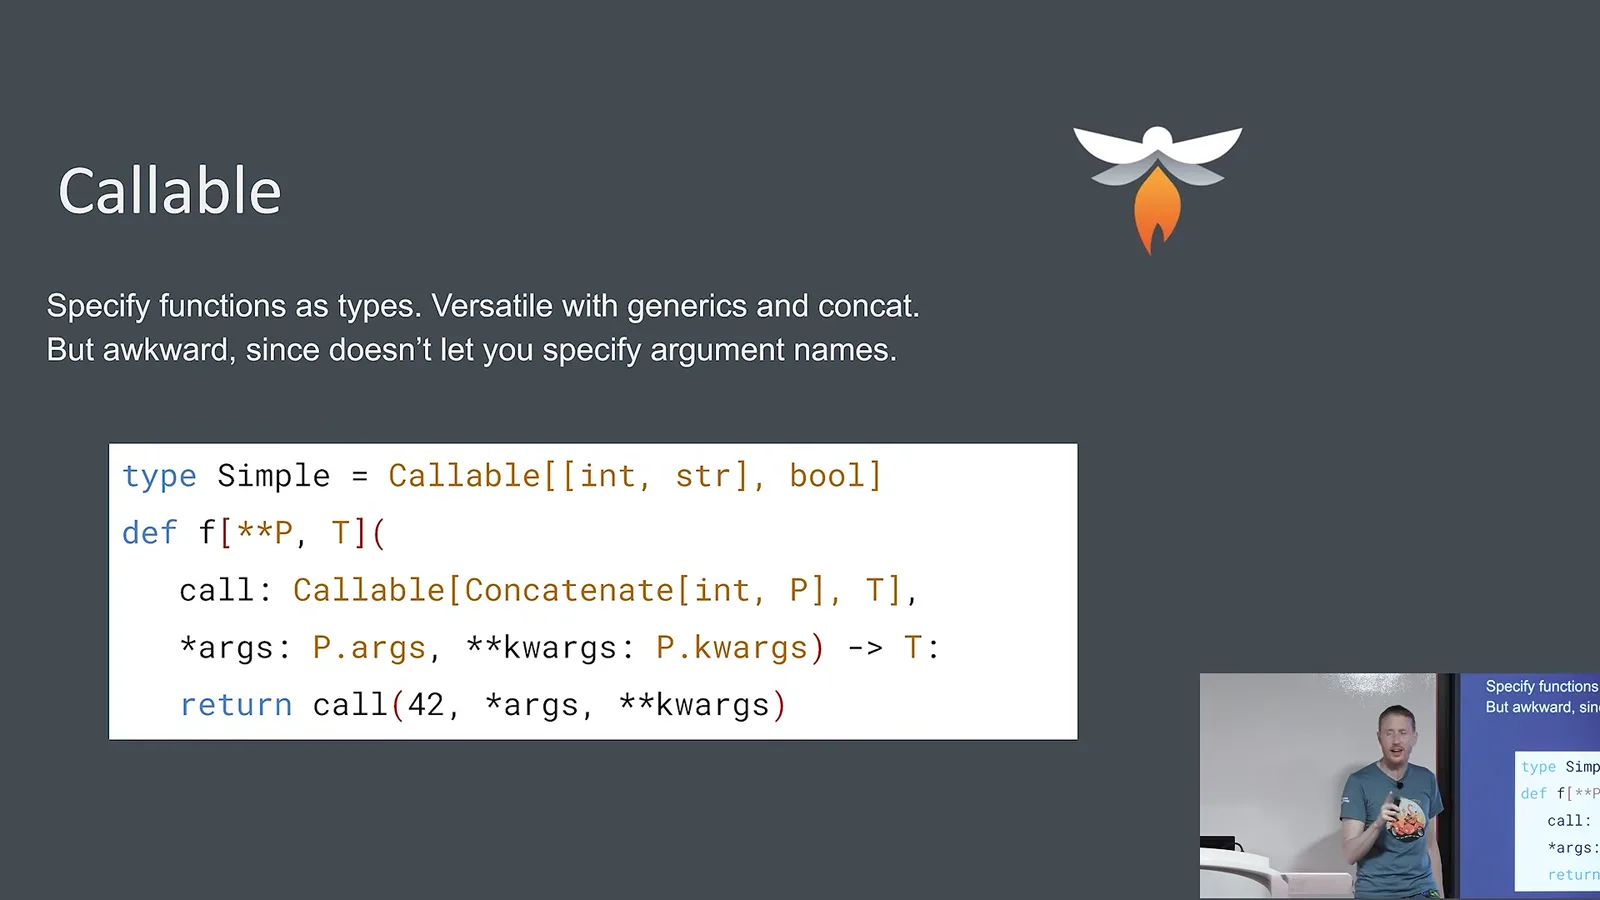
高阶类型需要处理 Python 的位置参数和关键字参数。参数规范可以描述这些参数的泛型组合。流敏感的类型收窄也能细化类型:测试一个字符串或 None 值的真值后,某个分支可以将它视为字符串。
为已有内置对象编写类型也是一项挑战。Typeshed 提供描述,但某些运行时 API 无法完全适合整齐的类型模型。Mitchell 以字典和可变映射的兼容性为例,说明务实的处理方式有助于现有程序继续工作。
用于类型检查的构建系统
文件级增量处理、内存清理和循环支持推动了架构设计。每个文件都会经过六个阶段。
Pyrefly 的设计目标包括在 Instagram 规模下实现时间和内存效率、支持命令行与 IDE、集成构建系统,以及让开源贡献者能够修改代码库。循环导入是必须支持的情况,而不是例外,因为大型 Python 代码库中常见这种情况。
借助构建系统经验,Mitchell 选择文件级依赖和失效处理。更细的粒度会增加复杂性,而大型代码库本来就有大量文件。一次按键会使整个文件失效,因此重新检查通常必须在几毫秒内完成;不用的数据也必须清理。
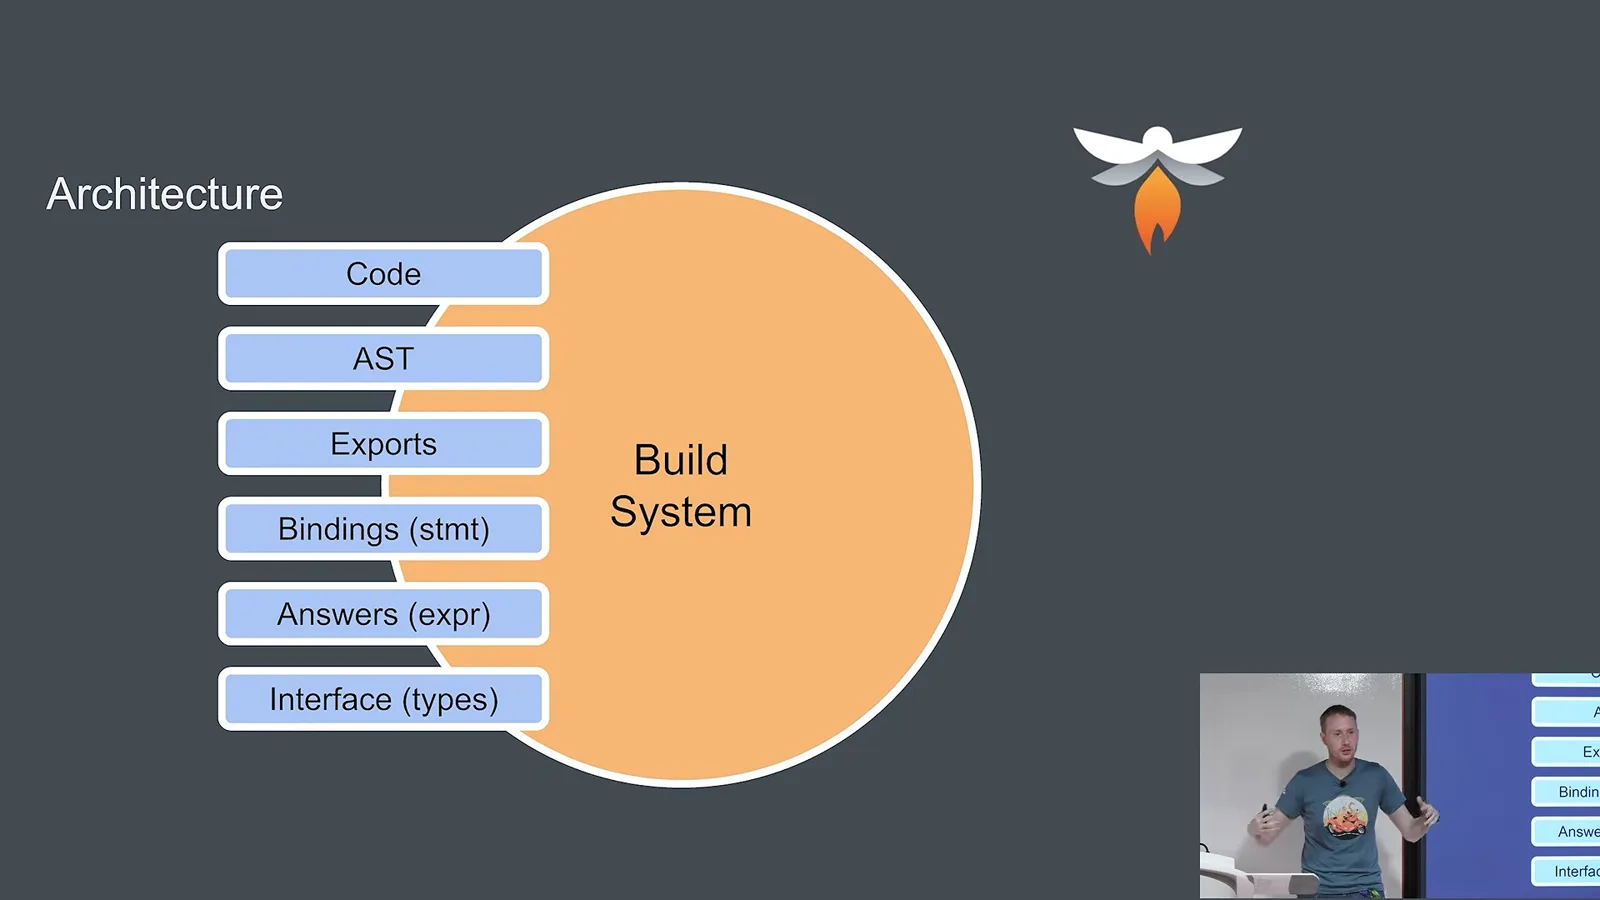
构建系统层管理依赖、失效和并发,每个文件经过六个阶段:代码、AST、导出、绑定、答案和接口。它从磁盘或编辑器缓冲区获取源代码,并用 Ruff 的纠错 Python 解析器解析;即使代码不完整,解析器也能返回 AST。
导出阶段确定每个模块提供的名称,包括通过星号导入获得的名称。循环星号导入可能需要求最小不动点。这些结果还为构建图建立模块间依赖。
绑定、答案和推断
绑定记录控制流和名称解析。延迟答案、上下文类型和新变量有助于解决 Python 的类型问题。
绑定阶段将语句转化为键值关系,描述如何计算每个已识别位置的类型。它在后续类型计算之前解析执行顺序、控制流和名称使用。一次名称使用可以指向定义,也可以指向另一个模块中的导入。
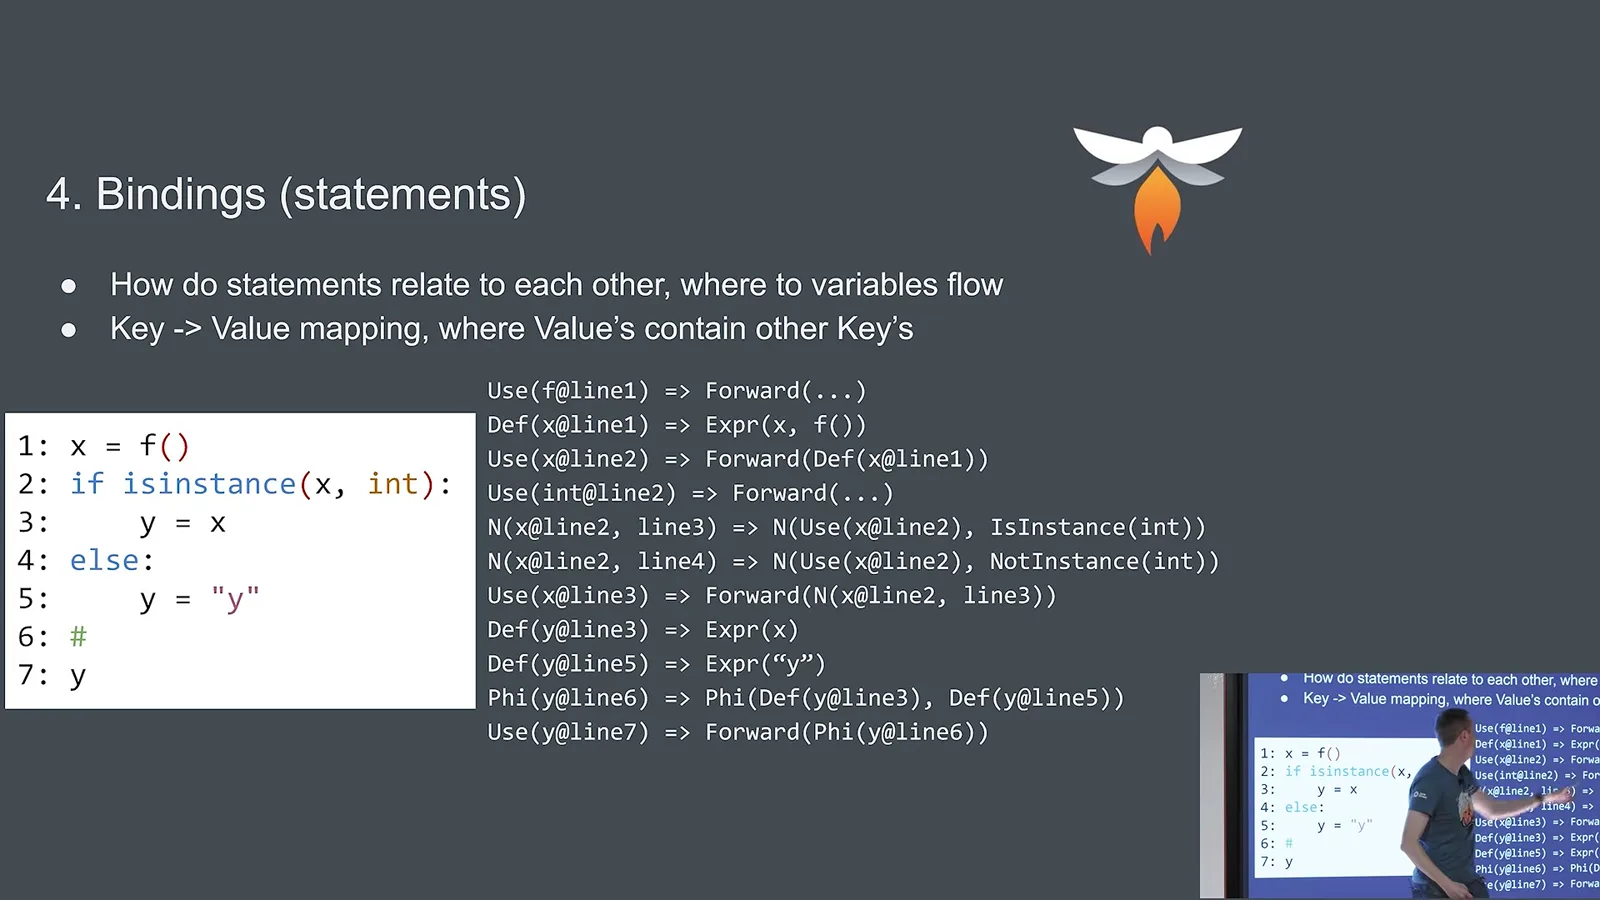
在分支汇合处,phi 操作合并可能的定义,通常形成联合类型。isinstance 等测试会在分支中提供类型收窄。结果是一种紧凑的 Python 类型检查中间语言,避免反复分析原始控制流结构。
一位观众问到海象赋值表达式。Mitchell 说,它会使事情复杂化,因为表达式内部也能定义名称;绑定阶段通过线性化相关布尔表达式并创建适当绑定来处理。循环和赋值表达式使这部分实现更加复杂。
答案阶段计算绑定关系,并从子表达式类型推导更大表达式的类型。导入和返回类型推断中都可能出现循环。延迟计算,也就是 thunk,和新变量有助于表示尚未知晓的答案。
接口保留导出名称的类型,它是答案中较小的子集。为节省内存,Pyrefly 可以在生成接口后丢弃 AST、绑定和答案;对于 IDE 中打开的文件则保留更多信息,以支持导航和其他编辑器功能。
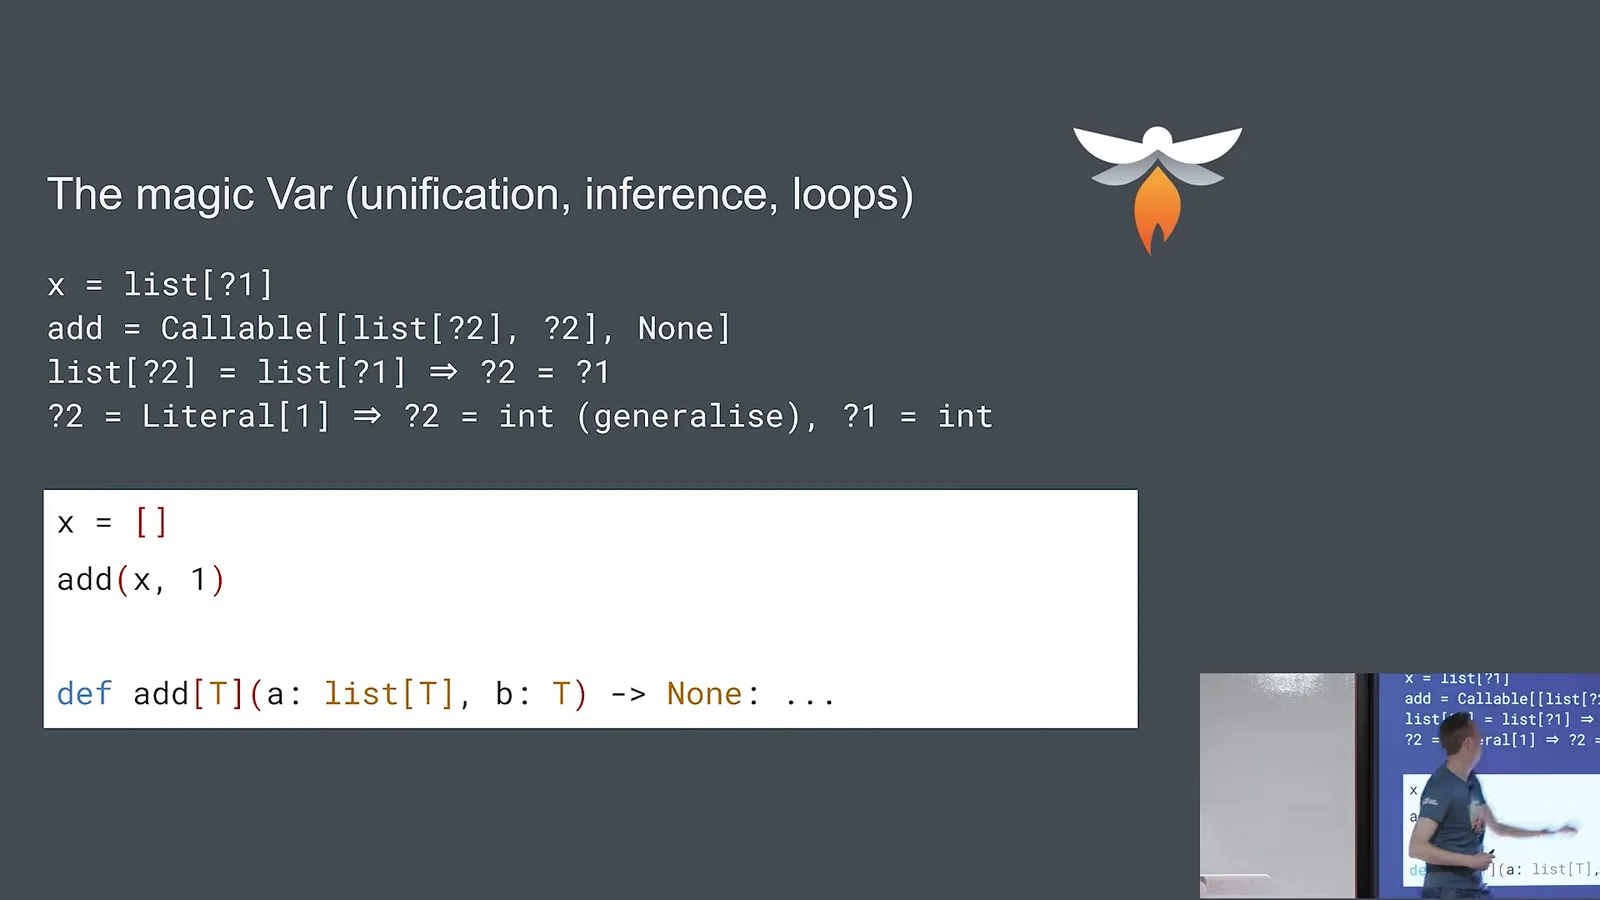
Mitchell 以列表说明推断。包含字面量 1 的列表通常推断为 list[int],而不是 list[Literal[1]],因为可变列表是不变的,仅允许字面量的列表可能阻碍后续有用操作。混合列表可以推断为联合类型;上下文注解则可以告诉检查器保留字面量类型。
对于空列表后接泛型添加操作的情况,Pyrefly 首先为元素类型创建新的未知变量。泛型函数用另一个新变量实例化;来自列表和值 1 的约束将变量联系起来,确定整数元素类型。检查器通过下一次使用来约束列表,否则回退到 Any。
循环、内存与扩展性
紧凑接口和乐观循环算法减少了工作量。Mitchell 讨论性能、内置集成、递归和开源开发。
跨模块查询可以使用已经生成的紧凑接口;如果循环使接口尚未完成,也可以强制计算答案。只有导出的答案对其他模块可见。这种分离让循环期间可以延迟计算,同时避免将私有答案纳入接口。
存在循环时的增量检查很棘手:把大型导入循环折叠成一个节点可能迫使数万个模块重新检查。如果 A 发生变化,Pyrefly 首先假定 B 和 C 的旧接口不变来检查 A。如果 A 的导出接口没有变化,其他文件就不必失效。
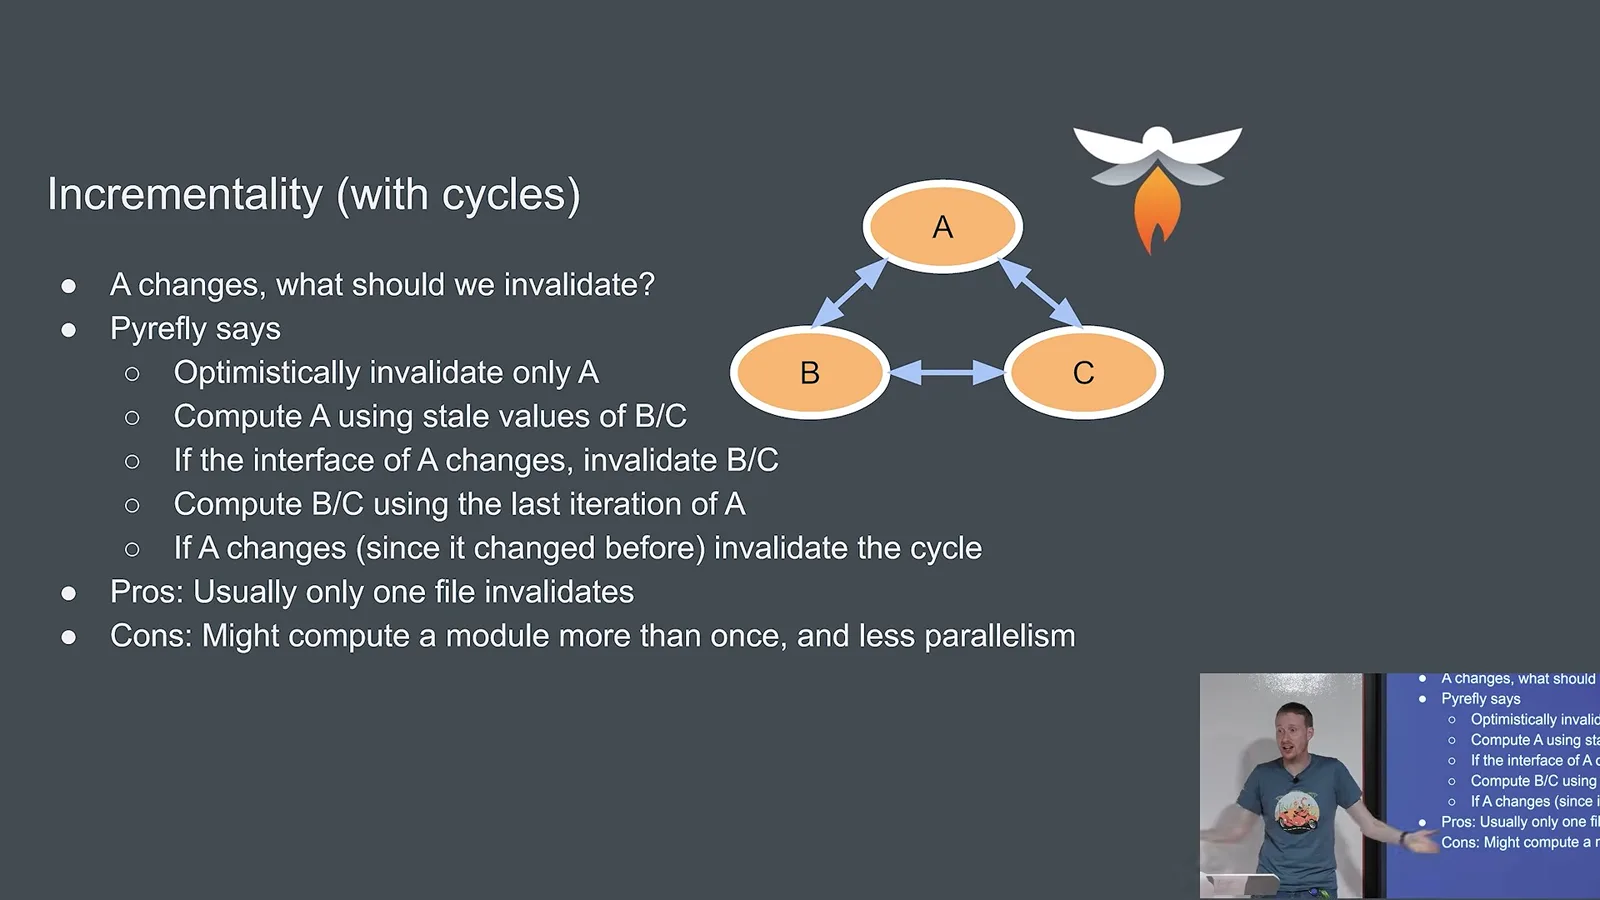
如果接口发生变化,检查器会向受影响的模块传播,并可能重新访问 A。为避免无限迭代,它在重新访问工作或达到深度限制后回退,使整个循环失效。常见情况可以快得多,但有时会重复工作或降低并行度。
Mitchell 将导出、绑定和答案描述为成本逐渐提高的阶段;在他的性能分析中,每个阶段大约比前一个高一个数量级。线程和线程池很重要,但当时并行还不是最重要的优化。类似事务的协调机制让编辑器查询和更新可以并发进行。
面对快速发展的类型系统,Pyrefly 没有立即提供外部插件 API,而是直接纳入扩展。Mitchell 提到内置 Pydantic 支持、正在进行的 Django 工作和原生 Buck 集成;团队也在探索其他构建系统的支持。
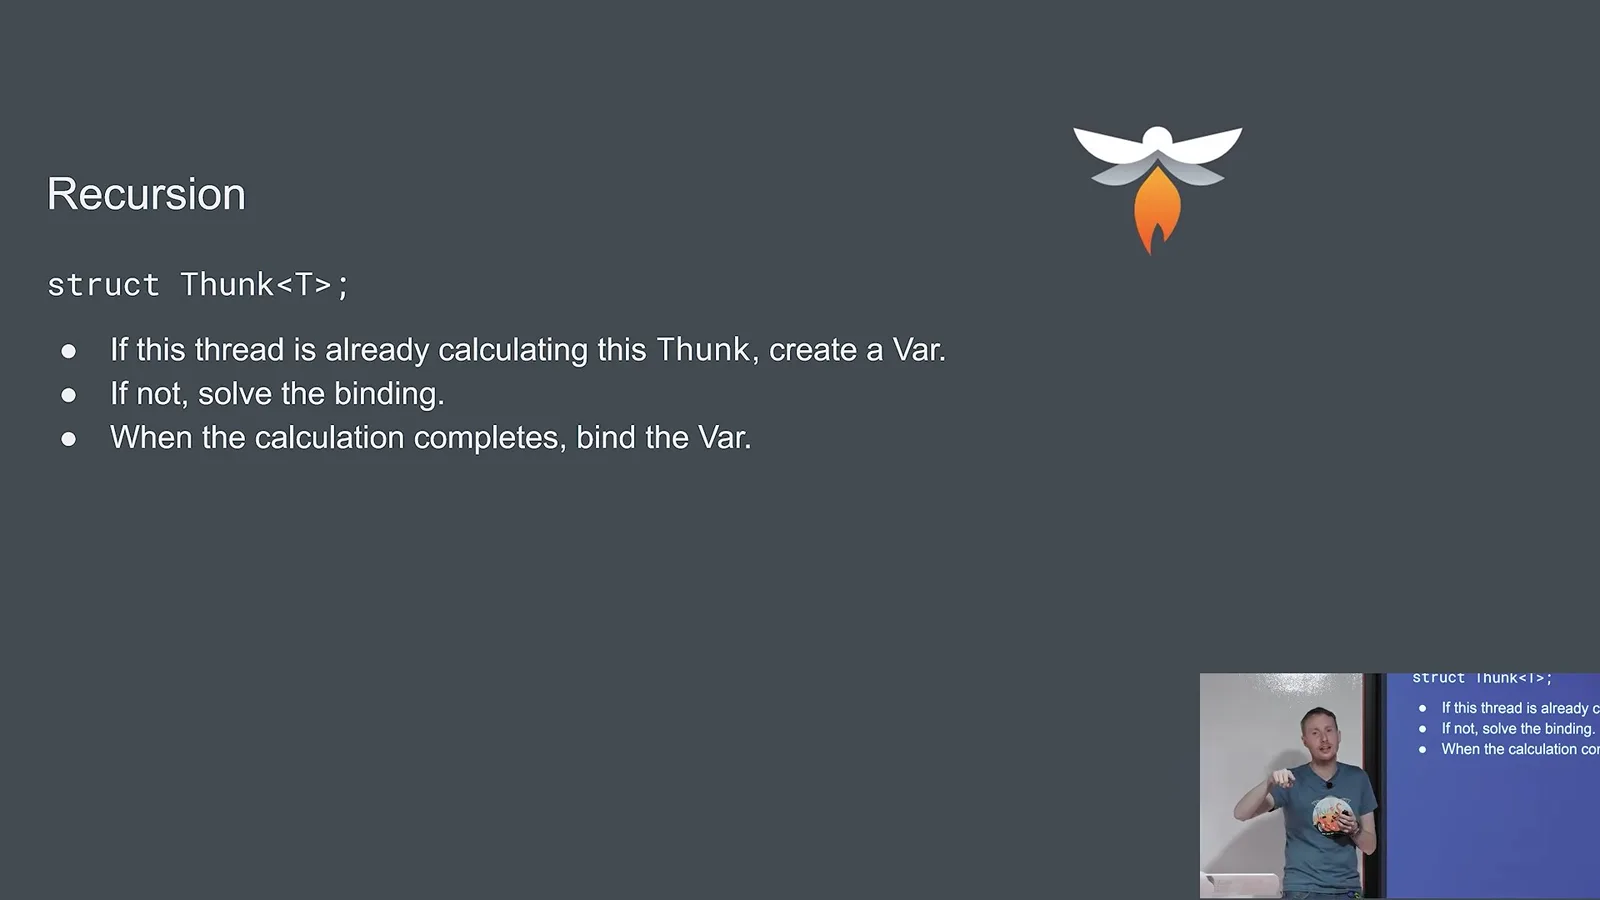
对于递归,检查器可以在可能出现循环的地方放置一个 thunk。如果求值时在调用栈上再次遇到同一计算,就插入新变量,并在之后用计算结果约束它。这种方法不能解决所有情况,但同一套变量机制也适用于泛型、推断和递归。
Pyrefly 采用 MIT 许可证,接受贡献,并有问题跟踪器和 Discord。Mitchell 说,团队有意优先考虑开源用户,因为更广泛的 Python 生态也有利于 Meta。在演讲时,他将项目描述为仍有漏洞的 alpha 软件,已有超过 100 位贡献者。
关于推断与兼容性的问题
观众探讨有界变量、循环接口和子类型约束。Mitchell 介绍 PyTorch 的迁移经验。
问答中,一位观众建议保留一个有界变量作为列表最一般的类型,而不是立即选择 list[int]。Mitchell 认为这可能将联合类型与共同超类型等选择推迟到后续使用时,团队可以探索;多重继承会使格结构更加复杂。
另一个问题追问循环计算期间使用答案是否与基于接口的失效机制冲突。Mitchell 解释说,跨模块查询只能访问导出的答案,而完成的接口包含相同的导出信息。接口仍在计算时需要延迟答案。
被问到约束求解时,Mitchell 说大多数约束是子类型关系,例如要求实参类型是形参类型的子类型。联合类型让这些关系更加复杂,加入交叉类型后,子集检查可能类似可满足性求解。
关于兼容性,Mitchell 介绍将 PyTorch 从 mypy 迁移到 Pyrefly 的工作:添加了几百处类型忽略,同时删除了数量相当的忽略。他说,两种检查器总体相当,但可能接受不同的程序,包括 Pyrefly 报错而另一检查器漏掉的情况。大型项目可能需要更多迁移工作。
同频道的其他文章
 1:48:29EN → 简体中文
 1:36:37EN → 简体中文
 1:05:45EN → 简体中文
 1:25:00EN → 简体中文
 1:16:29EN → 简体中文
 27:39EN → 简体中文