30 秒看懂
Pim de Witte 介绍 General Intuition 的方案:利用 Medal 收集的游戏画面和带标签的输入,训练持续观察与行动的视觉模型。他讨论机器人控制、生成环境、潜在应用以及与 JEPA 的比较;性能和数据规模说法归属于公司,演讲未独立验证。
- 1共同控制器部分游戏和机器人使用类似的人机控制,但技能迁移仍是另一个挑战。
- 2持续观察所提出的模型在环境变化时反复接收画面并预测动作。
- 3公司报告的数据规模De Witte 提到 Medal 数据每月产生超过 1.5 万亿个动作 token。
- 4广泛能力的说法他称一个模型能够处理游戏和十多类机器人,但演讲没有展示独立基准。
- 5动作标签与 JEPA他对比显式动作标签和推断动作,并承认各有权衡。
要点建议
- 视觉行动模型可以设计成在输出控制动作的同时持续观察。
- 配有输入标签的游戏录制可能成为行动模型的训练数据。
- 共同控制接口本身不能证明技能能可靠地从游戏迁移到物理机器人。
- 公司关于数据规模和支持多种机器人的说法,在演讲中没有独立基准佐证。
- 潜在应用包括计算机交互和无障碍使用,同时由编排者处理较长期规划。
按章节阅读整理后的全文
为什么需要持续行动
De Witte 对比轮流进行的语言交互与边观察边行动的系统。
设想用现有信息训练模型,再将结果应用于训练数据中没有直接出现的问题。General Intuition 正用电子游戏的交互视觉数据探索类似思路,但能否泛化到特定机器人,仍是需要实验验证的问题。
我用《冰雪奇缘》中的一个场景说明行动过程中持续观察的重要性。与纯粹的轮流交互不同,具身系统需要在移动时应对不断变化的世界。
我认为,专门构建的行动模型可能比把文本语言模型当作完整控制循环更适合这一场景。这是我们的架构判断,本场演讲没有给出受控比较。
游戏数据与共同控制接口
Medal 提供与动作配对的画面,控制器可能成为连接机器人遥操作的桥梁。
我们的起点是游戏录制平台 Medal,用户在许多游戏中录制自己的操作。我们将画面与手柄或键鼠动作关联,并标注动作含义,构成视觉模型的训练样本。
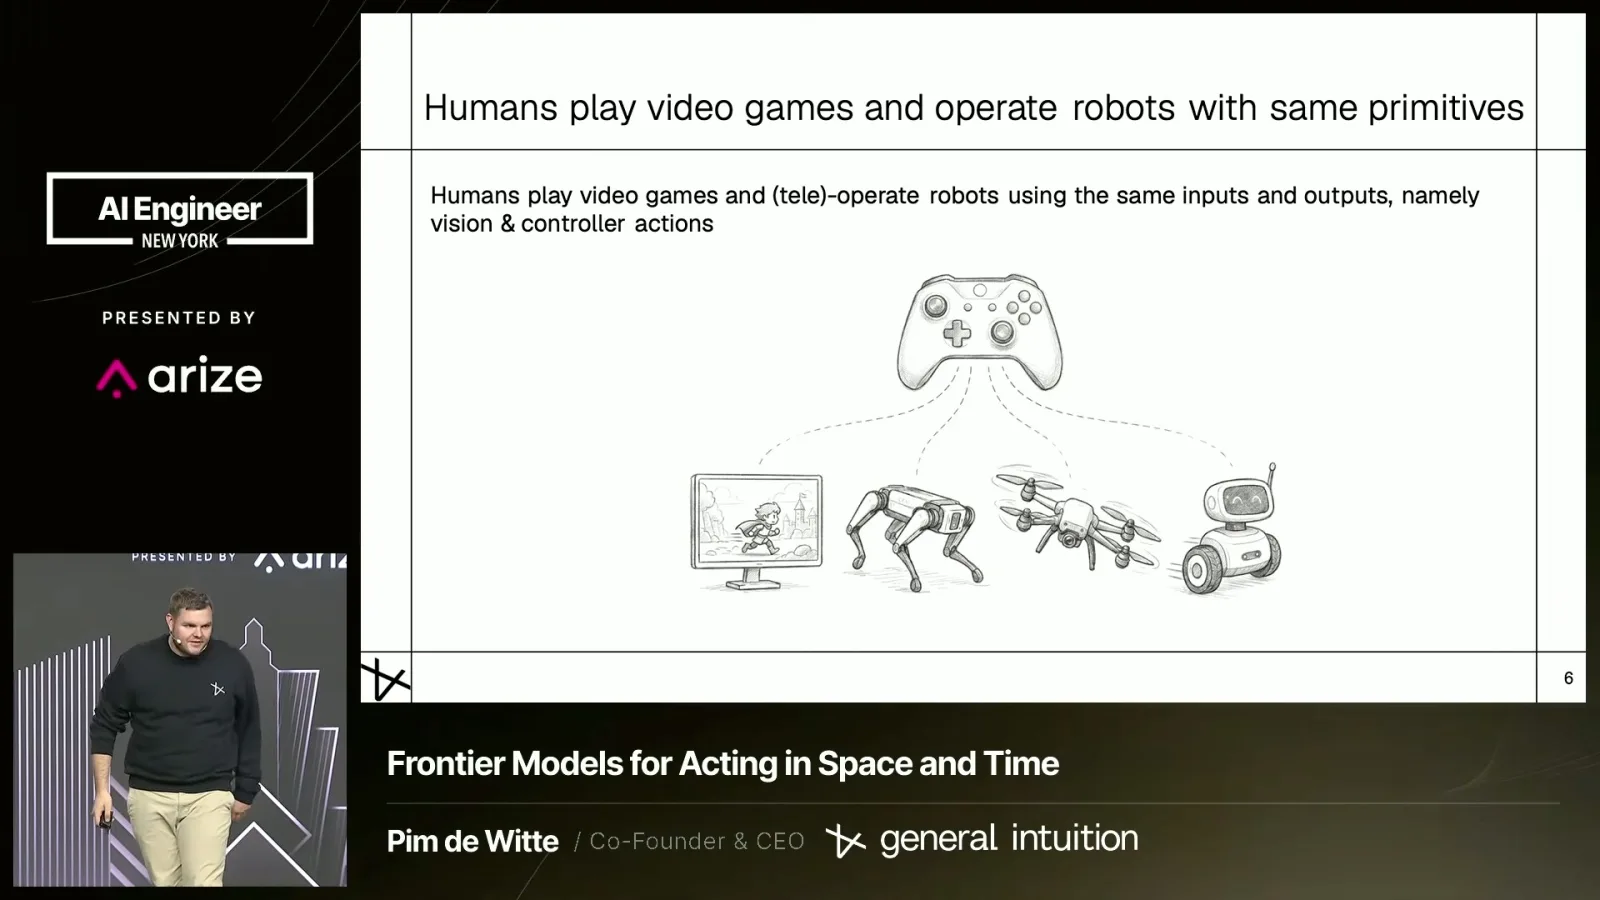
这一思路的直觉是,人既可以用游戏手柄玩游戏,也可以用它遥操作某些机器人。这可能提供一种共同接口,但熟悉的控制器并不会消除模拟环境与物理环境的差异。
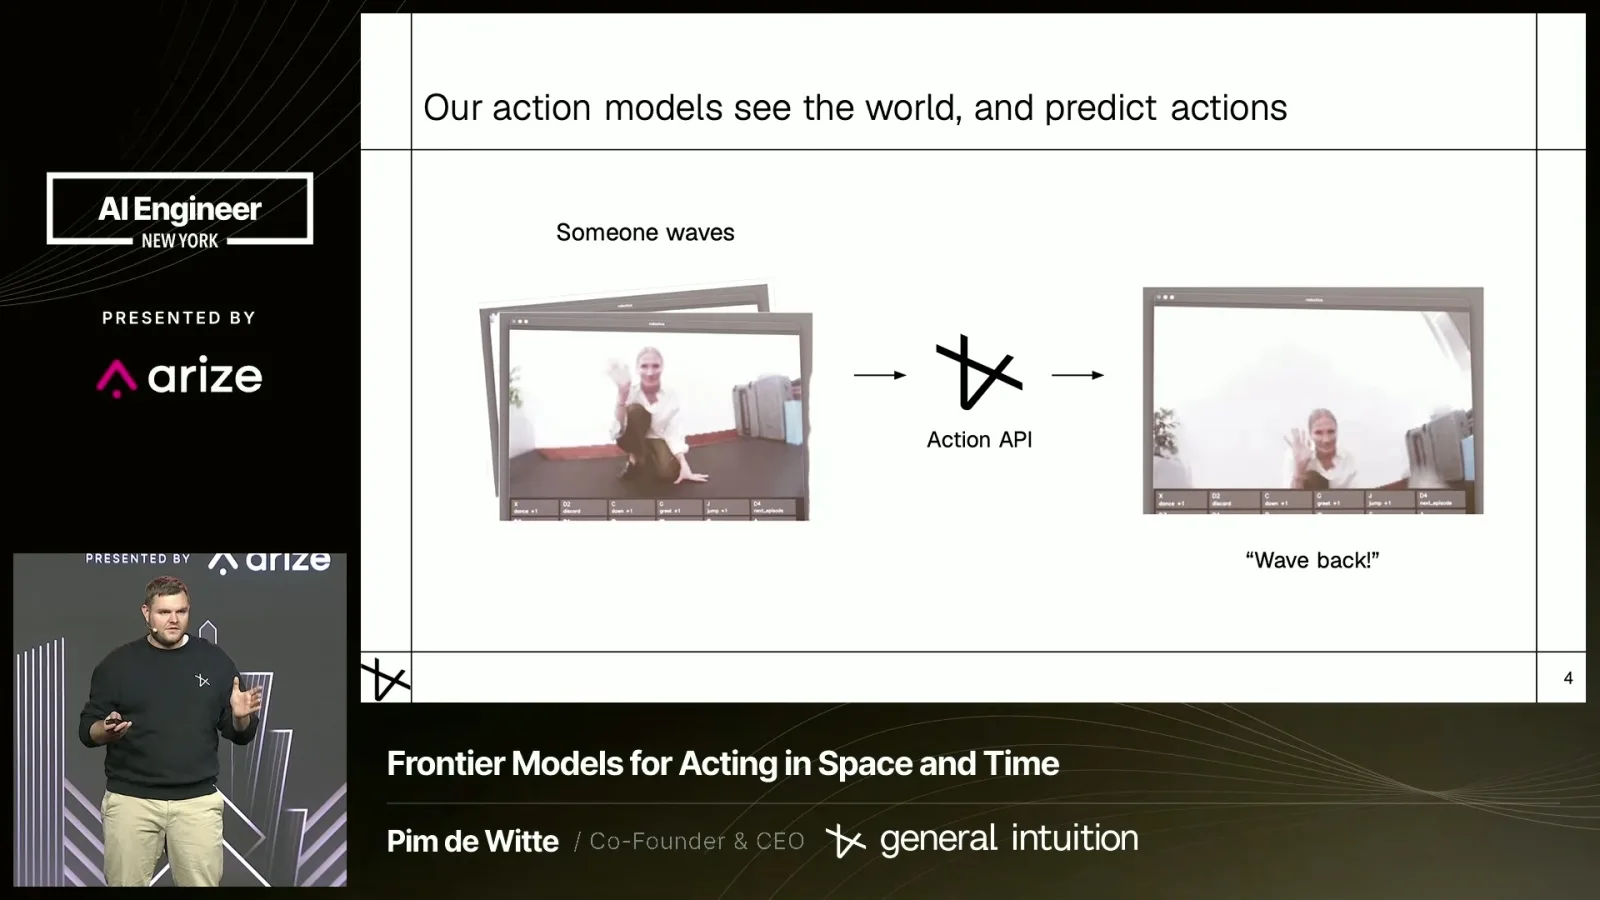
模型接收画面和一组可用控制,还可以接收文本指令。一个简单例子是,将“向对方挥手回应”映射为可用的问候动作;输出是动作,而不是一段文字。
输入像素,输出动作
演讲者介绍一个反复观察视觉输入并输出控制的模型。
我将其与文本生成对比:文本模型通常生成一次回复后等待下一轮。我们的设计反复接收视觉观察并预测控制器动作,目标是在场景持续变化时运行。
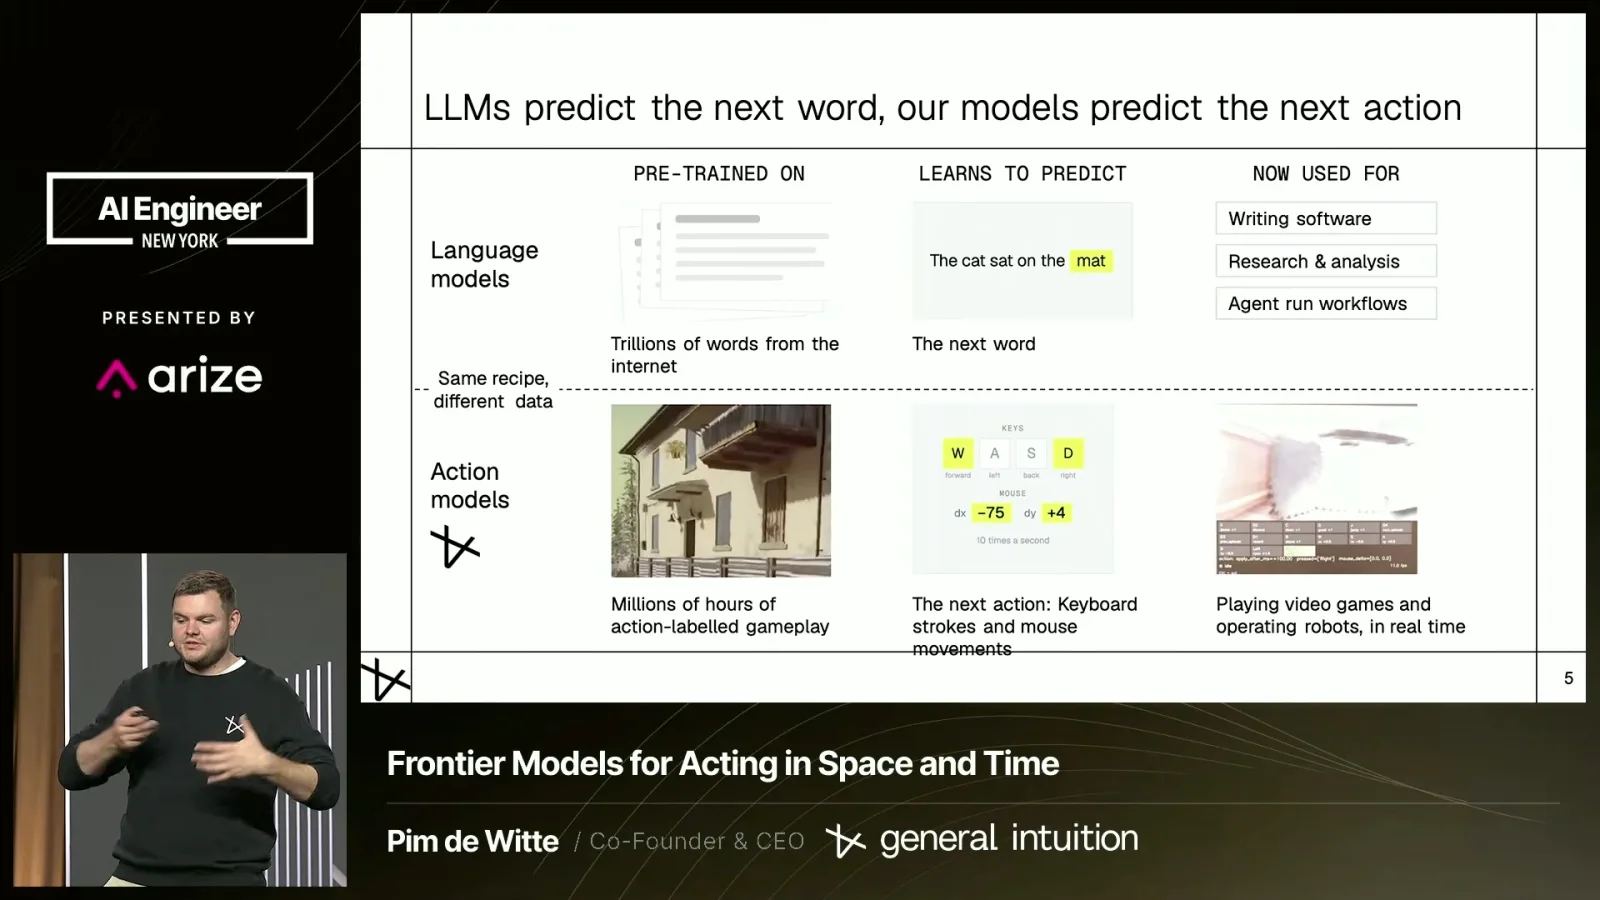
我们的判断是,许多问题可以表达为“输入像素、输出动作”。输出空间可以包含键盘、鼠标或手柄动作,把计算机操作模型的思路扩展到更多控制方式。
机器人已有一些控制接口,能将人的指令转成底层电机行为。我们的方法希望在这些接口可用时直接利用它们,而不是直接预测每一个电机扭矩。
规模、环境与动作密度
公司报告的数据规模和生成环境支持其提出的训练思路。
我称 Medal 目前每年约有十亿条视频上传,并有望达到三十亿条,每月产生超过 1.5 万亿个动作 token。这些是公司报告的规模数字;演讲并未独立证明有多少数据适用于每一种机器人任务。
训练上的押注是,跨游戏的规模化数据能够帮助单一模型处理范围更广的视觉行动问题。我把它比作先专注一种模态,再期待用户把更多问题带入该模态。
我们也研究生成更多训练环境的世界模型。我认为,在视觉空间学习可能减少构建数字孪生以及检查模拟任务与现实是否一致时的一些转换环节。
游戏可能包含密集的连续动作。我认为,这或许有助于无人机控制等需要大量微调的任务;高动作密度也能提供与较慢遥操作不同的训练信号。
动作标签旨在保留被按下的按键及其语义。我认为这有助于解释,但标签本身并不能保证模型内部推理透明。
潜在用途与发布计划
公司宣称模型有广泛能力,并提出工作流及无障碍应用设想。
我说公司计划在今年晚些时候发布模型,并正向部分对象展示现场演示。我称一个模型可以用相同基础操作高水平玩游戏并控制十多类机器人;演讲没有为这一说法提供独立基准。
拟议部署仍使用编排模型进行较长期规划,再把视觉行动模型接入工作流以进行实时交互。我提出探索用户界面等潜在用途,但并不是说每个用途都已经得到验证。
一个无障碍设想是,让用户控制鼠标,由模型补充键盘动作,从而可能帮助只能使用一只手的人玩游戏。这是应用设想,而不是经过验证的临床或无障碍结果。
我介绍了三个团队,分别负责世界模型、策略或智能体,以及数据和环境生成。我还谈到计划中的早期访问和活动;这些日期只是演讲时的计划。
关于 JEPA 的问答
De Witte 比较使用动作标签与推断动作的训练方式。
被问到与 JEPA 的区别时,我说我们的训练使用动作标签,而我理解 JEPA 更依赖推断动作。我认为两种路径各有权衡,并预计双方会相互借鉴。
例如,仅凭视频画面可能看不出飞行员正在移动方向舵控制。我认为,直接观察到的动作有助于训练动作序列;团队同时也使用不同方法进行世界模型研究。
同频道的其他文章
 20:45EN → 简体中文
 AI Engineer· 2026年11月5日John Stecher 与 Scott Worland:构建能够随 AI 模型进步而改变的系统Scott Worland, John Stecher · Norm AIBlackstone 和 Norm AI 的技术负责人讨论数据战略、评估、生产控制,以及何时值得等待更好的模型。
 15:32EN → 简体中文AI Engineer· 2026年11月5日Emil Chetty:让支付智能体在客户授权的范围内行动Emil Chetty · WiseWise 数据与 AI 产品负责人介绍如何用不可变的任务协议,让智能体选择执行步骤,同时由可信支付服务执行客户授权。
 13:22EN → 简体中文AI Engineer· 2026年11月5日Brainbase 如何将竞品价格采集智能体的准确率从 41% 提升至 97%Milind Sunil Shah · BrainbaseMilind Sunil Shah 介绍一个通过迭代采集并评估竞品价格的后台智能体工作流程。
 14:15EN → 简体中文AI Engineer· 2026年11月4日Ramp 如何结合小模型、KV 缓存 Cartridge 和智能体集群Alexander Shevchenko · RampAlexander Shevchenko 介绍三个应用研究项目,讨论针对特定任务如何权衡延迟、成本、准确率和运维复杂度。
 15:12EN → 简体中文AI Engineer· 2026年11月4日Dillon Rolnick:AI 供应商锁定与开放智能体基础Dillon Rolnick · Nous ResearchNous Research 首席执行官主张企业保留对智能体技术栈的控制,并将自家 Hermes Agent 作为一种选择。
 19:12EN → 简体中文AI Engineer· 2026年11月4日AI 智能体为什么需要可靠流程才能在公司内推广Mitchell Troyanovsky · BasisBasis 联合创始人 Mitchell Troyanovsky 介绍行为规范、轨迹分叉和生产智能体模拟。