30 秒看懂
Nacho Martinez 解释模型外围构成智能体运行框架的组件,包括存储、记忆、上下文组装和工具执行。工作坊用合成银行交易说明智能体如何向人提示潜在反洗钱案件。 他讨论文件与数据库的权衡、检索、有界循环和可复用技能。演示不能证明生产准确率,标记也不是违法的证明。
- 1智能体技术栈工作坊关注模型外围的数据、记忆、工具和编排。
- 2共享状态文件和事务型数据库在并发方面各有权衡。
- 3记忆类别Martinez 区分情景、程序性和语义信息。
- 4有界智能体循环示例在限制内组装上下文、调用模型并执行工具。
- 5按需检索技能技能箱搜索相关能力,而不是加载全部内容。
- 6人工审查模拟反洗钱系统标记活动,而不是自动封锁账户。
要点建议
- 运行框架控制模型外围的上下文、工具和记忆。
- 根据并发与数据需求选择文件或事务型存储。
- 检索相关记忆和能力,不应假设所有内容都能放入上下文。
- 限制智能体循环,并对有重大后果的行动强制执行审批。
- 模拟反洗钱标记是调查线索,不是自动结论。
- 在实际应用中评估检索和保护措施。
按章节阅读整理后的全文
工作坊与智能体技术栈
Martinez 介绍模拟银行和运行框架组件。
Nacho Martinez 介绍一场关于智能体运行框架的实践工作坊。示例是一家模拟银行,智能体分析交易并标记供人工审查的案件。
Martinez 是 AI 开发者布道师和数据科学家。他计划介绍智能体技术栈、记忆、上下文工程,以及运行框架如何包围模型。
他用反洗钱作为例题。银行可能遇到大量需要调查的交易;标记应该触发审查,而不能当作违法的证明。
长时间运行的智能体需要的不只是一次模型调用:应用还要管理上下文、工具和存储的信息。Martinez 认为这些外围组件是工程师值得实验的地方。
他的虚构示例包含多种可疑交易模式。目标是向银行员工提示可能的问题,再由他们调查。
他把智能体技术栈分成应用、数据、模型、基础设施和计算资源。工作坊关注应用开发者可控制的数据和编排组件。
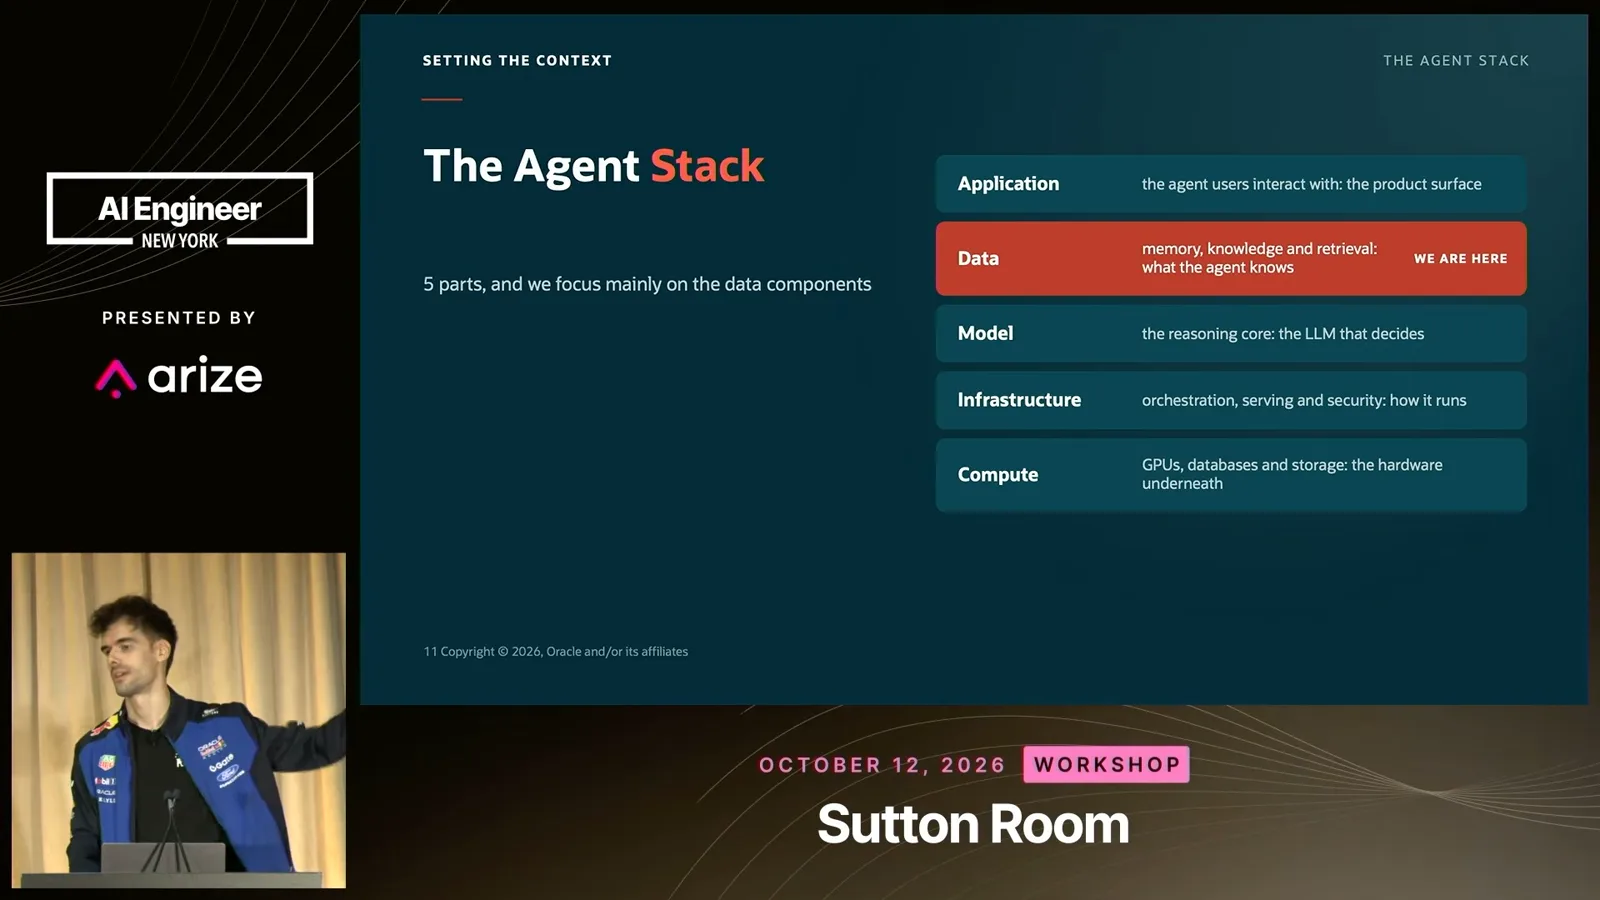
数据层包括智能体循环、外部数据连接、记忆、上下文管理、工具和技能。这些组件决定每一步可以使用哪些信息和能力。
Martinez 区分聊天机器人、检索应用、固定工作流和智能体。他认为现代智能体系统往往结合自动化与一定程度的自主性。
他用人作类比:模型负责推理,工具让系统行动,存储的信息支持回忆。这只是组织组件的方式,并非声称系统像人一样思考。
他把周围的支撑结构称为运行框架。记忆、输入和工具的不同选择可能改变同一模型在任务上的表现,因此也应评估整个外围系统。
设计选择包括存储、检索、记忆类别、智能体循环和上下文组装。合适的安排取决于应用要做什么以及需要保留什么证据。
存储、记忆与上下文
他比较文件与数据库,并介绍记忆类别。
谈到文件与数据库,Martinez 建议按问题选择。文件适合非结构化材料;数据库可以为共享状态提供事务和并发控制。
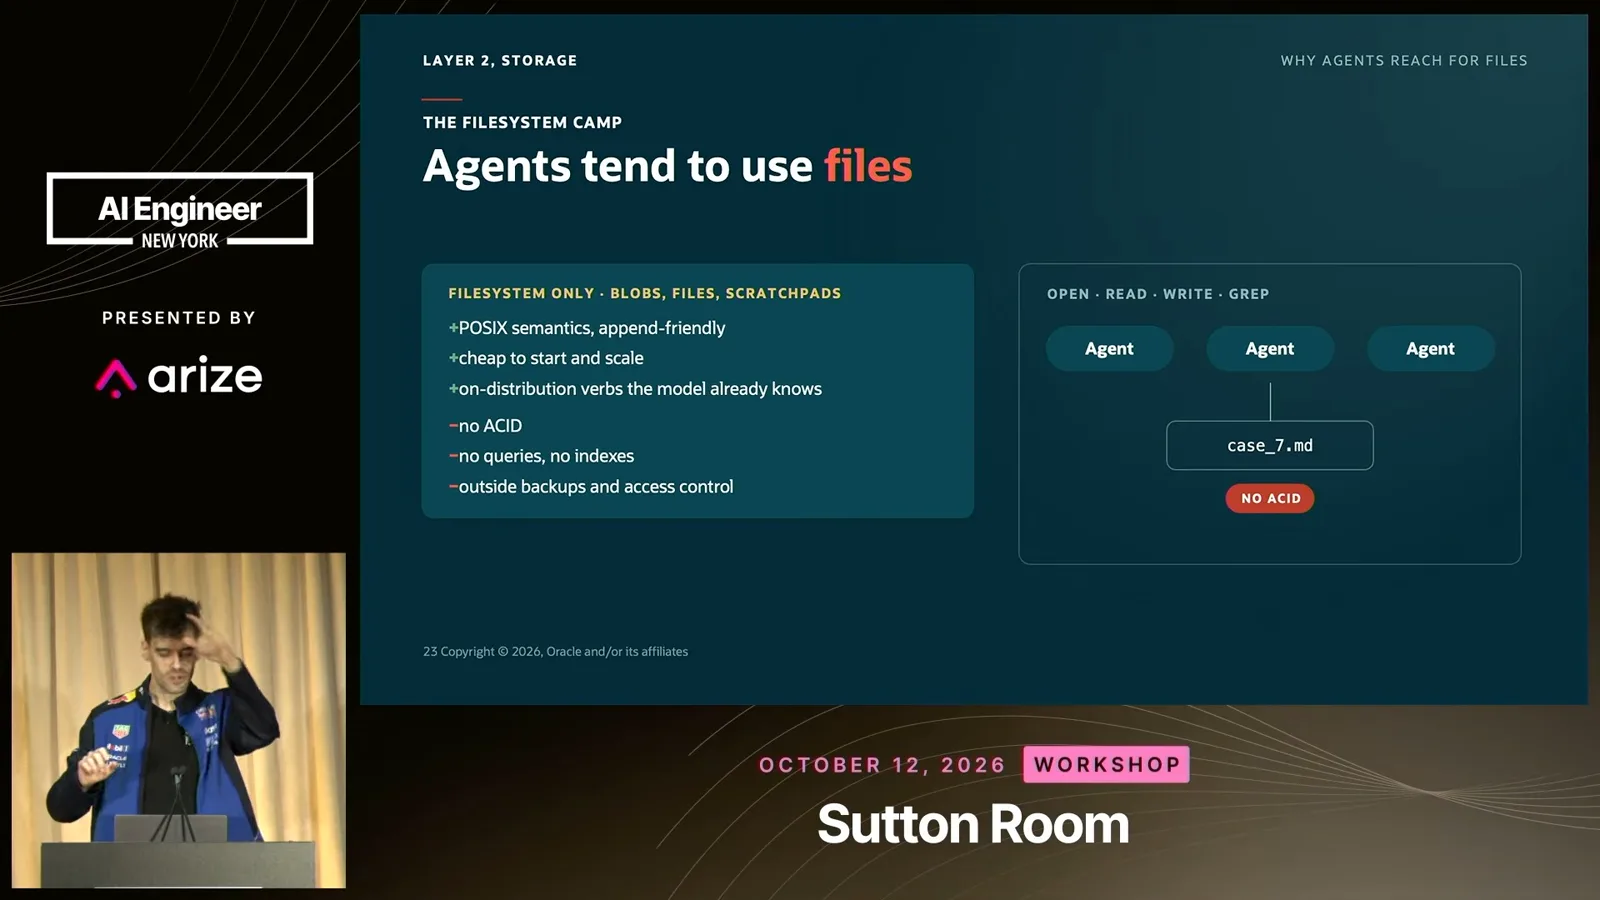
多个智能体同时写同一文件可能出现冲突。worktree 在某些开发工作流中可以隔离修改;事务型存储则提供另一种协调共享写入的方式。
记忆设计包括决定保存什么、如何整理,以及何时检索。Martinez 区分单次对话中的短期上下文和对话结束后保留的信息。
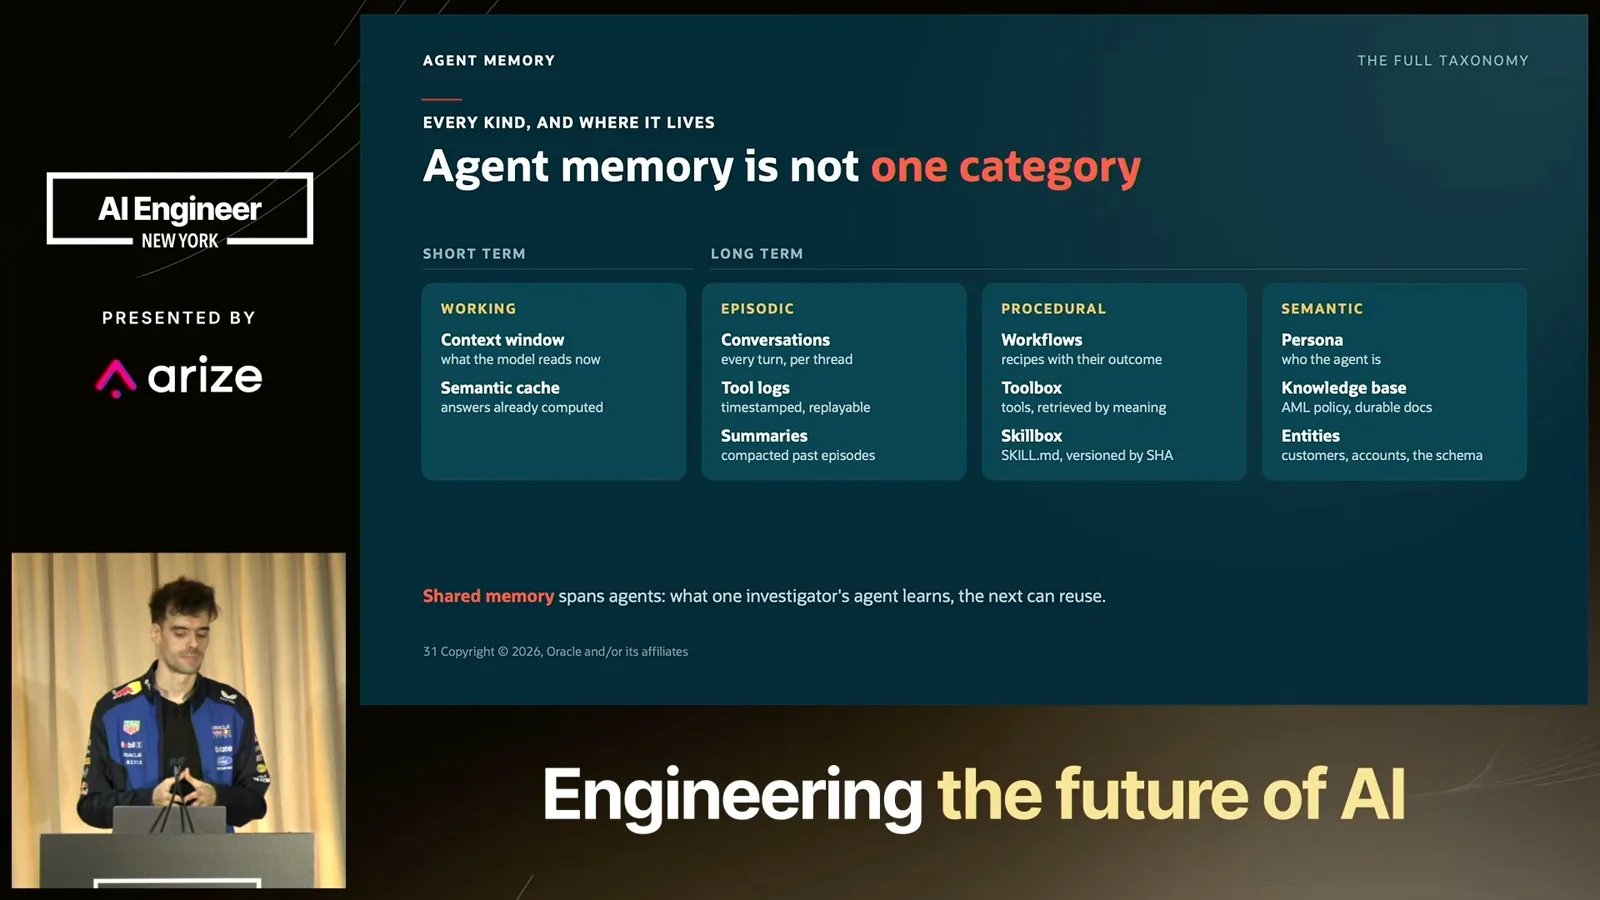
他提出的长期记忆类别包括:对话和工具日志等情景历史;技能和工作流等程序性记忆;以及偏好和领域知识等语义信息。
上下文窗口有大小限制,长历史也可能让相关信息更难利用。影响因模型和任务而异;如果较短上下文遗漏必要证据,就不一定更好。
摘要可以在后续轮次前压缩对话。另一种方法把材料保存在当前上下文之外,需要时再取回;两种方法都可能丢失或漏取重要细节。
智能体循环与技能
他讨论有界执行和检索相关能力。
智能体循环从对话、文件、数据库、工具和技能组装上下文,调用模型、执行行动并吸收结果。工作坊中的循环有次数和时间上限。
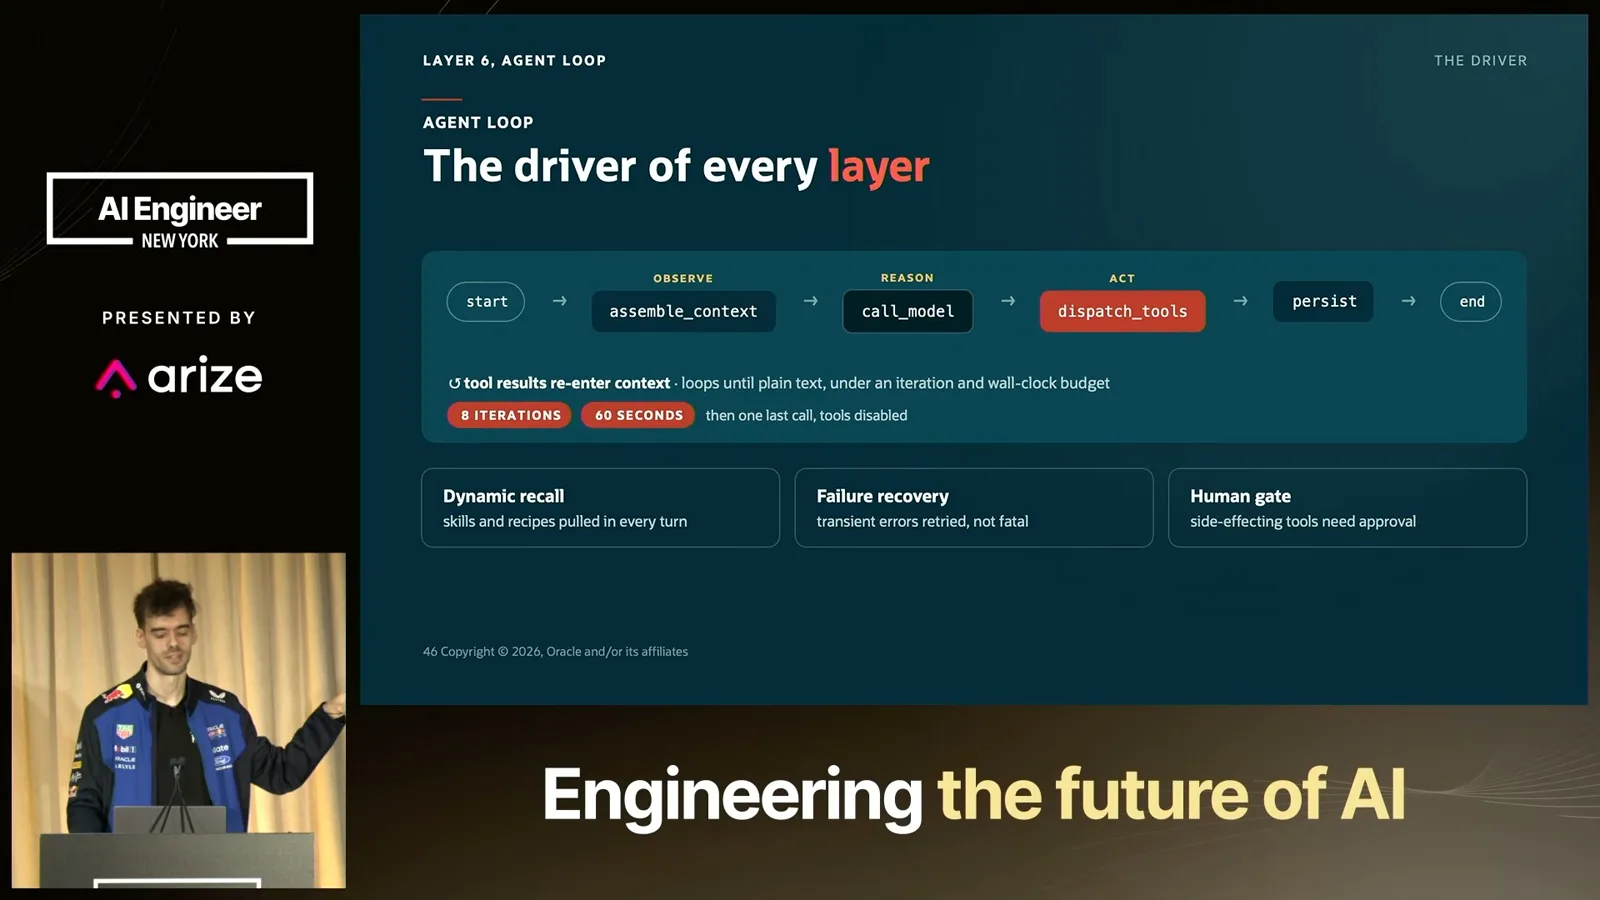
示例最多运行八轮并设置时间预算。幻灯片还展示有副作用的工具需要人工批准;实际控制必须由应用强制执行。
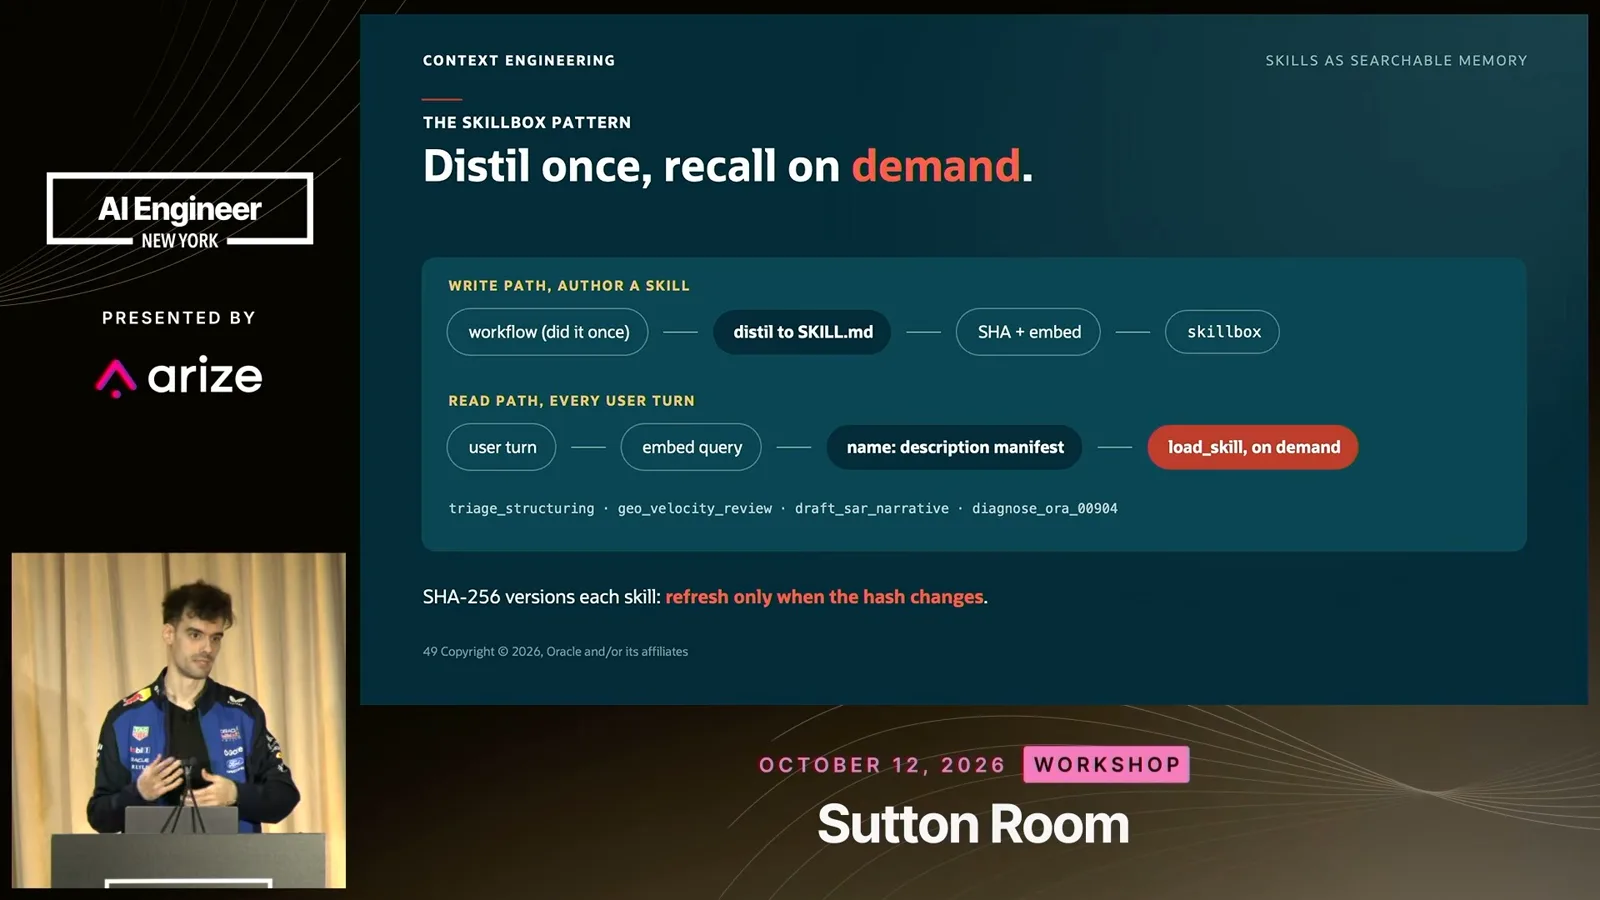
把所有可用技能和工具放进每个请求,可能占用大量上下文。Martinez 提出工具箱和技能箱:为描述建立索引,按当前任务检索相关项目。
向量相似度可以帮助找到候选工具或技能,再由智能体加载选中的材料。检索并不完美,因此需要针对应用测试选择和结果。
他把成功运行整理成可复用指令称为技能蒸馏。例如,团队可以把前端工作流和偏好写入技能文件,供之后使用。
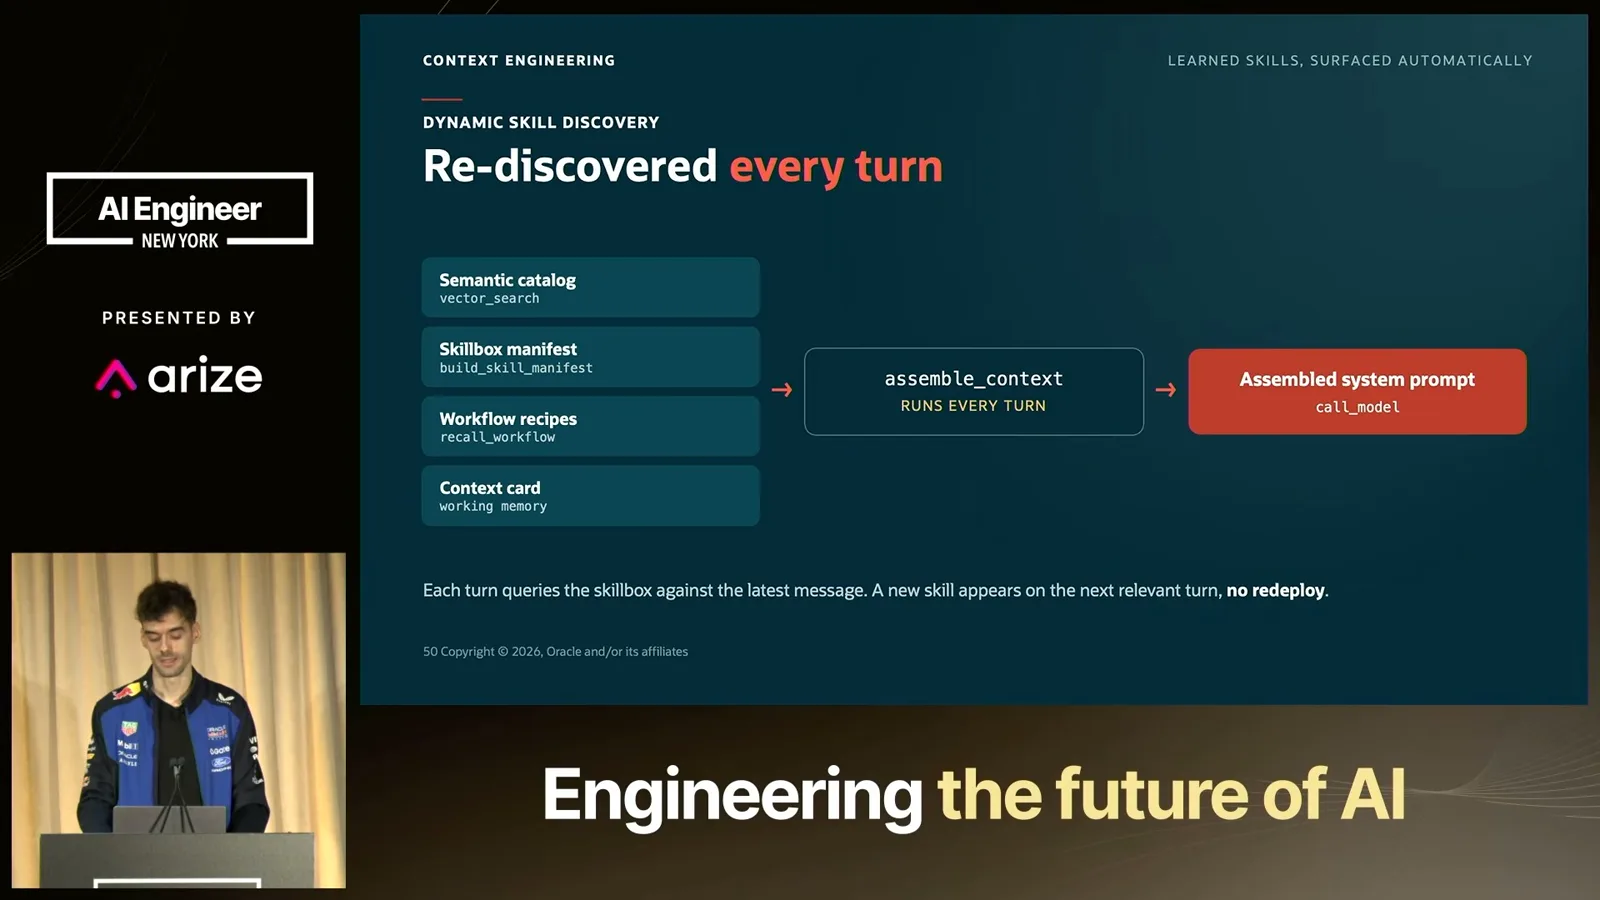
动态发现机制可以在相关请求到来时检索该技能。这会改变提供给模型的信息,但本身不会改变模型权重。
Martinez 将外部记忆与检索,与修改模型参数或嵌入表示作比较。工作坊重点是外部数据方法,其他技术则是独立的选择。
他讨论指令层级也是上下文设计的一部分:系统与应用指令、用户请求、工具或检索内容扮演不同角色。具体行为取决于模型和平台。
模拟反洗钱应用
演示标记合成交易,供人工审查。
反洗钱演示旨在标记活动,供人之后检查。Martinez 强调不能仅凭自动产生的怀疑就封锁账户,因为错误行动可能严重影响个人。
应用展示合成交易流,其中一些正常、一些被标记,并提供智能体上下文和存储数据的视图。工作坊只是演示,不能证明生产环境中的效果。
智能体检索可用知识并使用工具,为可疑活动分析整理证据。真实部署需要与具体场景相适应的验证、访问控制和人工审查。
参与者在 notebook 中查看组件并完成练习。Martinez 展示模型连接和数据库设置,然后邀请大家就记忆架构提问。
检索与设计问答
他回答记忆、工具、混合检索和定制框架的问题。
被问及情景记忆会否让智能体混淆旧对话时,他说架构和检索决定取回哪些内容。分离有助于组织信息,但不会自动消除冲突。
他讨论为第三方技能或工具的描述建立向量索引,使循环无需加载全部内容就能选择候选项。外部能力仍需要考虑访问权限和可信度。
他还讨论上下文和缓存成本。实际请求大小与缓存行为会因提供商、配置和工作负载而异,演示数字不应视为通用规律。
在工作坊中,上下文组装从不同向量库各检索有限数量的相关工具和技能。示例默认使用三个候选项。
重排序器可以进一步排列候选项,或在只需一个项目时帮助减少加载数量。Martinez 把它作为可选改进,而不是演示中已经使用的组件。
对于记忆,他建议从简单设计开始:保留当前上下文和长期存储,在信息值得保留时将其提升到长期记忆。有需要时再增加更细的类别。
循环可以在推理前检索已存记忆,依据相关性或相似度阈值选择。阈值与索引需要评估,因为可能漏掉相关上下文或返回无关内容。
他讨论通过 MCP 和预先编写的查询开放已知数据库操作。限制可用操作可能有帮助,但不能免除授权和输入验证。
关键词检索和语义检索各有优势。Martinez 介绍混合检索和排名融合;实际质量取决于数据、查询和评估。
他说定制运行框架不必复制完整的通用编码智能体。更小的框架可以围绕特定领域的数据、工具和约束设计。
不同问题需要不同预算和记忆策略。无人值守的长时间研究任务可能需要上下文管理,而本次演示把循环限制为八步。
Martinez 鼓励参与者完成 notebook 并提问。他说活动后也可以继续探索工作坊环境,具体以实际可用情况和条款为准。
同频道的其他文章
 21:32EN → 简体中文
 AI Engineer· 2026年10月29日Shy Ruparel:AI 智能体的可靠性与故障恢复Shy Ruparel · TemporalTemporal 的调查发现,频繁使用智能体与可靠部署之间存在差距。Ruparel 演示了一项模拟付款工作流如何在工作进程停止后恢复。
 14:50EN → 简体中文AI Engineer· 2026年10月29日Cole Gannaway:代码审查、跨仓库风险与 AI 软件工厂Cole Gannaway · Qodo一行重命名代码可能通过本地检查,却影响远端客户端。Qodo 的 Cole Gannaway 解释如何借助审查上下文、共享规则和独立智能体发现这些风险。
 11:47EN → 简体中文AI Engineer· 2026年10月29日Revolut 的 David Abitbol:大规模自托管 AI 编程模型David Abitbol · RevolutAbitbol 分享工程交付趋势、GPU 服务成本和延迟调优经验,并介绍受监管银行运行这些工具时采用的控制措施。
 16:34EN → 简体中文AI Engineer· 2026年10月29日Tariq Shaukat:如何对 AI 生成的代码建立信心Tariq Shaukat · SonarSonar 首席执行官借鉴制造业的质量管理实践,提出治理和验证编码智能体所产出软件的方法。
 21:47EN → 简体中文AI Engineer· 2026年10月28日Patrick Smyth:AI 时代的开源供应链安全Patrick Smyth · ChainguardChainguard 的 Patrick Smyth 讨论漏洞利用加速、依赖中的恶意软件、零日漏洞,以及开发者工作流不断扩大的攻击面。
 14:09EN → 简体中文AI Engineer· 2026年10月28日Taylor Luttrell-Williams:用 SonarQube Hunter Agent 发现逻辑漏洞Taylor Luttrell-Williams · SonarSonar 的 Taylor Luttrell-Williams 介绍安全智能体如何梳理代码库、调查逻辑漏洞,并将验证过的发现与常规扫描结果一起呈现。