30 秒看懂
Jane Street 软件工程师 Tudor Brindus 通过一个简单的进程间通信基准测试研究抖动。他利用测量和处理器追踪定位延迟来源,再逐步调整操作系统和应用程序。 这个实验展示了速度、确定性和稳定性之间的取舍,也说明了低噪声测量为何有助于团队发现性能退化。
- 1从分布入手虚拟化环境中的乒乓基准测试中位延迟为 637 纳秒,异常值达到约 16 微秒。延迟图表说明了为什么单个平均值不够。
- 2转向裸机在没有虚拟机的环境中运行相同代码,中位延迟降至 223 纳秒,大部分噪声也随之消失。
- 3追踪罕见事件Magic Trace 利用 Intel Processor Trace 捕获缓慢往返过程中的控制流。追踪先后揭示了网络中断和定时器中断。
- 4隔离核心并减少定时器滴答隔离核心和减少周期性滴答进一步降低了中位延迟,但需要显式指定进程运行位置。
- 5以速度换取确定性本次测试中,关闭睿频消除了频率切换带来的抖动,但中位延迟略有增加。
- 6改进自旋循环加入一条 x86 pause 指令后,错误推测从 8% 降至 1%,中位延迟减少了 8 纳秒。
要点建议
- 延迟敏感的系统需要测量处理时间的分布和尾部,而不只是中位数。
- 在本次实验中,裸机运行基准测试消除了大量虚拟化开销和噪声。
- 处理器追踪可以发现普通采样分析器遗漏的罕见事件,包括网络和定时器中断。
- 隔离核心、减少定时器滴答和关闭睿频可以提高确定性,但需要权衡。
- 自旋循环中的 pause 指令减少了错误推测,改善了基准测试结果。
- 硬件选择会影响性能,但激进超频可能损害计算的正确性。
按章节阅读整理后的全文
抖动为什么重要
Brindus 介绍了对延迟敏感的市场数据,以及处理过程可预测的必要性。他建立了一个小型进程间通信基准测试。
我在 Jane Street 的超低延迟交易团队工作,涉及高速软件、硬件和分析工具。一个反复出现的问题是抖动,也就是处理时间的变化。在交易中,市场数据的到达速度可能达到每秒约 1 GB,具体取决于交易所;即使数据只过时了 10 微秒,也可能导致糟糕的交易。
Jane Street 使用 OCaml。在我描述的环境中,它的运行时基本上是单线程的。异步调度器可以将阻塞系统调用派给线程池,但并行执行代码需要多个进程。因此,同一台机器上进程之间的数据传递是一个值得研究的例子。
环形缓冲区乒乓基准测试
两个进程通过环形缓冲区交换不断递增的整数。测试在 Cascade Lake 服务器上测量往返延迟。
环形缓冲区可以看作由固定大小单元组成的数组:读写到末尾后就回到开头。我们在两个进程之间建立两个缓冲区,每个方向一个,用它们进行一场永不停歇的乒乓游戏。
pinger 写入整数 1;ponger 读取它,加一后返回 2。pinger 再读取这个数,加一并将 3 写入下一个单元。这个循环在缓冲区中持续进行。我测量的是 pinger 写入一个值到收到相应回复之间的时间。
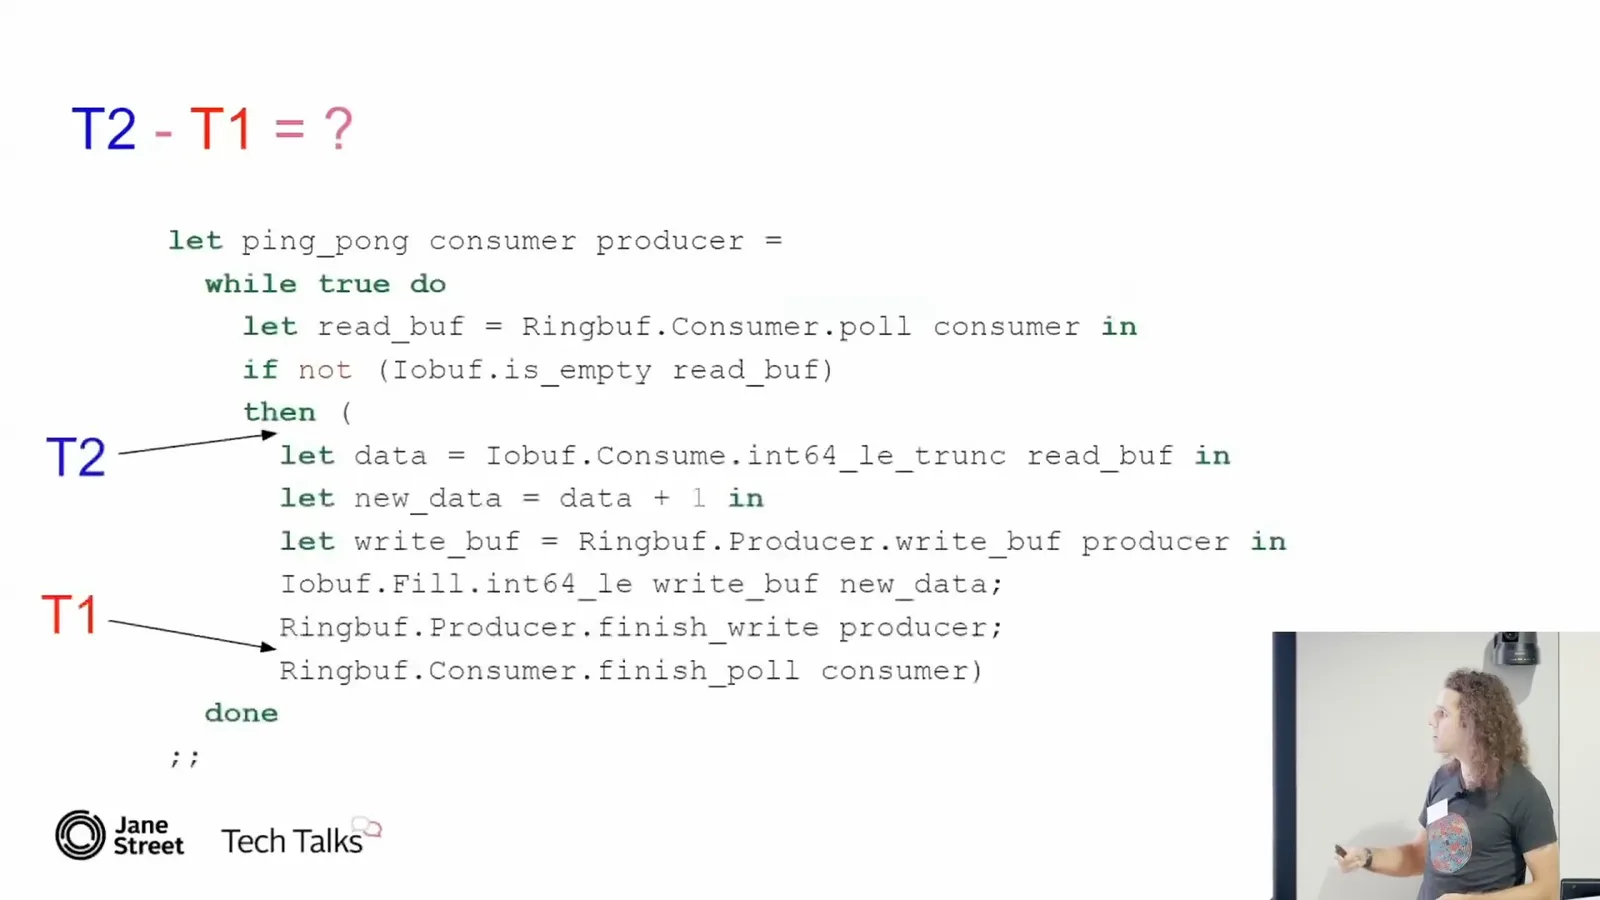
基准测试运行在一台主频为 3.6 GHz 的第二代 Intel Cascade Lake 服务器上。最初使用虚拟化环境,中位往返延迟为 637 纳秒,但抖动延伸到约 16 微秒:对于如此少的工作来说,差距相当大。
虚拟机与裸机
最初的延迟分布中位数为 637 纳秒,并有明显长尾。在裸机上运行相同代码后,中位数降至 223 纳秒。
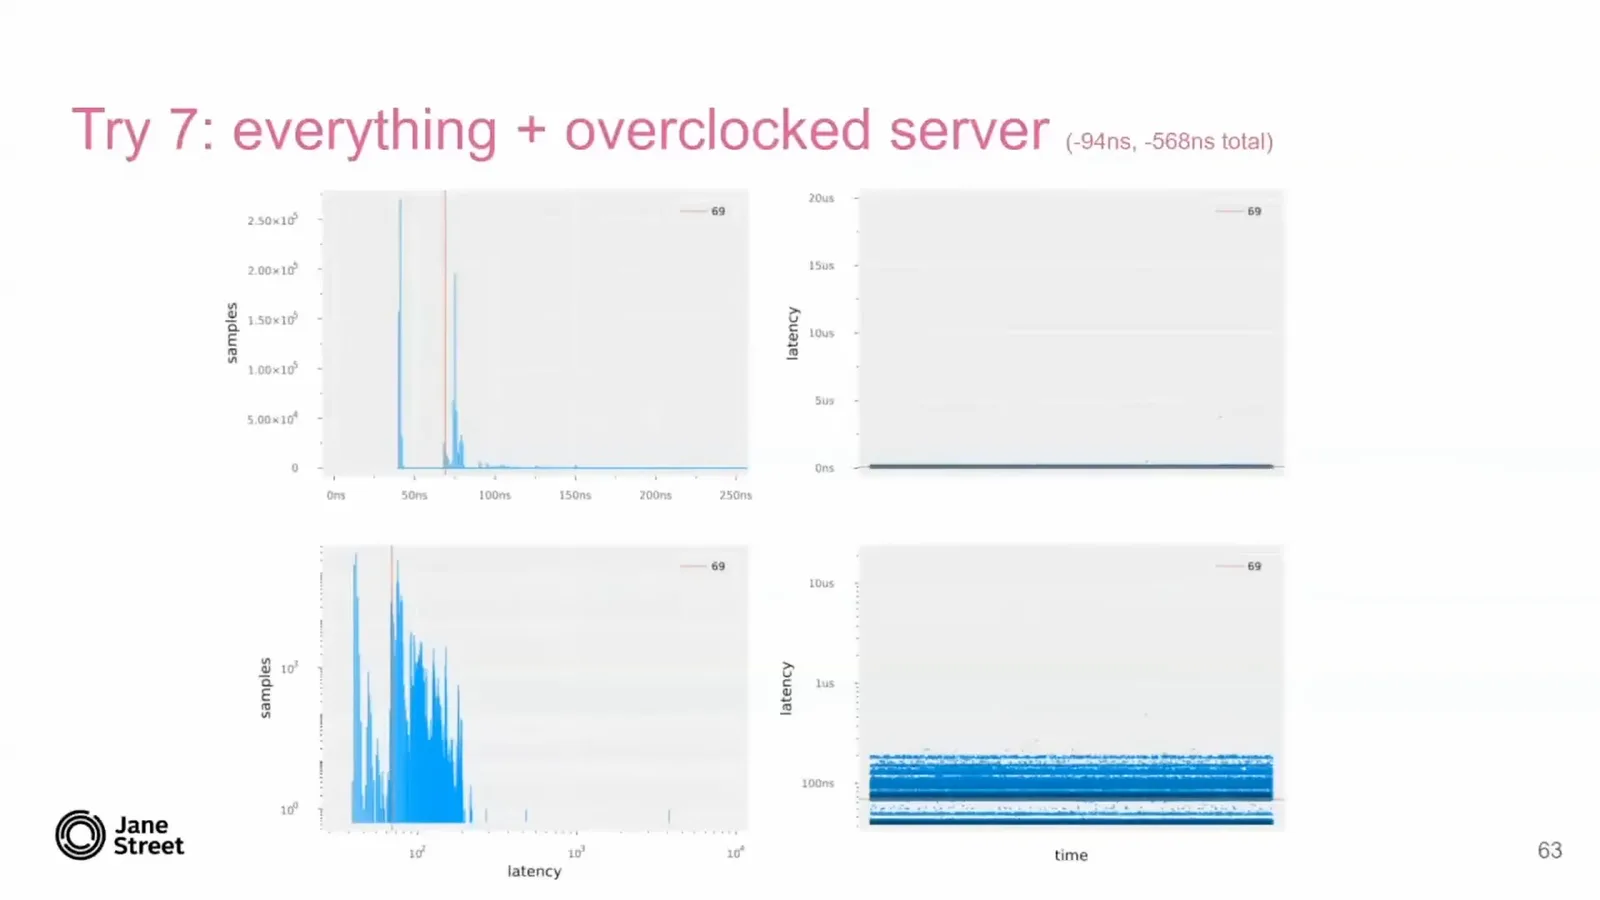
图表左侧是直方图,右侧是随时间变化的采样点。上方图表使用线性刻度,下方使用对数刻度;随着噪声减少,后者会变得更有用。橙线标示中位数。
虚拟机可能受到同一物理主机上“吵闹邻居”的影响,也可能有其他虚拟化开销。我没有诊断这个复杂的层次,而是在裸机上运行相同代码。中位数减少了 414 纳秒,降至 223 纳秒,大部分噪声也消失了,但仍有约 1 微秒处的密集区域和更长的尾部。
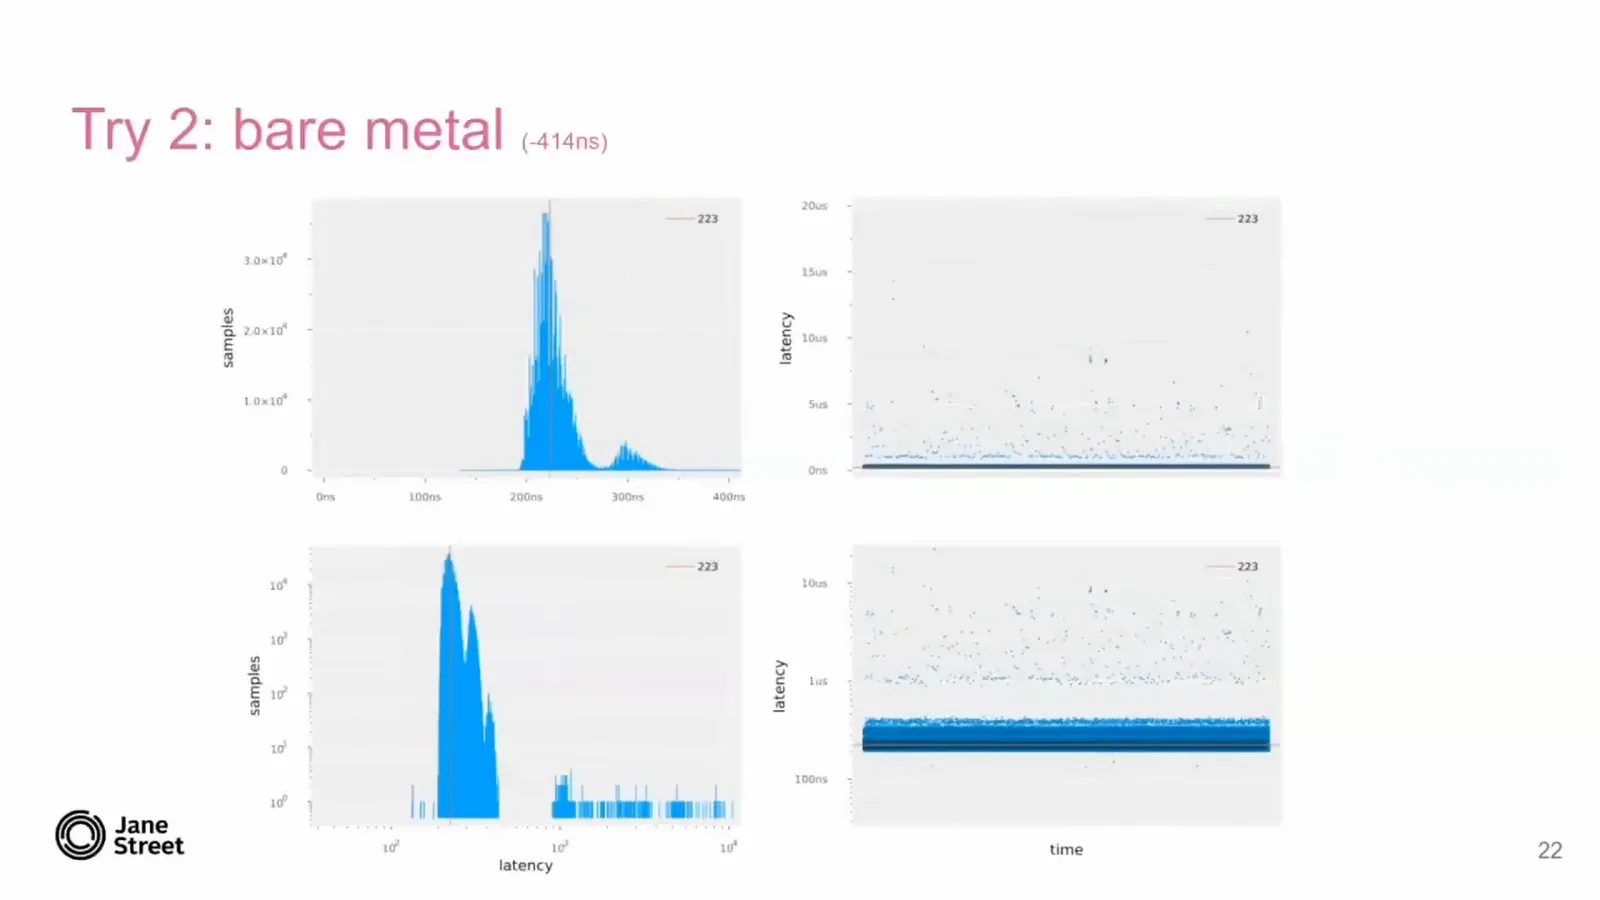
perf 或 VTune 等采样分析器主要报告进程在自旋等待对方。这没有错,却不能解释罕见的缓慢事件。我们的交易系统也有类似特征:它们大部分时间都在等待市场数据,真正值得关注的活动并不频繁。
追踪罕见的延迟事件
Brindus 解释 Intel Processor Trace 和 Magic Trace。捕获缓慢的往返过程后,他发现一个不进行网络通信的程序受到了网络中断。
Intel Processor Trace 以压缩形式记录分支、调用和返回等控制流转移。对于条件分支,它可以用一位记录是否跳转;有了起始指令指针和反汇编器,就能重建执行路径。当感兴趣的事件发生时,可以为固定大小的环形追踪缓冲区拍摄快照。
Jane Street 构建了 Magic Trace,用于解码和可视化这些信息。图表以调用栈深度为纵轴、时间为横轴,让我们能够放大到几纳秒的分辨率,检查事件前后发生的事情。
知道中位数后,我将超过 300 纳秒的往返定义为值得关注的事件。追踪显示正常整数交换过程中出现了尖峰。放大后发现内核中有网络活动,尽管这个应用只通过内存交换数据。
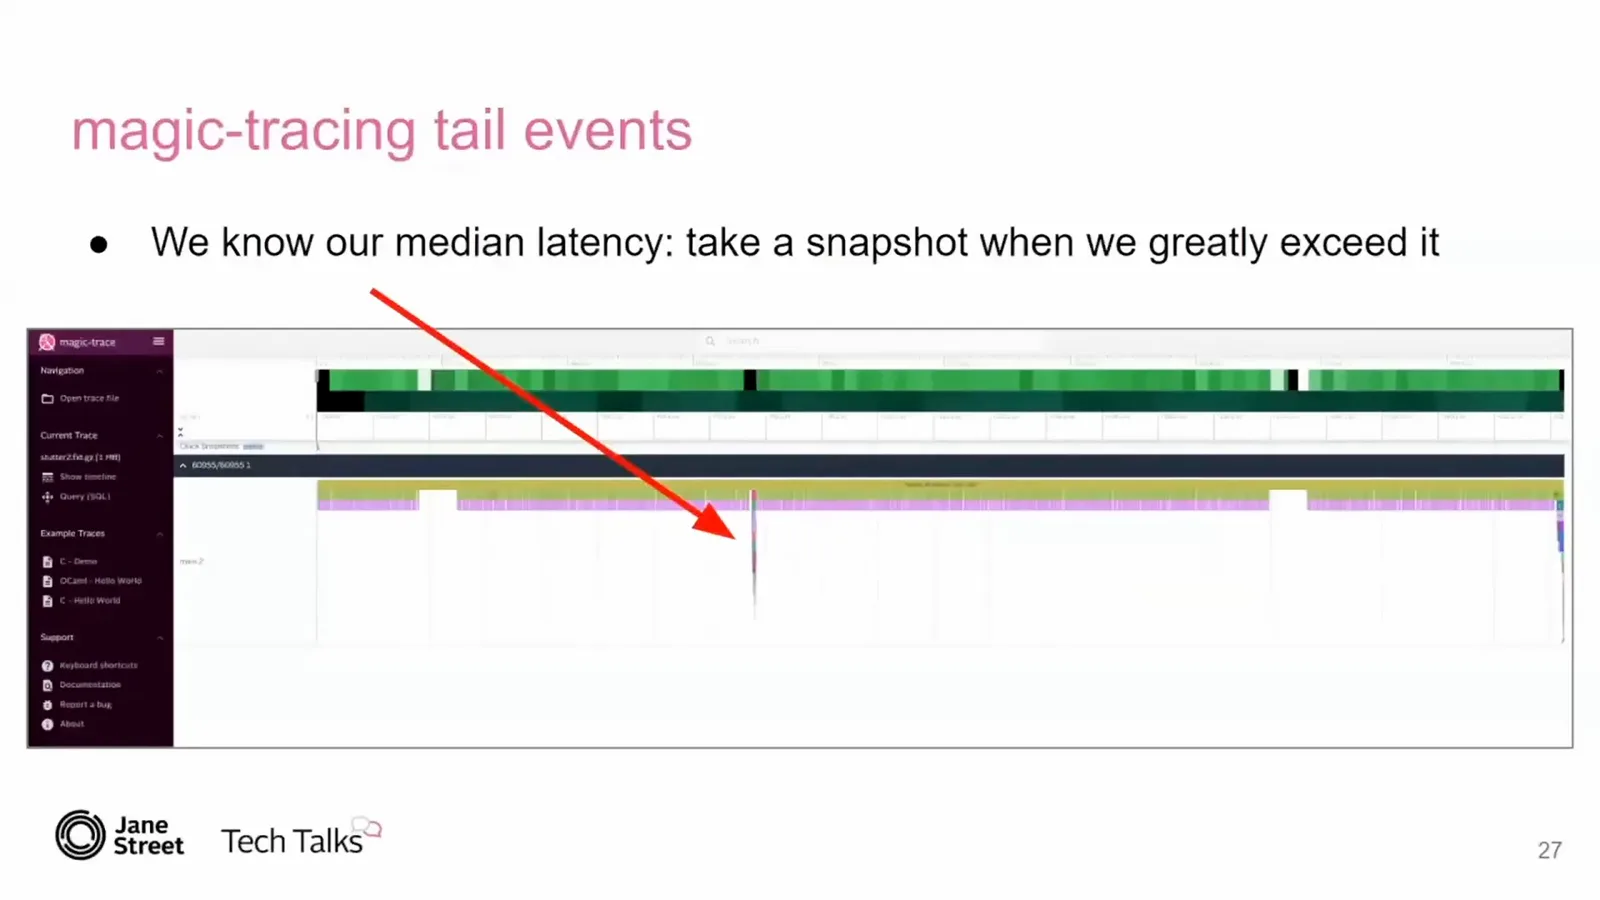
网卡收到数据包时会中断 CPU,让内核分发数据包。为了负载均衡,中断通常分布在各个核心上。这对于大量网络流量很合理,但也可能打断一个与网络毫无关系的应用。
隔离中断
核心隔离让网络中断远离基准测试,减少定时器滴答则消除了另一种抖动来源。每次调整都经过测量。
Linux 的 isolcpus 参数让我们留出特定核心,同时保留一些核心处理网络活动和远程访问。调度器不再自动把工作安排到隔离核心上,因此我们用 taskset 显式绑定 pinger 和 ponger。重启后,网络中断留在其他核心上,中位延迟再降 29 纳秒,达到 194 纳秒。
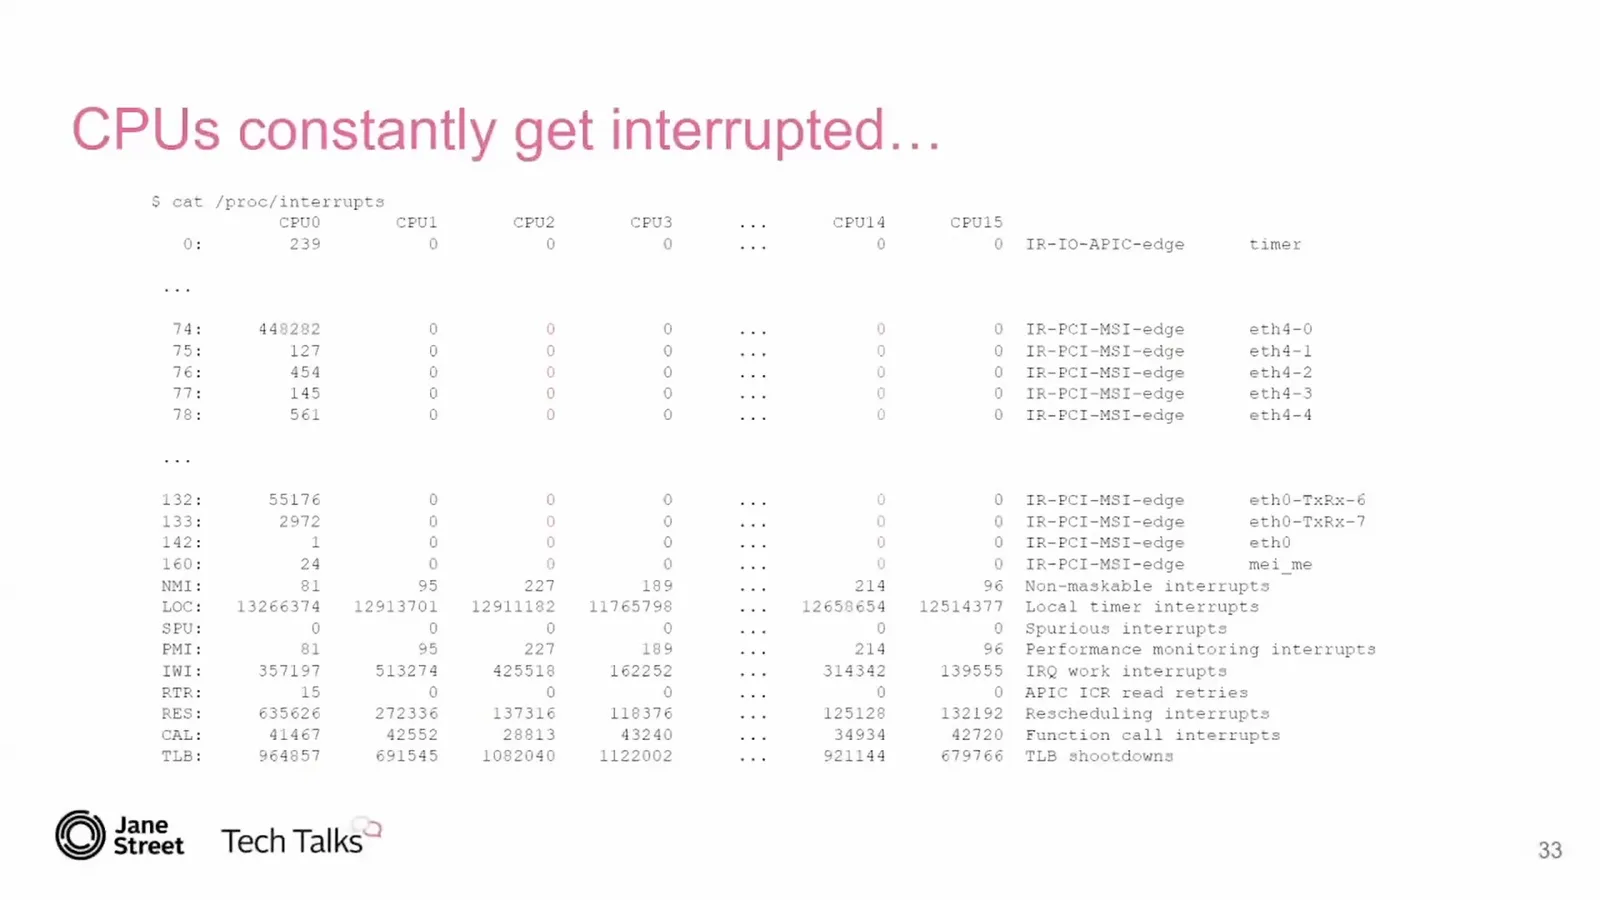
此时 1 微秒处的尾部更加突出。Magic Trace 揭示了一次 APIC 定时器中断,而 /proc/interrupts 显示了本地定时器中断的频率。内核传统上利用这些滴答考虑调度、更新统计信息,并在较老的 CPU 上协助管理频率。
当每个隔离核心只有一个可运行进程时,nohz_full 参数可以减少这些定时器滴答。内核仍需要更新一些统计信息,因此频率可以降到约每秒一次,而不是完全归零。这项调整又节省了 24 纳秒,基本消除了 1 微秒处的峰,但更长的尾部仍然存在。
此时 Magic Trace 不再显示明显的中断:同样的指令有时就是需要更长时间。这暗示原因可能在微架构层面。一个可能因素是睿频,它在处理器功耗限制内动态改变 CPU 频率。
睿频与推测执行
频率切换和推测执行引入了更多变化。Brindus 以睿频速度换取确定性,并在自旋循环中使用 pause 指令。
我们的 Cascade Lake 服务器基础频率为 3.6 GHz,能够通过 31 个可能的 P-state 提升至 4.4 GHz。频率切换需要时间。我怀疑延迟时间序列中的锯齿形模式反映了相邻状态之间的切换,而且一个方向比另一个方向更慢;这只是猜测,还不是确定的解释。
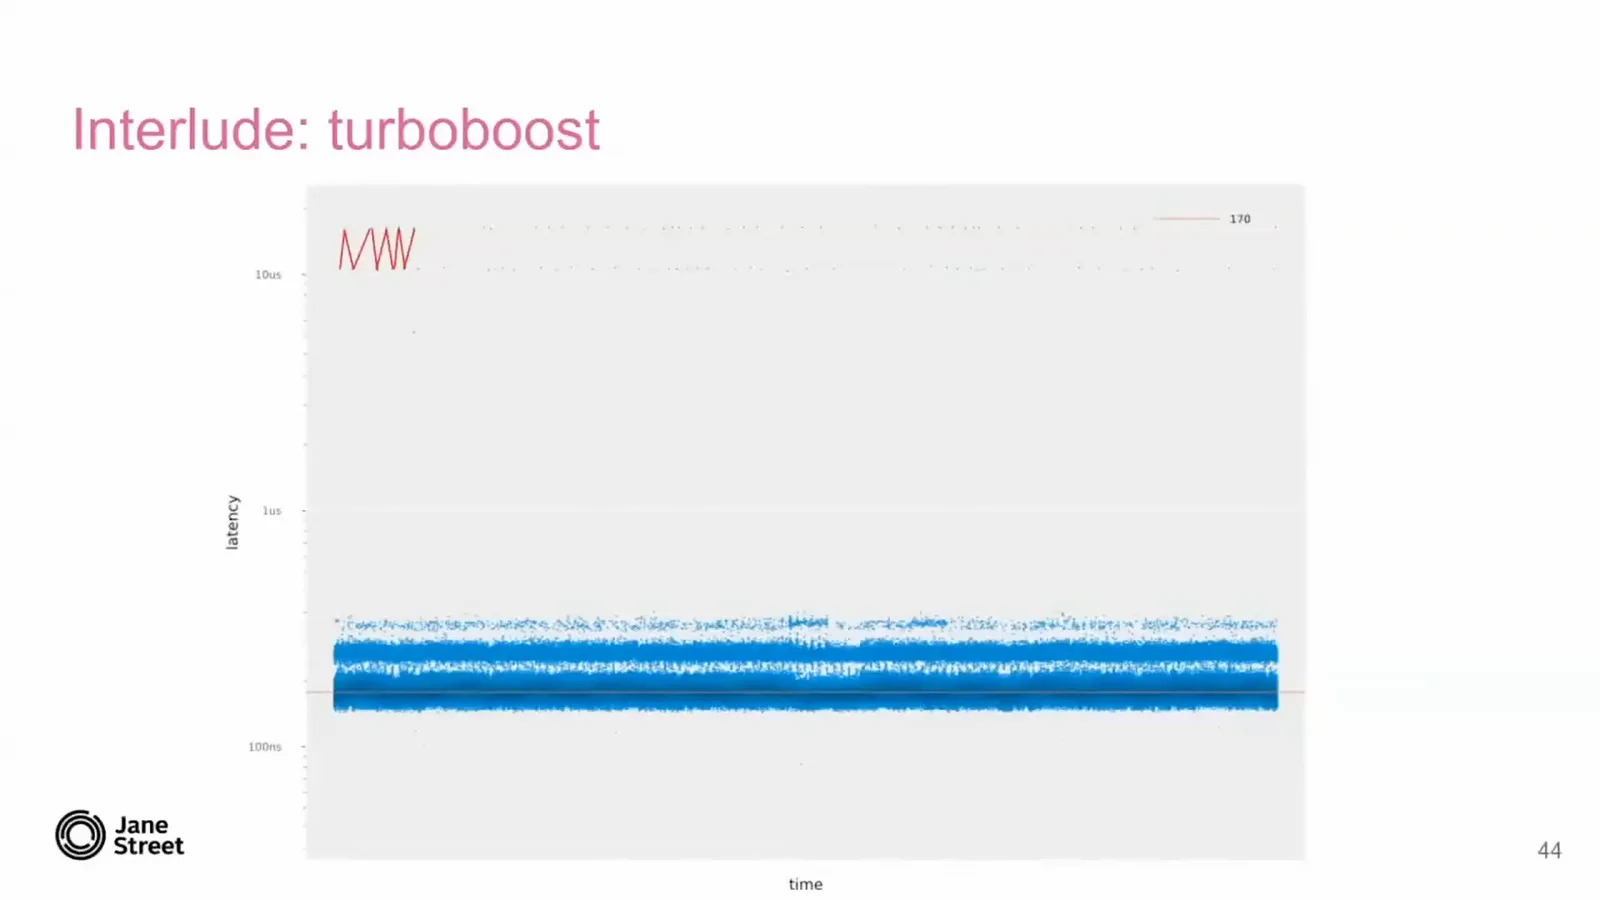
关闭睿频消除了这种抖动,但基准测试慢了 1 纳秒。我们选择了确定性而非速度,以 3.6 GHz 而不是接近 4.4 GHz 的频率运行。对于不只是递增一个数字的工作负载,频率差异的影响可能更加明显。
对数分布中还剩下三个峰。要理解另一个可能的来源,可以看看 CPU 速度与内存延迟之间的差距。如果处理器必须等待解引用后的内存操作数,就会严重停顿,因此设计者使用包括推测执行在内的技术来隐藏这段延迟。
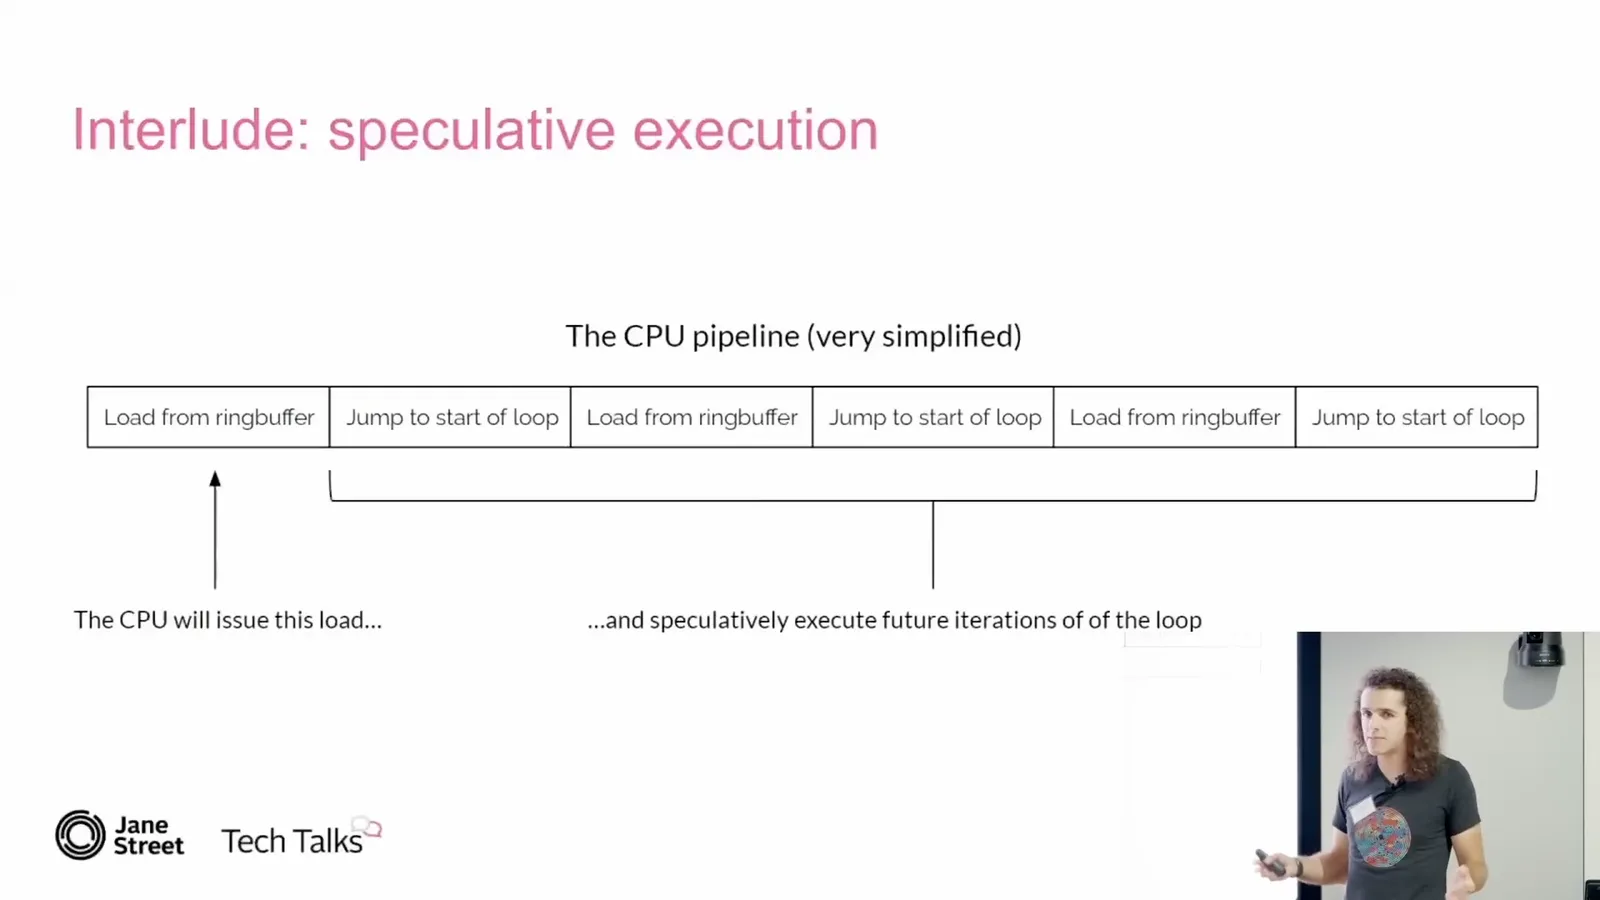
在我们的轮询循环中,环形缓冲区大部分时间是空的。CPU 学会预测下一次加载也没有数据,于是推测性地返回循环开头并发出更多加载。最终某次加载确实读到了数据;处理器必须丢弃错误的推测工作并恢复正确状态。
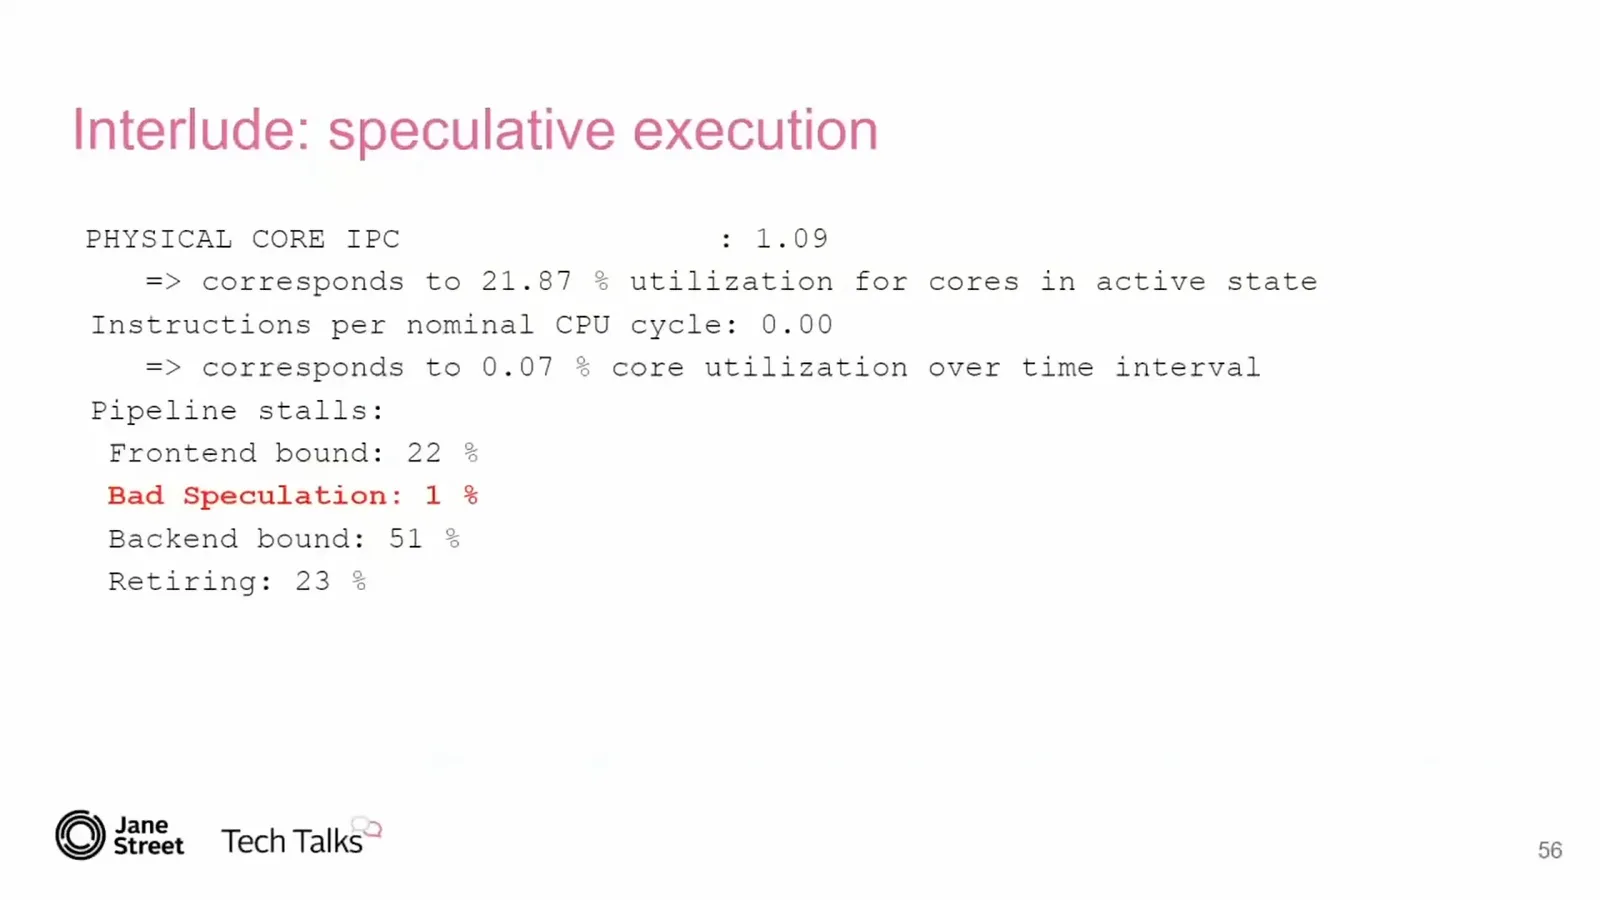
Intel 的 PCM 工具将观察到的流水线性能分解中 8% 归因于错误推测。其他类别占比更大,但我引用了 Intel 的优化建议:错误推测超过 1% 就值得关注。这个轮询循环类似自旋锁,而 x86 pause 指令正是为改善这种情况而设计的。
pause 指令提示处理器当前处于自旋等待循环,有助于避免退出循环时的性能损失。我们请编译器开发者提供一个能生成该指令的 OCaml 内建函数。只改动一行后,错误推测从 8% 降至 1%,中位延迟又减少了 8 纳秒。
三个峰大致合并成一个,虽然仍有一些样本落在我无法解释的较慢区间。在原有硬件上,我们已从抖动显著的 637 纳秒降到抖动小得多的 163 纳秒。对于如此小的代码改动,这是一项可观的改善。
硬件、权衡与测量
超频服务器改善了基准测试结果,但在真实工作负载下表现不稳定。Brindus 讨论了虚拟机、容器以及持续监测延迟尾部的价值。
如果使用更快的内存和超频 CPU,会怎样?基准测试又快了 94 纳秒,中位数降至 69 纳秒。但有一个重要前提:当我们在这台机器上尝试真实交易系统时,测试进行到一半机器就因内存损坏而崩溃。激进超频可能让结果又快又错。
如果性能和确定性很重要,就要考虑虚拟化的代价,并了解自己使用的环境。回答观众提问时,我指出 AWS 是信誉良好的服务商,但虚拟机仍可能出现抖动;它也提供裸机实例。较低端的服务商可能会超额分配硬件资源。
有人问到 Docker,我区分了裸机上的容器和基于虚拟机监控程序的虚拟机。Docker 使用内核命名空间,而 cgroup 资源统计会让与内核的交互略慢。对于避免系统调用的代码,我不预期它会带来同类额外虚拟化抖动。
理解底层架构可以释放可观的性能,硬件选择也很重要。最重要的是持续测量。当系统的延迟尾部已经充满噪声时,性能退化可能隐藏其中,直到严重恶化才被发现。
当中位延迟和 p99 延迟接近时,任何使 p99 急剧上升的新退化都更容易在测试中发现。对于重视确定性的系统来说,这样的状态更有利于稳定维护。
同频道的其他文章
 1:48:29EN → 简体中文
 1:05:45EN → 简体中文
 1:25:00EN → 简体中文
 1:16:29EN → 简体中文
 1:34:29EN → 简体中文
 1:34:36EN → 简体中文