30 秒看懂
AI Explained 在 OpenAI Deep Research 发布后不久进行测试,并在部分任务上与 DeepSeek R1 搜索和 Gemini Deep Research 比较。讲解者报告了有前景的检索能力和频繁错误,并讨论基准、浏览及对知识工作的不确定影响。
- 12025 年的初步评测讲解者在个人测试中比较三个早期研究工具。
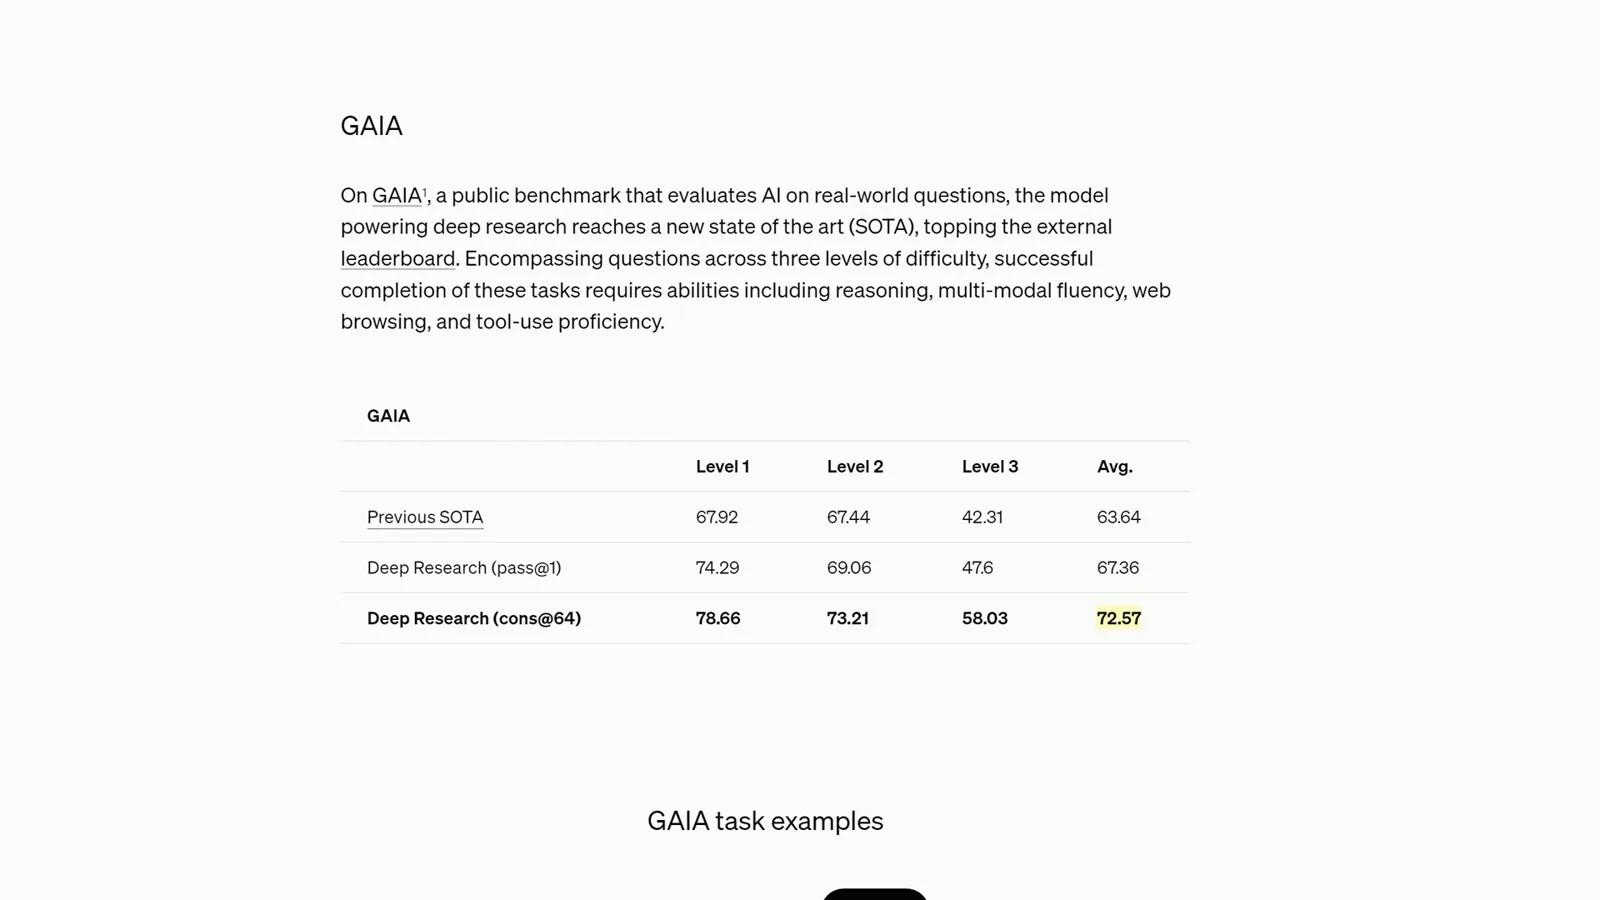
- 2GAIA 结果取决于设置视频区分首次回答和 64 次结果共识的成绩。
- 3检索有用,错误仍在新闻简报检索表现不错,但其他答案出现幻觉。
- 4核查引用来源关于 CodeElo 和购物价格的说法未通过讲解者的核查。
- 5未来预测仍不确定关于未来就业影响的讨论属于推测。
要点建议
- 讲解者在个人测试中比较三个早期研究工具。
- 视频区分首次回答和 64 次结果共识的成绩。
- 新闻简报检索表现不错,但其他答案出现幻觉。
- 关于 CodeElo 和购物价格的说法未通过讲解者的核查。
- 关于未来就业影响的讨论属于推测。
按章节阅读整理后的全文
早期基准与测试
讲解者介绍 Deep Research 并比较报告中的 GAIA 数据。
OpenAI 宣布 Deep Research 约 12 小时后,我用大约 20 个场景测试了它,并将部分结果与 DeepSeek R1 搜索及 Google 的 Gemini Deep Research 比较。这些是 2025 年 2 月的初步观察;使用权限、价格和产品可能发生变化。
OpenAI 称这个 agent 由 o3 提供支持。讲解者查看了 Humanity’s Last Exam,指出联网有助于回答冷门知识问题,同时提醒不要过度解读这个基准宏大的名称。
他认为 GAIA 更贴近日常,因为它包含研究和类似助理的任务。他引用的数据是 Deep Research 首次回答得分 67.36%,64 次结果取共识得分 72.57%;较早的 GAIA 论文报告人类 92%、带工具的 GPT-4 为 15%。这些数字来自不同的报告设置,并非讲解者自己进行的受控对照实验。
个人测试与检索
小规模推理测试与新闻简报检索展示出不同结果。
在自己设计的 SimpleBench 空间推理问题的小样本中,他没有看到明显改善,并说只测试了约八题。该 agent 经常反复提出多个澄清问题,有时在他拒绝回答后停止。他认为这种行为令人沮丧,同时承认澄清有时是有用的。
在一项新闻简报检索任务中,他要求系统找出达到指定评分的文章,并给出其中的“So What”部分。他说 OpenAI 的工具找到了两篇符合条件的文章,可能为他节省时间。在他的测试中,通过 Perplexity 使用的 R1 和 Gemini 工具没有找到同样的结果。
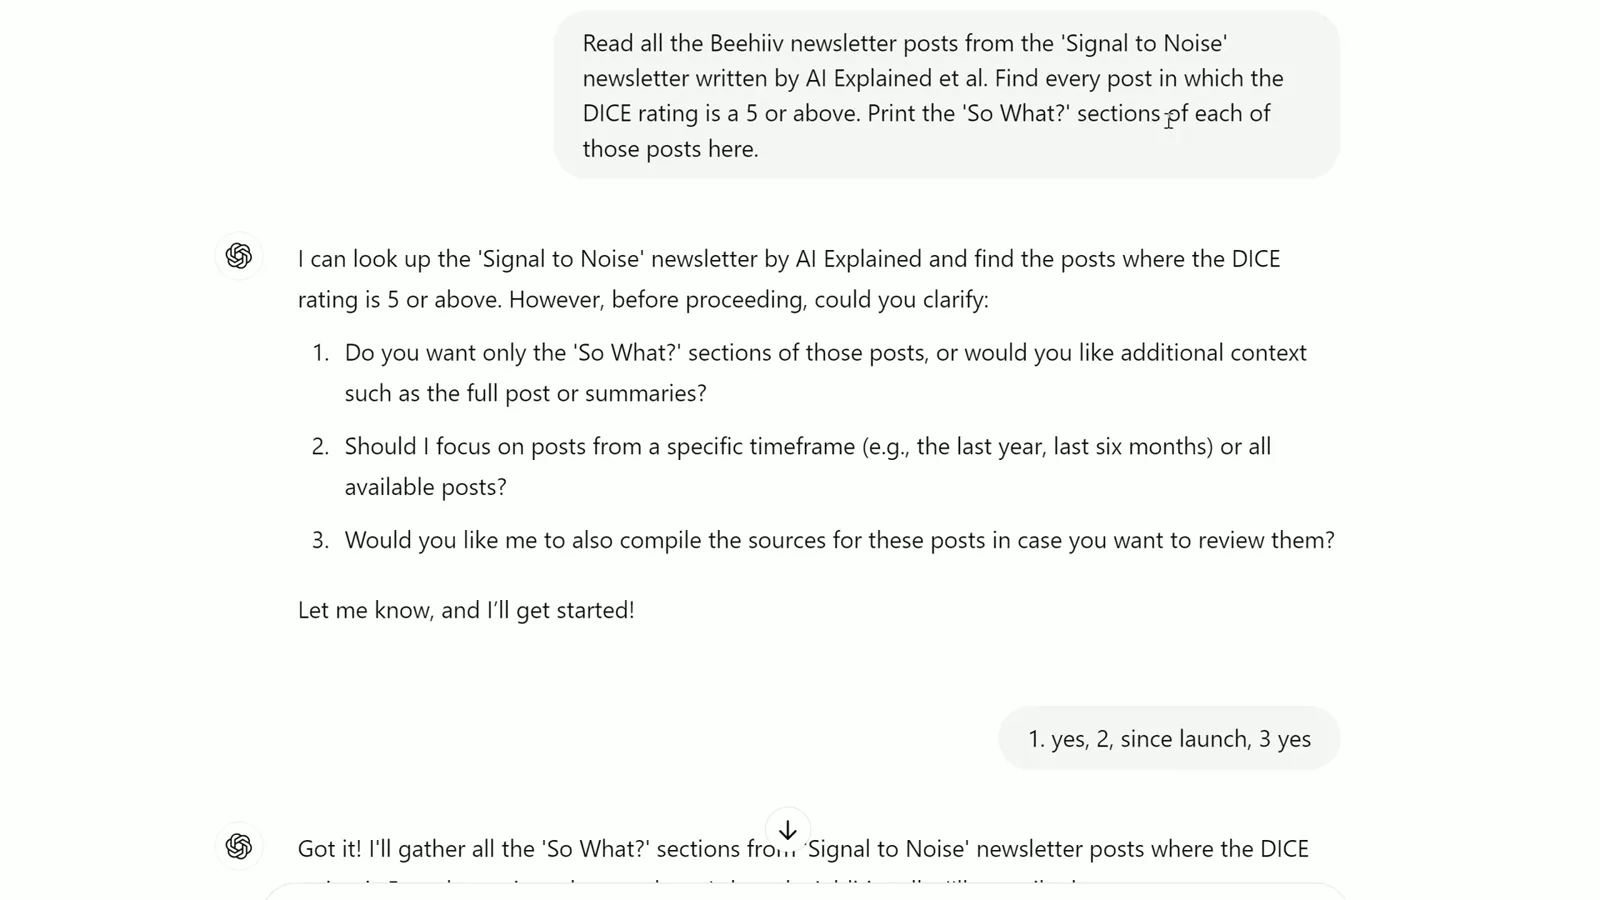
讲解者报告说,在他的困难研究问题中,Deep Research 总体表现更好,但他反复遇到幻觉。他还说,即使要求它不要再澄清,也不能总是阻止它继续提问或停止响应。
幻觉与来源核查
讲解者对照基准论文检查系统的说法。
其中一个任务是寻找人类成绩仍至少为最佳语言模型两倍的基准。Deep Research 找到了较冷门的 SimpleBench,却也列出 CodeElo,并称最佳模型接近人类参与者的末尾。讲解者核查论文后,发现这一说法与论文报告的结果不符。
他把这个工具比作在干草堆里找针,同时也会找到螺丝:如果用户能够区分有效发现和错误,它可以节省搜索时间。在一次短暂的 DeepSeek R1 搜索测试中,他也发现了关于幻觉基准缺乏依据或错误的说法。
语言与浏览任务
他介绍小规模语言测试、自己的原型及 YouTube 浏览限制。
对于 50 道关于一种克里奥尔语的问题,他报告 Deep Research 约得 88%,提供了相关词典的 GPT-4o 得 82%。这是个人的小规模测试,不是通用基准。他指出模型处理大量提供的上下文可能有困难,而研究 agent 可以在每个问题上使用更多计算。
他介绍了自己制作的原型:它生成研究方向、搜索更多背景信息,再综合成带引用的文章。他说 Deep Research 很快超越了这一工作流,这从他的角度体现了发展速度。
在他的测试中,Deep Research 无法直接浏览 YouTube。它仍然通过引用该视频的其他来源找到了相关视频,但无法可靠给出所需的时间戳。
购物与影响
购物错误引出了可靠性和潜在工作影响的讨论。
在一项购物任务中,工具找到了他购买的牙刷,但他说它声称使用了价格历史网站却没有引用该网站,给出的历史低价也不对。据他的测试,DeepSeek R1 搜索答案则编造了电池续航,并把假设价格写成事实。
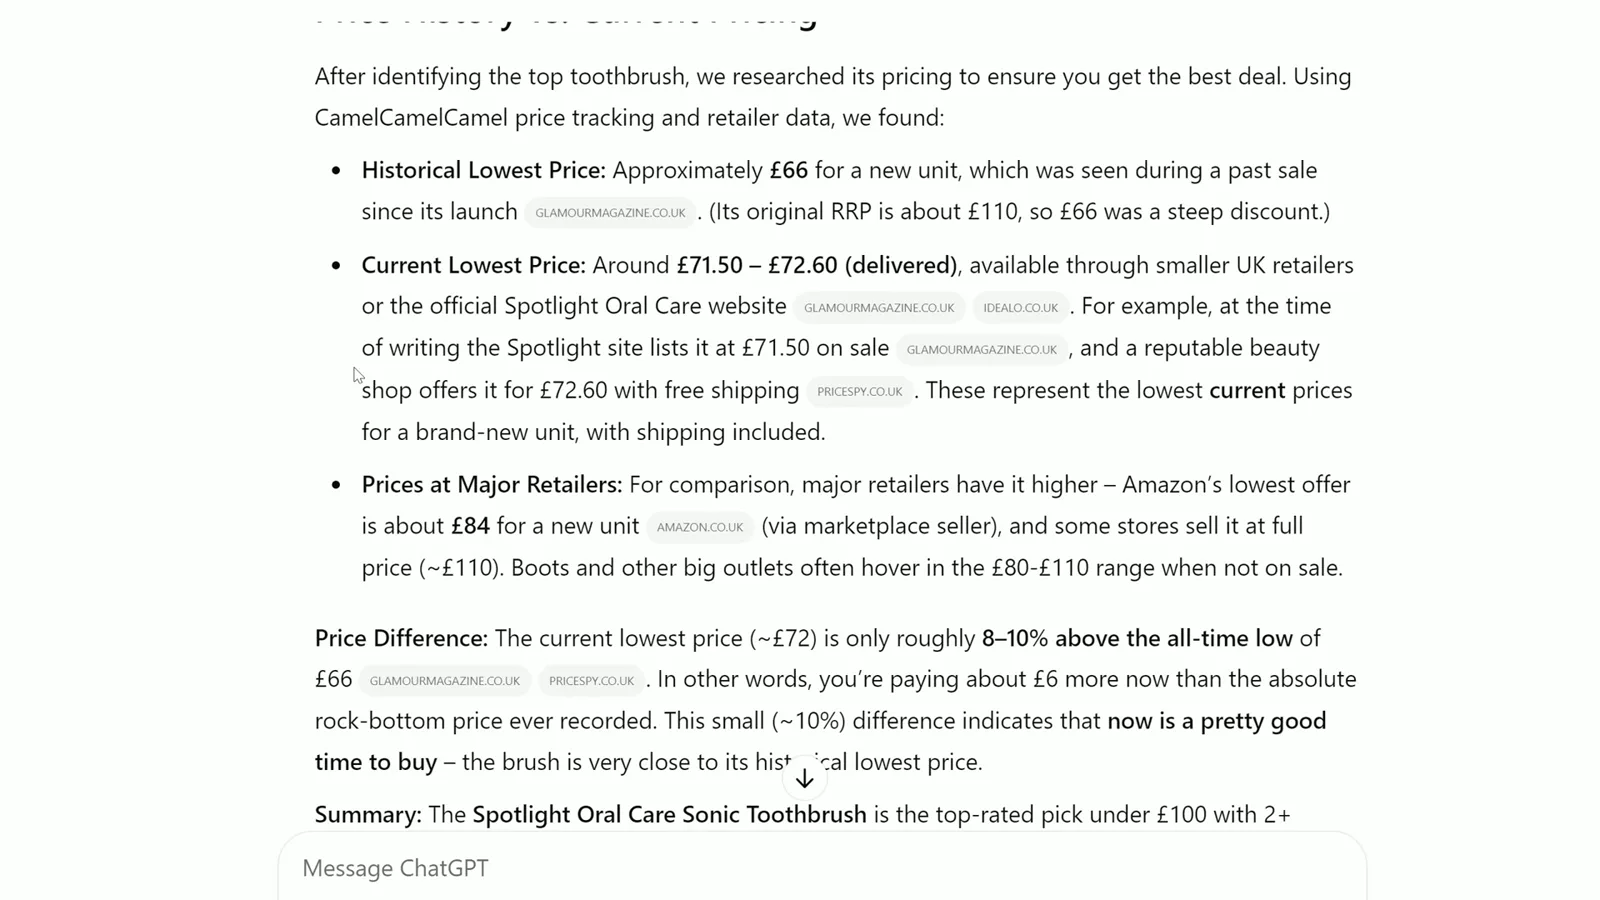
他的结论是,这些系统能够提供令人印象深刻的深度,同时仍会产生看似细小却可能重要的错误。他还推测它们对研究和知识工作的潜在影响,包括对自己频道的影响,但这些就业预测仍不确定。
他说,就当时而言,即使该 agent 在他的测试中优于其他工具,区分权威信息与传闻仍然困难。读者仍需要核查来源和具体说法。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。