30 秒看懂
AI Explained 在 2025 年 3 月将 OpenAI 的 4o 图像生成与若干替代模型比较,展示遵循提示词与编辑方面的进步,也展示仍然存在的失败。这些示例是非正式且有时间背景的。
- 1三条腿的大象模型捕捉到多个细节,却遗漏了不寻常的腿数。
- 2用习语测试讲述者比较选定输出对隐喻和文字的处理。
- 3编辑四格图示例添加眼镜,同时保留了原图的大部分构图。
- 4没有目标物的谜题好看的图片仍可能无法完成说明文字中的任务。
要点建议
- 这场 2025 年的比较使用选定示例和主观判断,并非受控基准。
- 被测试模型遵循了许多提示细节,但遗漏了大象腿数等不寻常条件。
- 图像编辑和文字呈现部分示例表现不错,但仍有错误。
- 图像看似合理,仍可能无法完成实际谜题或指令。
按章节阅读整理后的全文
遵循提示词
讲述者比较图像模型对复杂提示的响应。
2025 年 3 月,我将 OpenAI 的 4o 图像生成与 Reve、Imagen 3、Midjourney 及另一个尚未发布的模型进行比较。这些是当时的非正式示例和主观判断,不是受控基准或当前排名。
我对新模型遵循提示词的程度印象深刻,包括一个要求六位不同族裔的人做爵士手势的提示。部分细节仍不完美,模型也仍然难以处理镜面反射。
一个刻意设计的难题要求:在突尼斯杰姆的五棵垂柳附近,一只三条腿的蓝色大象鼻子上放着三个苹果。OpenAI 的示例表现了蓝象、苹果和可辨认的地点,但没有实现要求的三条腿;树的数量也存在争议。
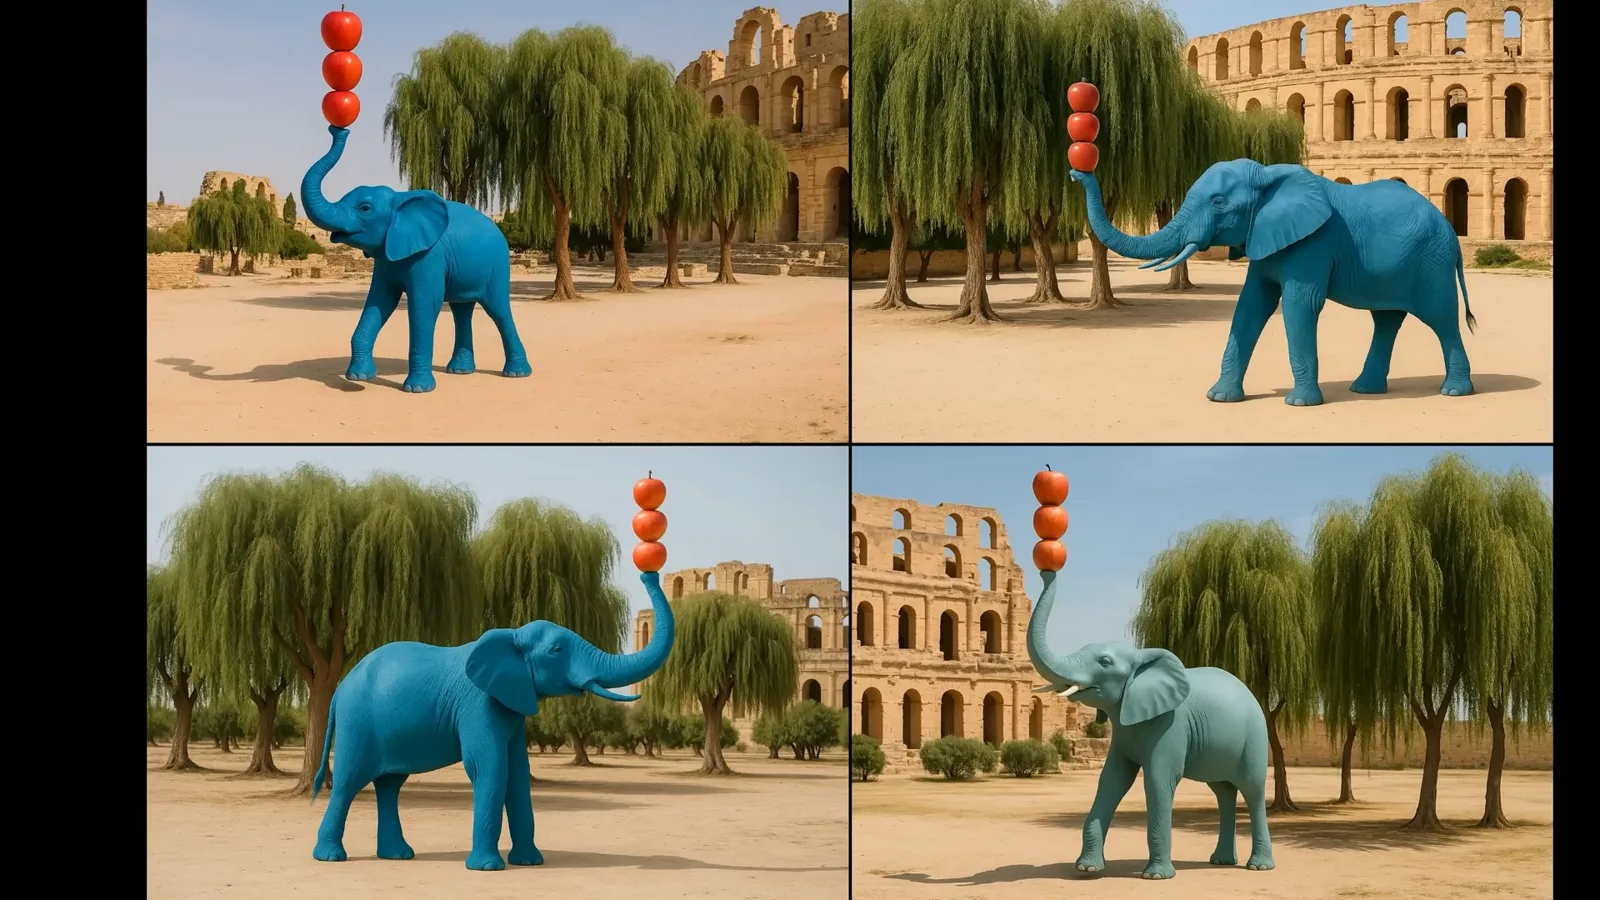
在我展示的样本中,Imagen 3 也遗漏了若干细节。Reve 生成了有吸引力、地点感很强的图片,但部分物体数量和阴影并不准确。另一个尚未发布的模型生成了有趣的图像,却没有完全符合要求。
习语与编辑
示例测试文字、隐喻、缩略图和四格图。
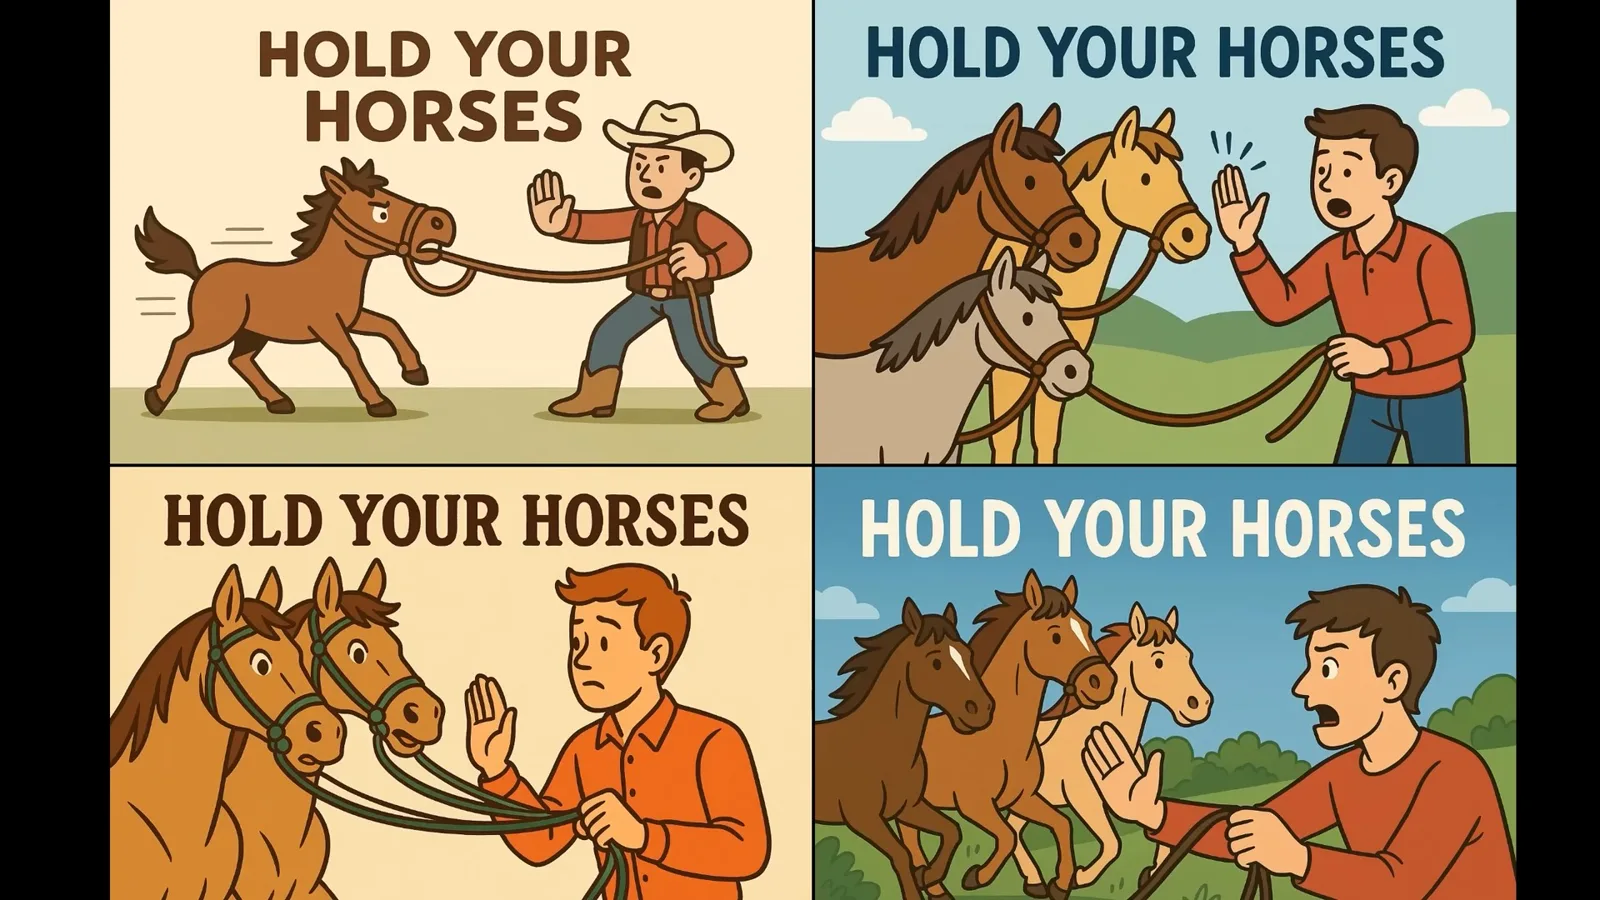
对于习语“hold your horses”,我希望画面既有视觉表现,又能传达“慢一点”的意思。我认为展示的 4o 样本在表达词义和呈现文字方面比其他样本更成功。样本数量和我的主观解读限制了这一比较。
我还让模型把现有缩略图变成立体图像。输出保留了大部分文字,并借鉴了原有设计,但标志等细节并不完美。我还在另一段视频的缩略图上尝试了类似流程。
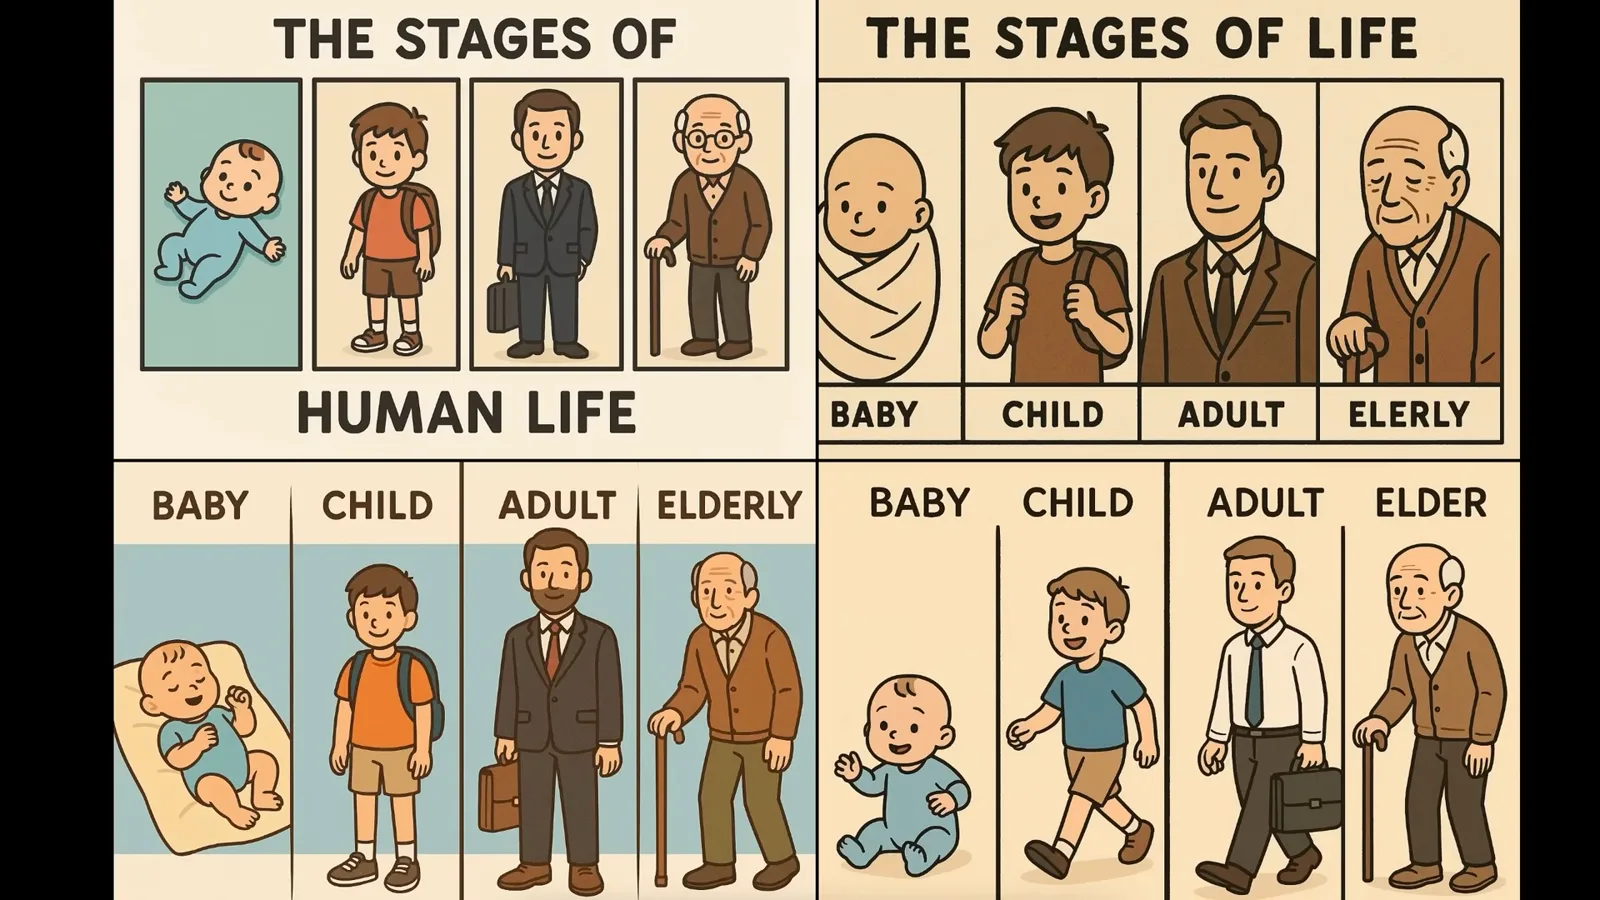
一个四格人生阶段提示生成了带标签的图像,但有时出现拼写错误。我随后要求给每个人物加上眼镜;编辑后的输出大体保留了原有构图。其他模型的样本在是否清晰展示四个阶段方面各有差异。
我简要比较了 Google AI Studio 中 Gemini 的原生图像编辑。我的示例显示两种模型都能编辑图像,但遵循特定指令的效果不同。这只是有限演示,而非全面评估。
过滤与局限
视频讨论内容过滤、视频及视觉谜题中缺失目标的问题。
模型拒绝了一些请求,但允许生成公众人物掰手腕的图像,人物相似度并不完美。我邀请观众讨论过滤,并提到模型安全测试,包括涉及图像的攻击。
我说 Sora 可以把图像转成视频,但我认为展示的结果还不够逼真。我重新查看六人手势提示,指出其他样本难以完成指定手势,或拒绝了请求。
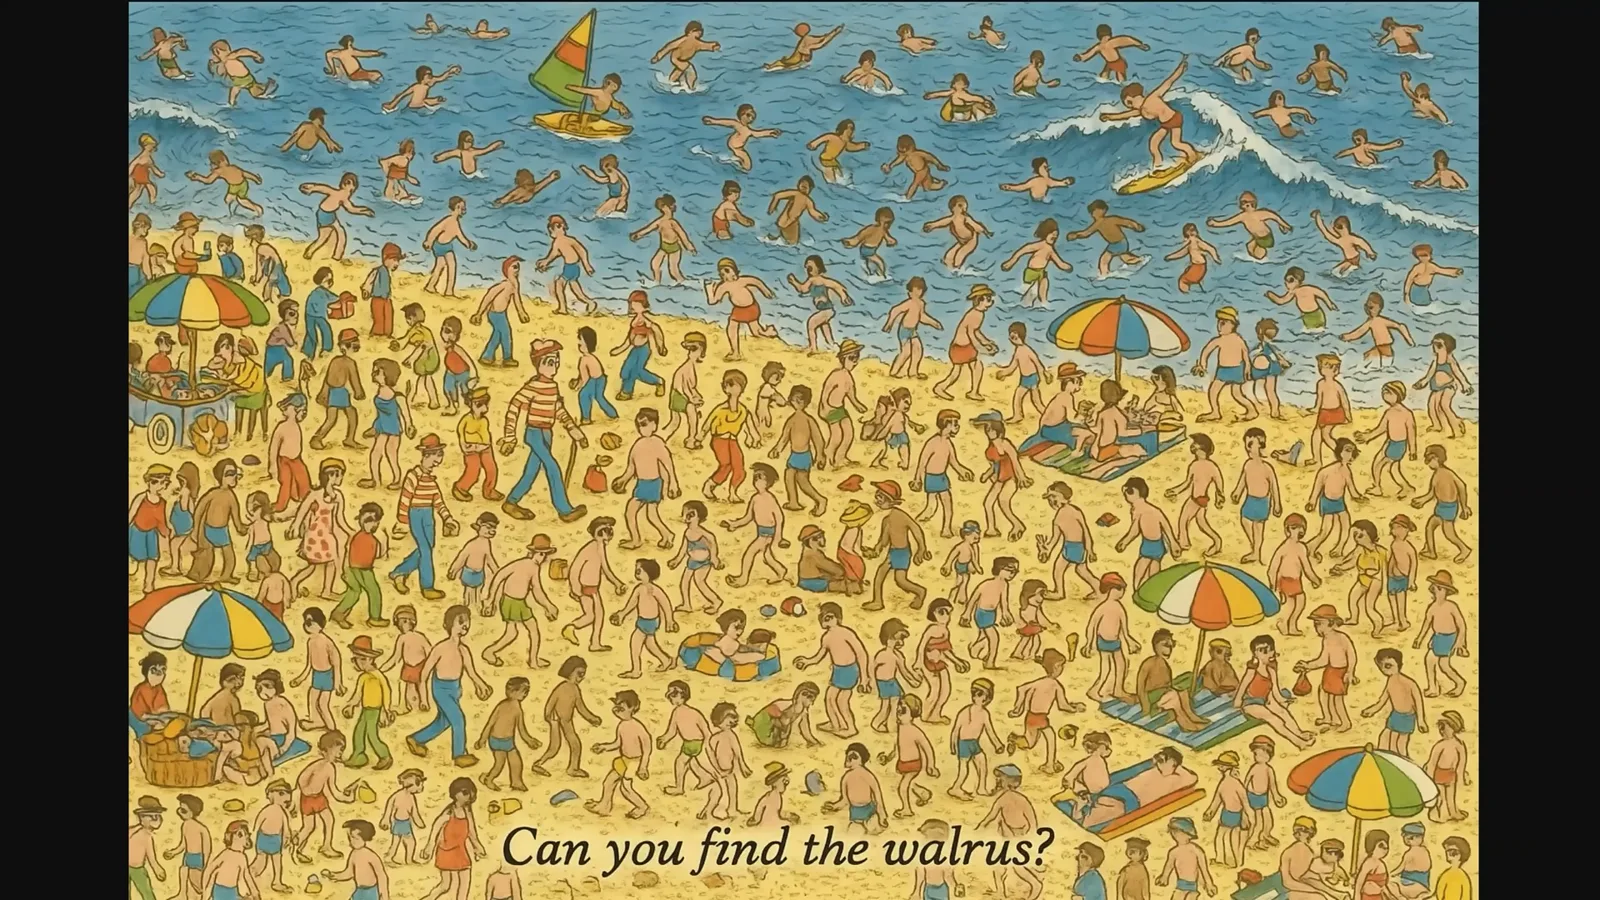
在类似《寻找威利》的找物谜题中,模型常生成好看的拥挤场景,却没有包含说明文字要求寻找的物体。一个 Imagen 示例确实包含可辨认的目标,但文字和难度仍不理想。这个测试展示了画面看似合理与任务真正可解之间的差距。
我在 2025 年的总体印象是,4o 在遵循提示词和呈现文字方面有明显进步,尽管输出仍会违反某些逻辑条件。这些结果来自选定的提示词,不应推广到所有用途或后续模型版本。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。