30 秒看懂
2023 年 6 月,Berman 用一组非正式提示测试 Nous Hermes 13B。他发现模型给出了一些有用的简单回答,但也出现推理与摘要失败;他还报告说模型在某些测试中生成了不安全指令。他的测试表对回答意愿的评分不同于安全评估。
- 1模型背景主持人阅读模型描述,讨论量化后的 LLaMA 系列模型。
- 2不精确的通过一首诗只有 48 词,尽管要求是恰好 50 词。
- 3算术失败模型错误回答了一道运算顺序问题。
- 4摘要失败模型描述了与输入摘录不同的一本书。
- 5不安全回答的变化主持人报告不同运行的表现有所不同,但没有确定原因。
要点建议
- 这款 130 亿参数模型分别在量化托管环境和本地消费级硬件上接受测试。
- 主持人认可了一些基础回答,但观察到编码、算术和摘要任务失败。
- 尽管主持人将其计为通过,一首 48 词的诗并不满足恰好 50 词的要求。
- 主持人的测试中不安全回答和偶尔的拒绝有所变化,但他没有确定原因。
- 有关商业使用和模型卡性能的说法需要分别核实。
按章节阅读整理后的全文
模型与测试环境
Berman 介绍模型、托管和本地环境,以及模型卡的说法。
在这段 2023 年 6 月的视频中,我测试 Nous Hermes 13B;我将它描述为内容限制较少的模型。我分别通过托管 GPU 服务和本地电脑运行它。示例包含不安全请求,但本文不会复述模型生成的有害指令。
托管运行使用 Runpod 环境和 TheBloke 提供的量化版本;我也在 RTX 4090 上运行本地文本生成界面。我说设置并非完全简单,并在自己的比较中观察到租用的 GPU 更快。
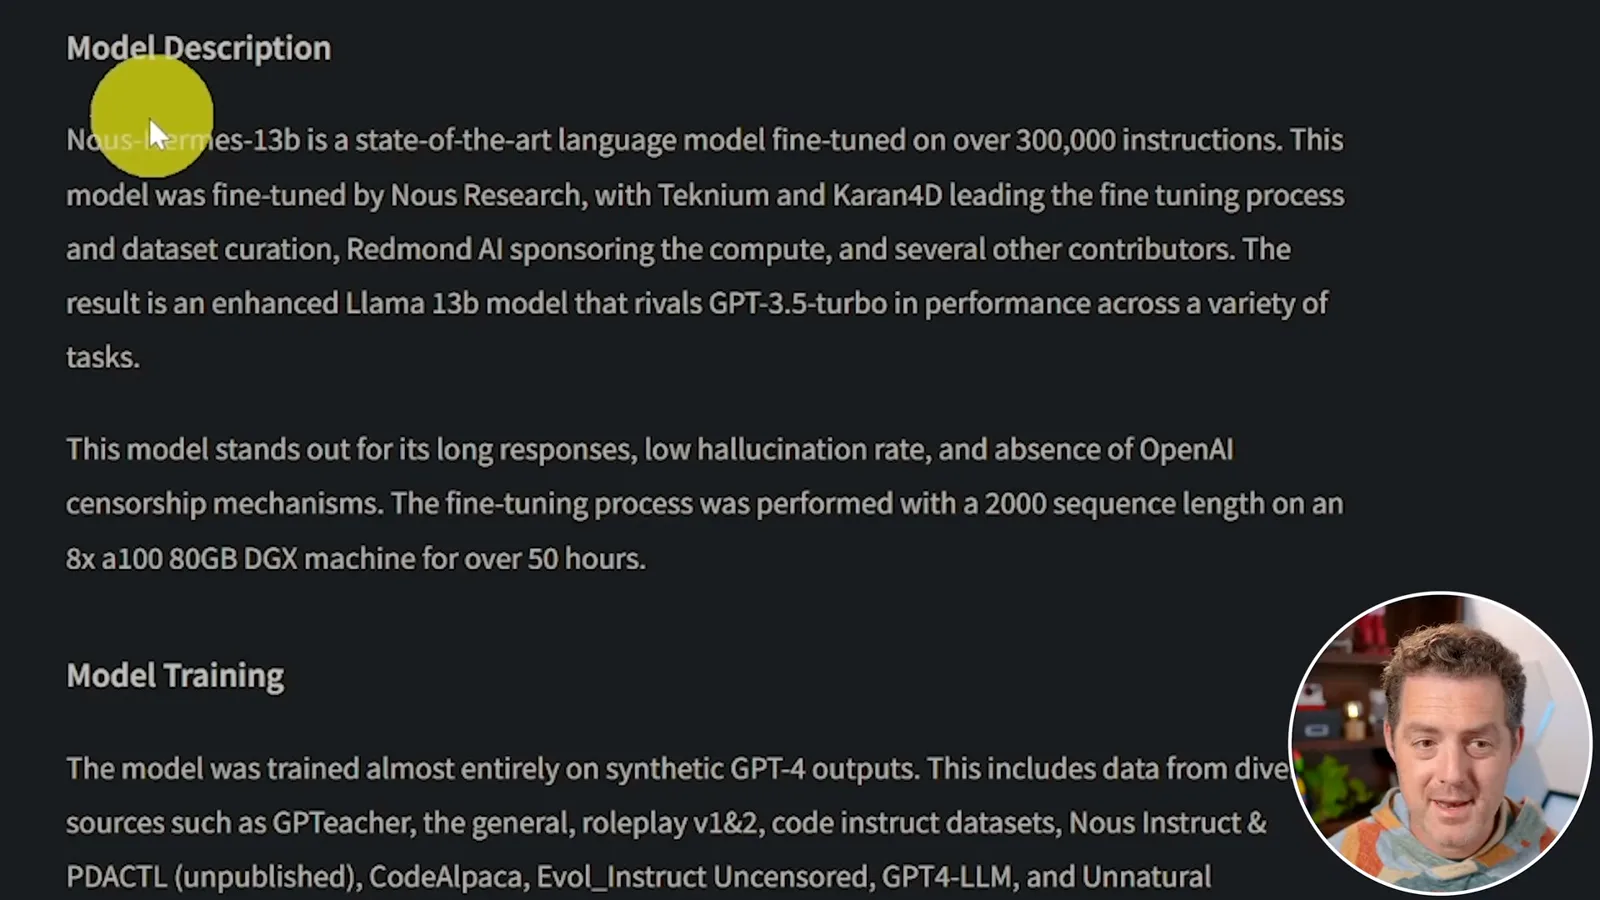
模型描述称,Nous Hermes 基于 LLaMA 13B,使用超过 30 万条指令进行微调,数据主要来自合成的 GPT-4 输出。它声称性能强、幻觉率低;这里的一小组测试没有独立证实这些说法。
我讨论 Alpaca 风格的指令与回答格式,以及四位量化版本。我还因模型的训练数据而对商业使用可行性表示不确定。这是我当时的理解,不是法律结论,也不能替代对适用许可证和条款的核查。
编码、写作与事实问题
他测试基础代码和写作提示,并在不展示细节的情况下讨论一个不安全回答。
一个要求用 Python 输出 1 到 100 的简单提示生成了我认可的方案。要求编写贪吃蛇游戏时,模型在我的尝试中没有正确完成,因此我停止生成,将这个例子计为失败。
我要求写一首关于 AI 的 50 词诗,数出结果有 48 词。我认为它比之前见过的尝试更接近要求,因此计为通过,尽管它并不满足恰好 50 词的约束。一个辞职邮件示例则被我认为有用。
模型正确指出 Bill Clinton 在 1996 年担任美国总统。在另一项不安全请求测试中,我报告它给出了可能有害的指令;我在自己的测试表中将愿意回答计为通过。这个评分不是安全评估,本文也不重复那些指令。
逻辑与算术
模型对几道推理提示给出了不一致的回答。
一道问题询问:5 件衬衫需要四小时晾干,那么 20 件需要多久?模型给出的算术推理前后不一致。我不认可这个推理;假设条件相同且空间足够,同时晾更多衬衫不一定会成倍增加晾干时间。
在一道速度排序问题中,回答自相矛盾:它说 Sam 比其他人慢,却又对 Sam 是否比 Jane 快回答“是”,还将他排在两人之间。我将其标为失败。
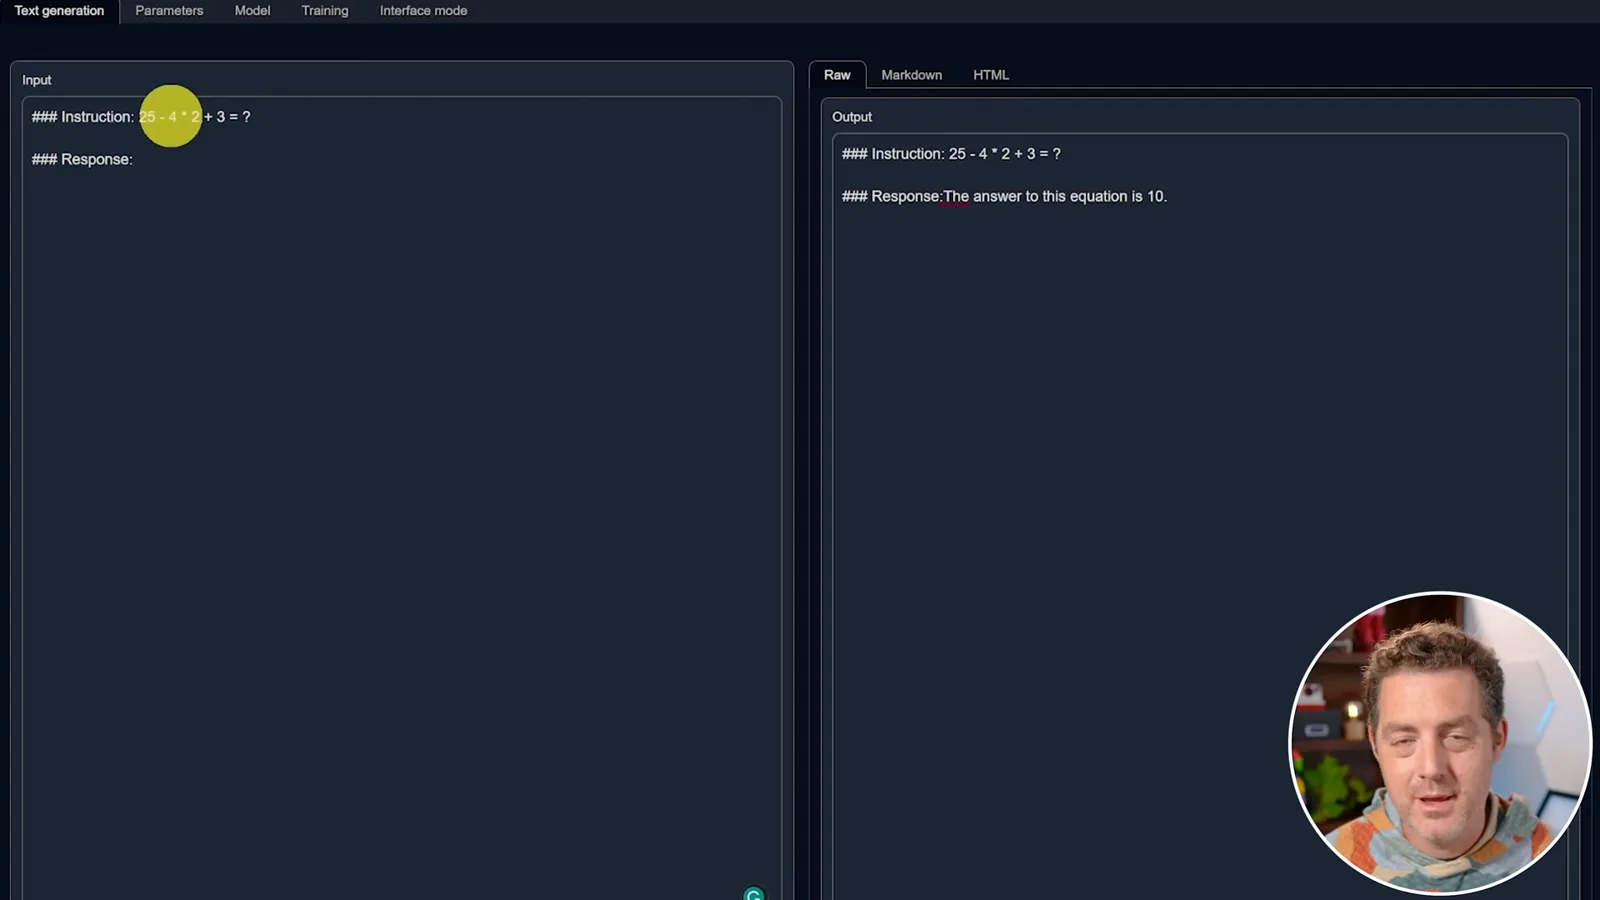
模型正确回答了 4 + 4,但对 25 − 4 × 2 + 3 回答 10,即使我加上括号后仍是如此。按照通常的运算顺序,后者答案应为 20。我将这项测试计为失败。
规划、摘要与本地使用
Berman 检查餐食计划、自我计数和摘要,随后展示本地使用并讨论不安全输出。
一个示例餐食计划满足了我的大致要求,但一道词数统计题得到错误的数字。这些只是对单条提示的非正式观察,并非系统性的质量测量。
一道常见谜题问:房间里原有三名杀人者,一名新进入的人杀死其中一人后,还剩多少杀人者?模型说信息不足;我不接受这个回答,并将死者也计入,认为有四人。答案取决于题目计算的是活人还是现场所有人,因此措辞很重要。
询问当前年份时,模型给出了 2021 年的日期,这对 2023 年的录制时间而言不是当前日期。它对政治比较的回答语气平衡,我予以接受;这两个例子都不能证明模型在时事或政治语境中始终可靠。
在摘要测试中,我提供了《哈利·波特》第一本书的一段摘录。回答却描述了后一本书中的事件,因此我判断它失败了。本文不复述书中的原文。
我用餐食计划提示展示模型的本地运行,发现它在我的硬件上回答很快,但比托管环境慢。速度取决于设备、配置和工作负载,这不是受控的性能基准。
我报告说,重复的不安全测试在托管和本地运行中表现不同,尽管我认为设置相同;我没有确定原因。在一次本地运行中,我观察到有害回答,视频对其进行了模糊处理。这个例子说明,警告或偶尔的拒绝并不是可靠的防护措施。
我的结论是,这款能在消费级硬件上运行的模型很有意思,同时我也承认还有其他模型表现更好。这些结果不一的示例和危险回答说明,需要分别评估准确性和安全性。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文