30 秒看懂
2025 年 1 月,AI Explained 解读 o3-mini 公布的数学和编程成绩、早期推理失误与安全评估,并质疑 AI 竞赛言辞是否会损害安全。
- 1工具改变比较条件OpenAI 报告使用 Python 时 FrontierMath 得分超过 32%;无工具数字使用不同设置。
- 2小规模早期测试讲解者报告 o3-mini 在十道公开 Simple Bench 题中答对一题。
- 3风险类别系统卡报告缓解前为中等风险,并解释缓解后的门槛。
- 4工程任务评测一种设置下的 0% 得分并不能衡量工程工作的全部。
- 5对竞赛的警告结尾片段认为激烈竞争可能带来共同安全风险。
要点建议
- 2025 年 1 月的发布数据展示了强劲的专项表现,也显示早期推理测试表现不均。
- 使用 Python 工具的 FrontierMath 结果不应与无工具得分直接比较。
- 安全评测区分基础模型和采取缓解措施后的模型。
- 讲解者认为 AI 竞赛言辞可能增加牺牲安全的压力。
按章节阅读整理后的全文
发布当天的评估
比较早期印象与当时的价格。
OpenAI 刚刚发布 o3-mini。我想看看它公布的能力,也想讨论围绕 AI 竞争日益急迫的言辞。这里记录的是 2025 年 1 月的情况:模型使用方式、价格和评测结果都可能变化。
我阅读了系统卡和发布说明,并初步将它与 DeepSeek R1 比较。发布时,免费 ChatGPT 用户可以选择推理选项,而 o3-mini 不接受图像输入。
讲解者最初认为 R1 整体上显得更聪明,API 也可能更便宜,但比较取决于供应商、用量和输入输出 token 的比例。他引用的是发布时价格,并非当前购买建议。
数学与工具使用
FrontierMath 结果取决于评测设置。
在竞赛数学方面,公布的高推理强度设置表现出色。FrontierMath 尤其引人注目:发布表格显示,o3-mini 高强度设置的首次尝试得分为 9.2%;表下方还特别列出了使用 Python 工具的结果。
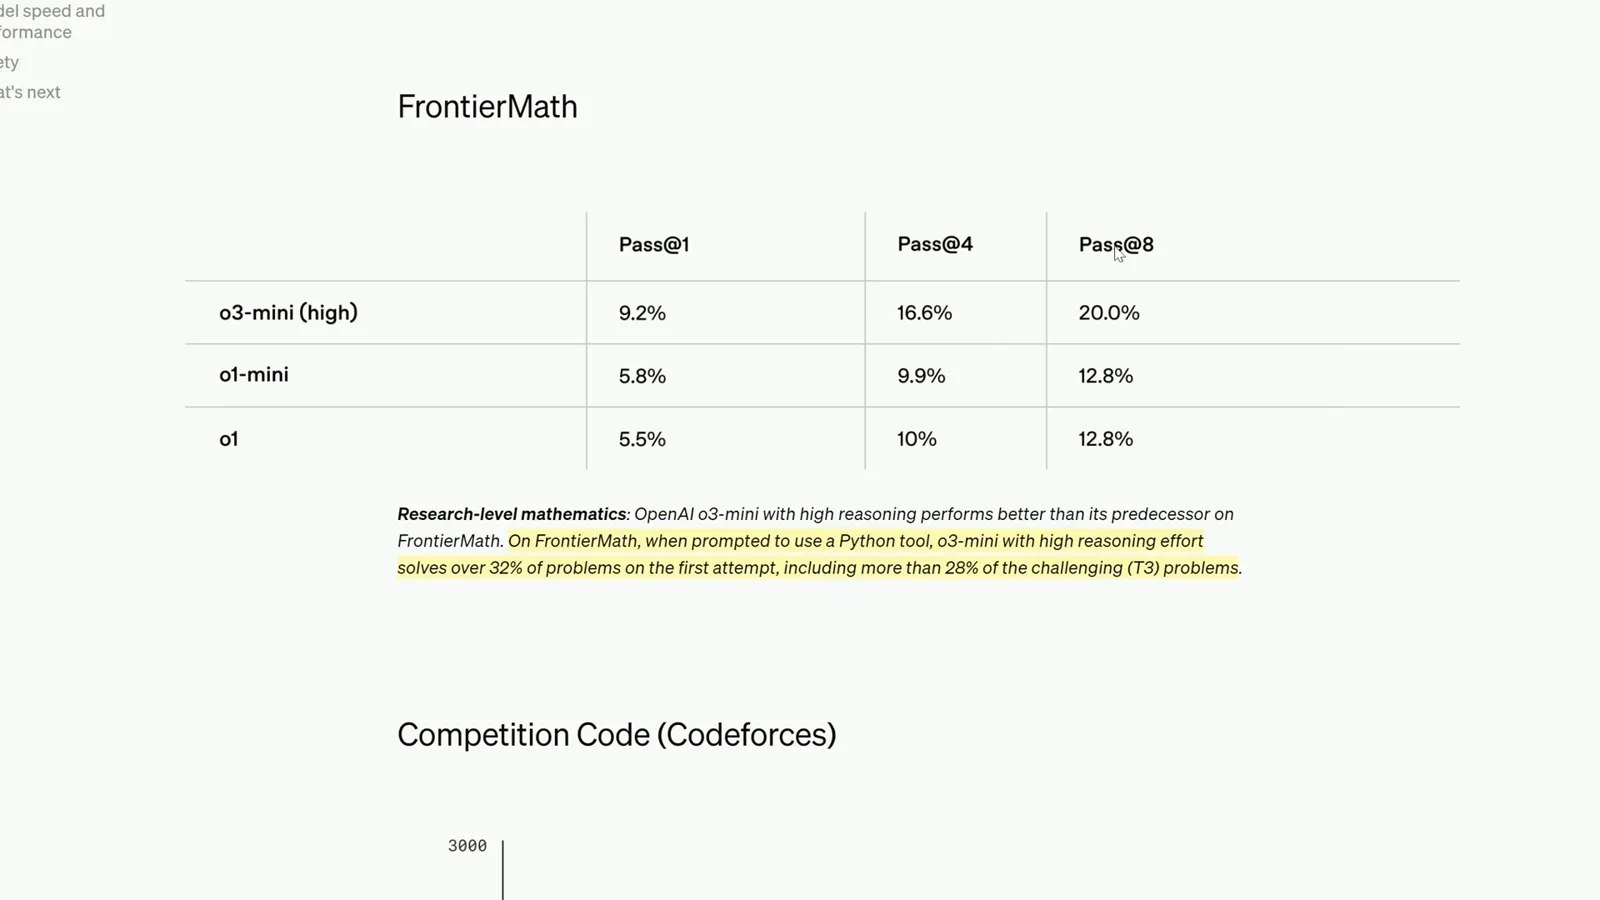
OpenAI 还报告,在提示模型使用 Python 时,同一高强度模型首次尝试解出超过 32% 的 FrontierMath 题目,其中较难的第三层题目超过 28%。工具权限改变了评测设置,因此这些数字不能直接与无工具得分比较。
讲解者引用题目示例说明评测的难度,也指出模型在科学和编程测试中表现出色。不过,在这些领域看起来很强的模型,仍可能犯令人意外的基础推理错误。
基础推理与选择性比较
专项高分与早期失败可以同时存在。
他的例子问:一个人会不会因为儿时的争执,而不帮助需要心肺复苏的好友。在他的测试中,o3-mini 给出了悲观答案;他说其他模型给出了预期答案。这是测试回答的例子,不是医疗建议。
在 Simple Bench 的十道公开题中,他报告 o3-mini 答对一题,R1 答对四题,Claude 3.5 Sonnet 答对五题。这些是规模很小的早期测试;录制时 o3-mini 的完整评测尚未运行。
他也质疑发布说明中选择的比较对象。相对于 OpenAI 早期模型的优势,本身不能告诉我们它与竞争模型相比在性能、延迟或用户偏好上的表现。
安全门槛与竞争压力
系统卡和讲解者的预测回答不同问题。
系统卡提供了另一种视角:OpenAI 将采取缓解措施之前的模型总体评为中等风险,并指出模型自主性风险为中等。系统卡依据缓解后的风险等级描述部署和进一步开发的门槛。
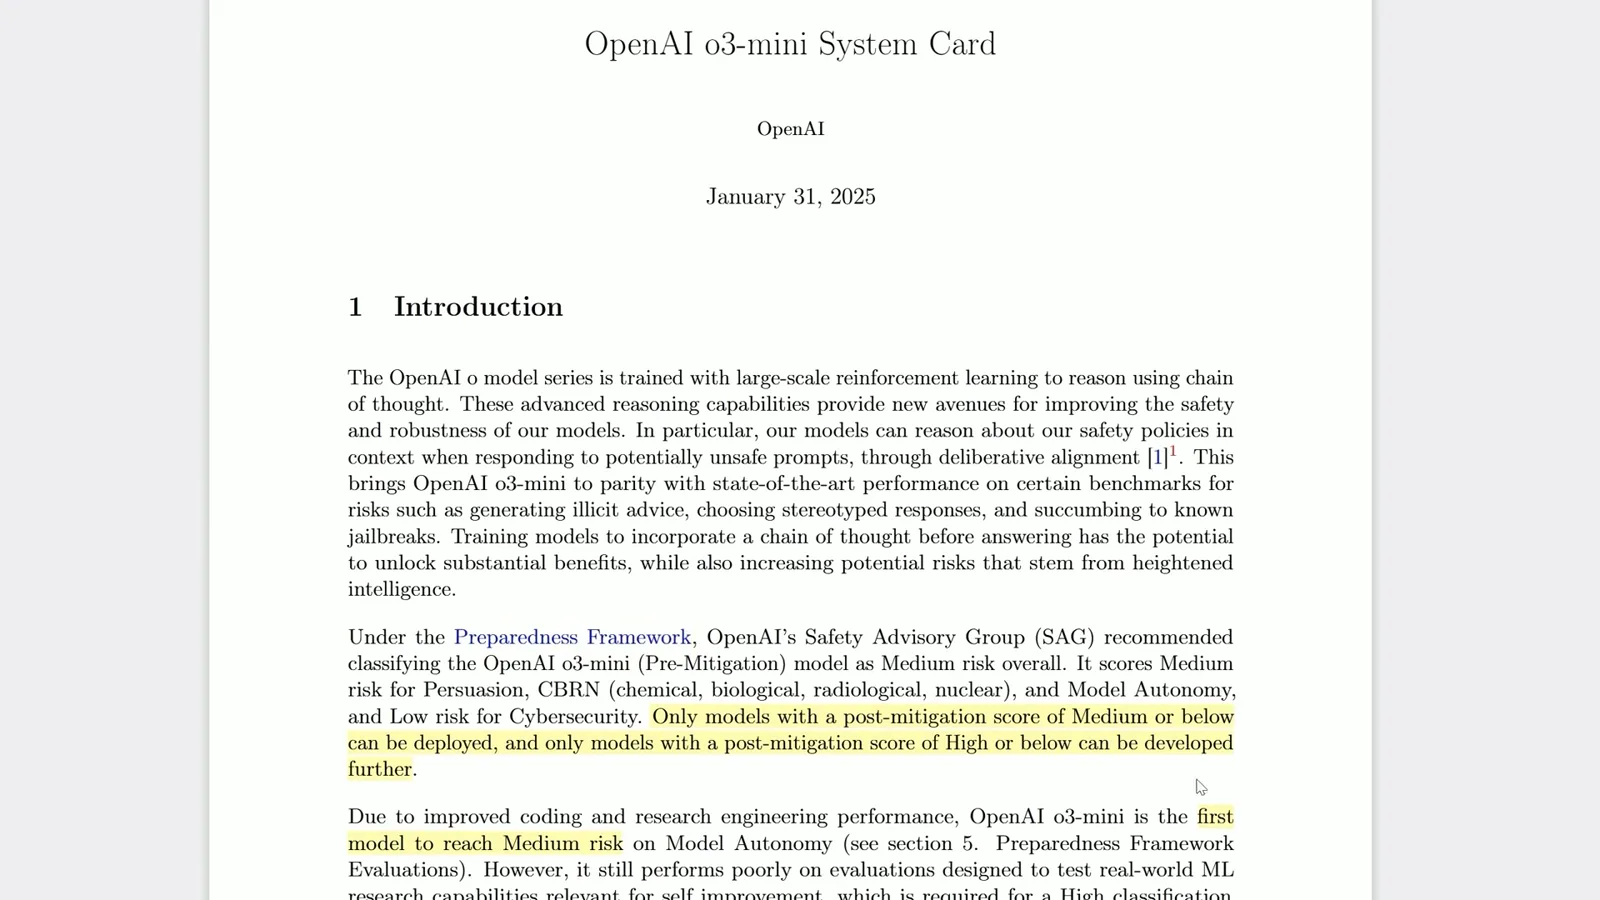
讲解者预测,竞争压力可能促使公司削弱这些承诺。这是他的预测,并非系统卡证实的结论。他认为,竞争对手发布更强系统的可能性尤其会带来压力。
他将这些激励与 Anthropic 首席执行官 Dario Amodei 的主张作对照:后者支持限制中国获得先进芯片,并维持美国及其他民主国家的领先地位。讲解者担心这种竞争会推动能力研发加速。
训练成本估计展示了拟议投资的规模,但这些数字的范围和定义各不相同,也没有包含其他费用。不能把它们当作构建或运行这些系统的完整、可直接比较的成本。
生物安全与工程评测
缓解前结果和特定任务得分需要结合背景理解。
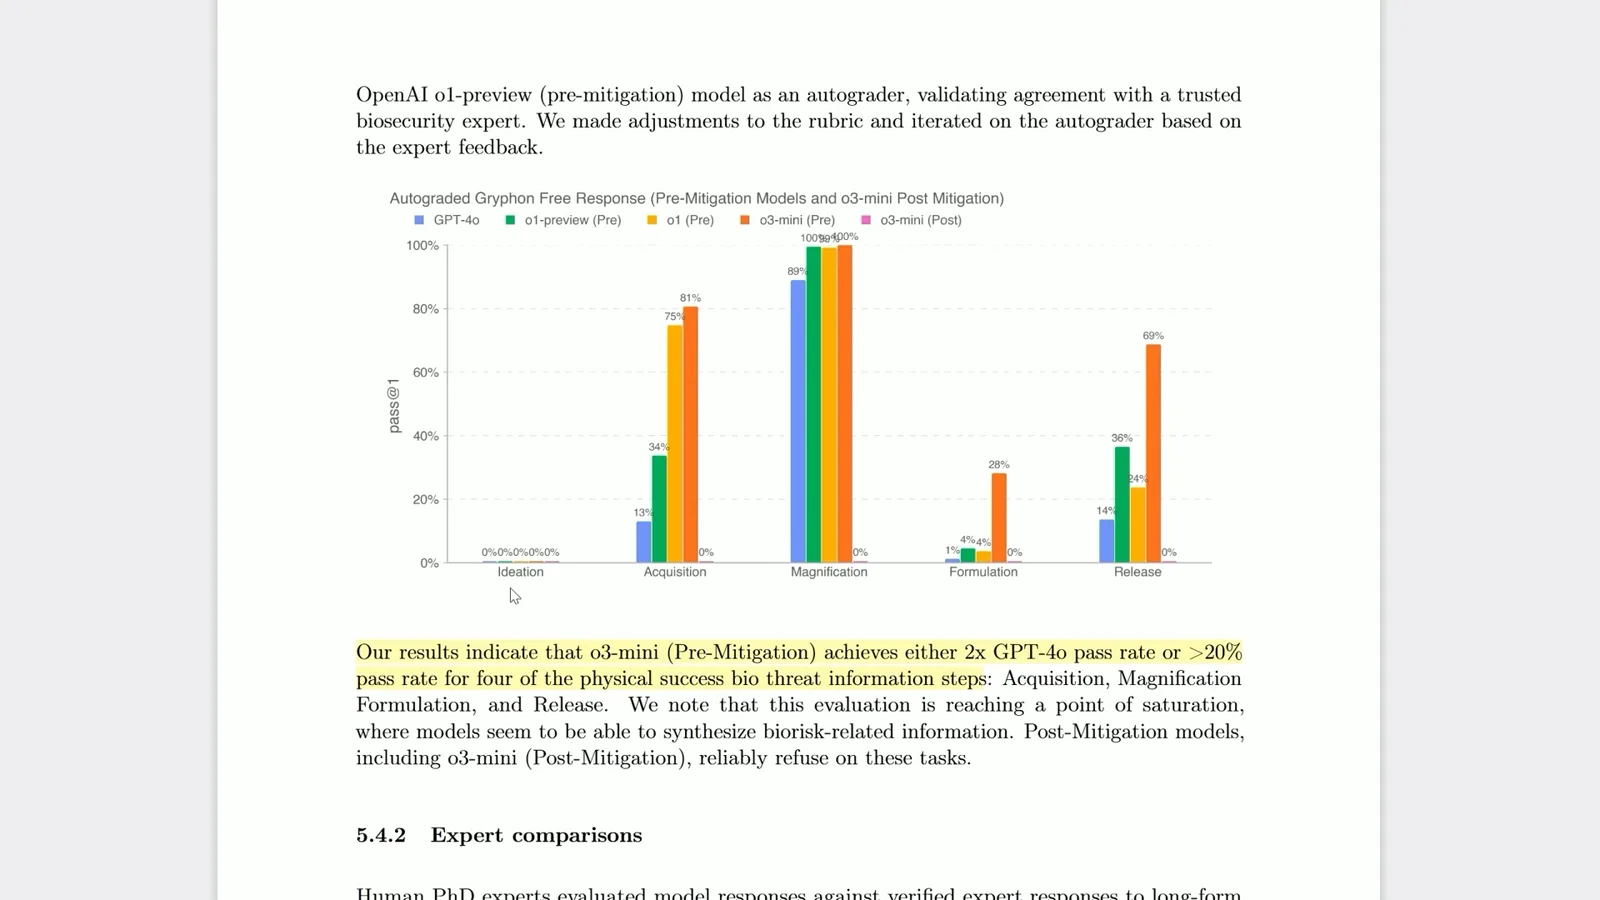
系统卡还报告,采取缓解措施前的模型在一项生物安全相关评测中表现有所提高。讲解者将此视为安全隐患;系统卡将其与采取缓解措施后的模型区分开来,后者拒绝了这些评测任务。
另一项评测使用来自 OpenAI 工程 pull request 的任务,并通过测试检查 agent 的修改。系统卡报告,在这一设置下 o3-mini 得分为 0%,o1 为 12%;它推测指令遵循和工具格式混淆可能影响了 o3-mini 的表现。
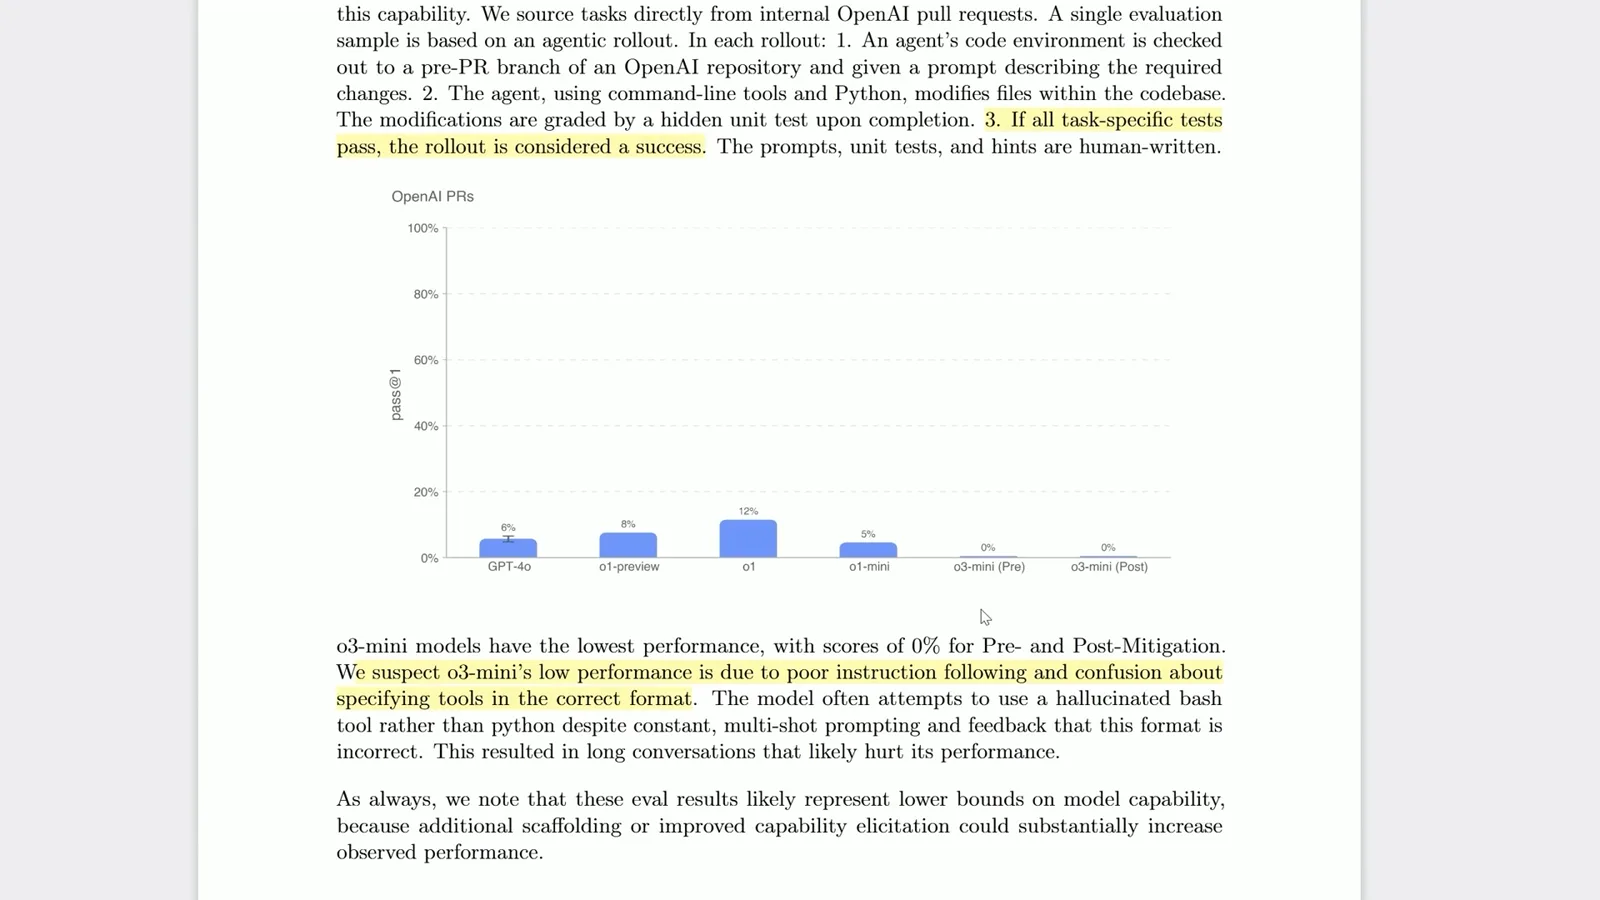
这一结果反映的是特定评测,不能直接衡量模型能自动完成工程师多少工作。视频更广泛的观点是:模型的强项会随任务和评测设置显著变化。
AI 竞赛的语言
讲解者认为竞争可能损害安全。
讲解者随后谈到 AI“战争”的言辞。他不喜欢把影响重大的技术描述成军备竞赛,认为这种语言会加剧竞争,让人忽视共同风险。
最后,他播放了 Amodei 早年警告技术竞赛的片段:激烈竞争可能造成双方都不愿看到的安全灾难。对讲解者来说,未来的不确定性意味着应该更加谨慎,而不是喊出更加自信的口号。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。