30 秒看懂
Matthew Berman 在本地运行量化版 UltraLM 13B,并用一组非正式提示测试。他发现一些回答可用,但也有多项推理失败,因此质疑榜单排名能在多大程度上预测实际表现。
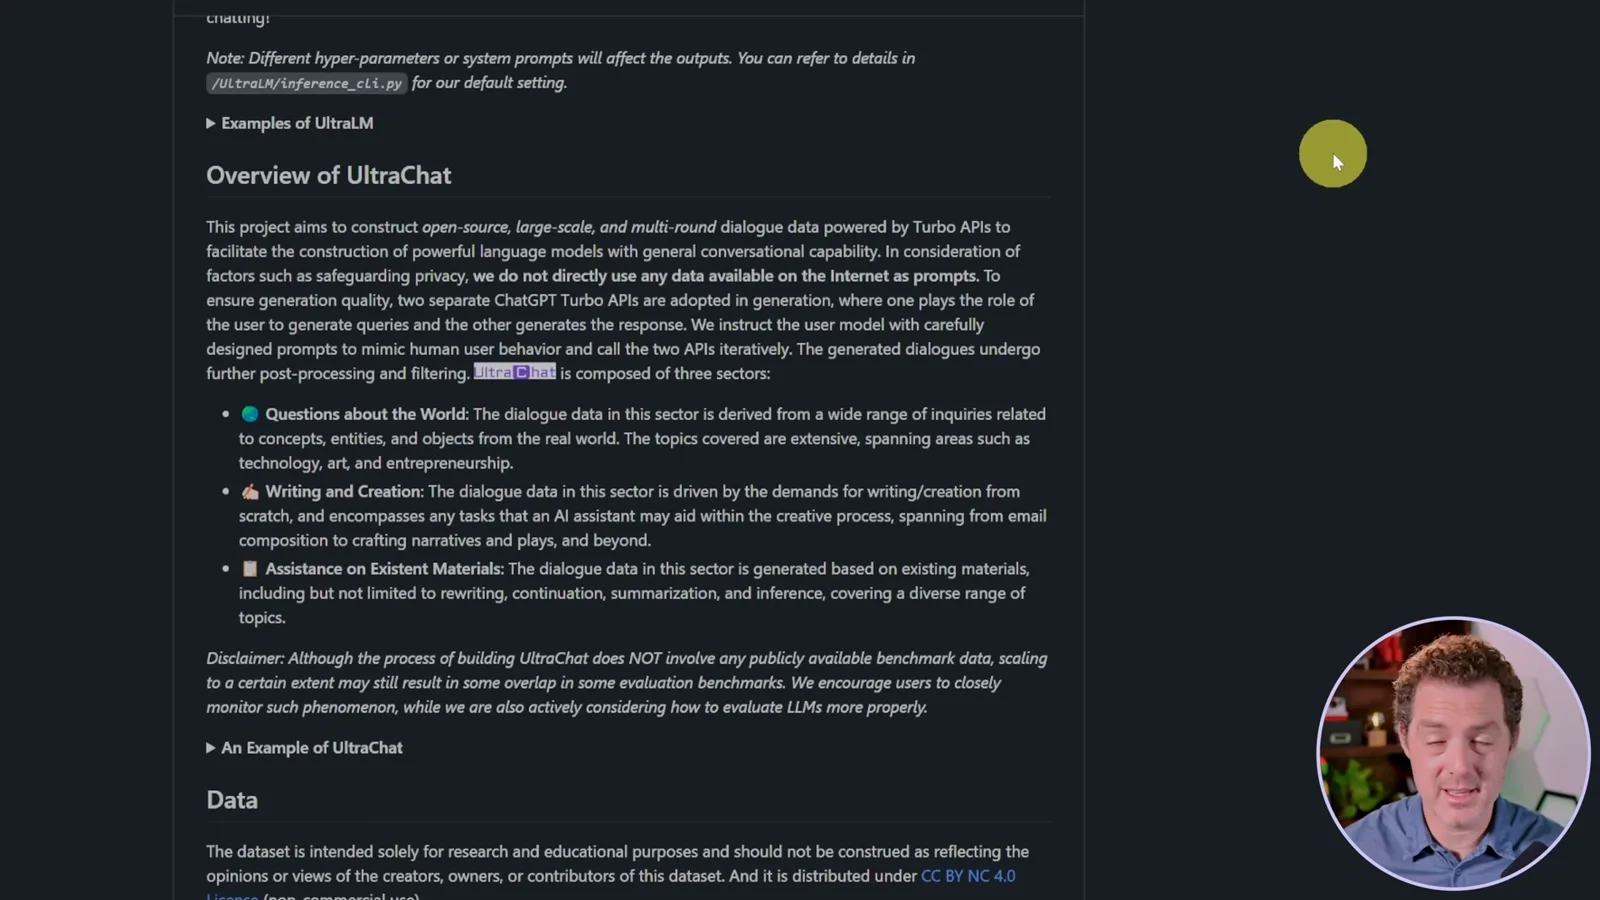
- 1合成对话数据项目描述了分别生成问题和回答的两个角色。
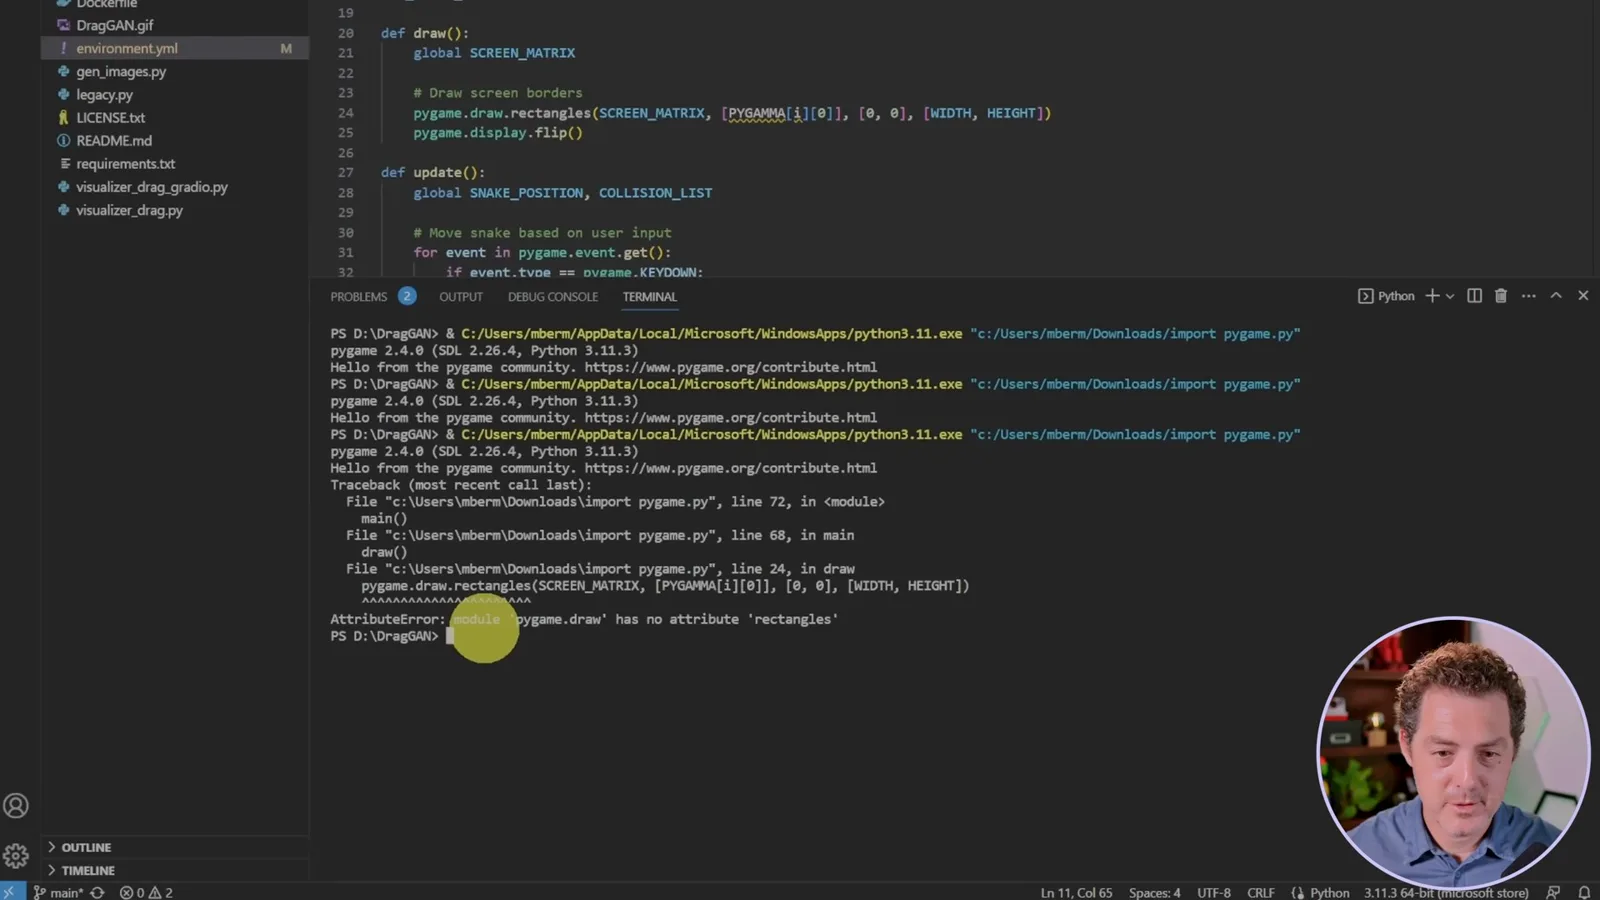
- 2贪吃蛇运行失败生成代码出现 pygame 属性错误。
- 3不稳定的逻辑表现展示的速度排序尝试失败,尽管据说此前一次成功。
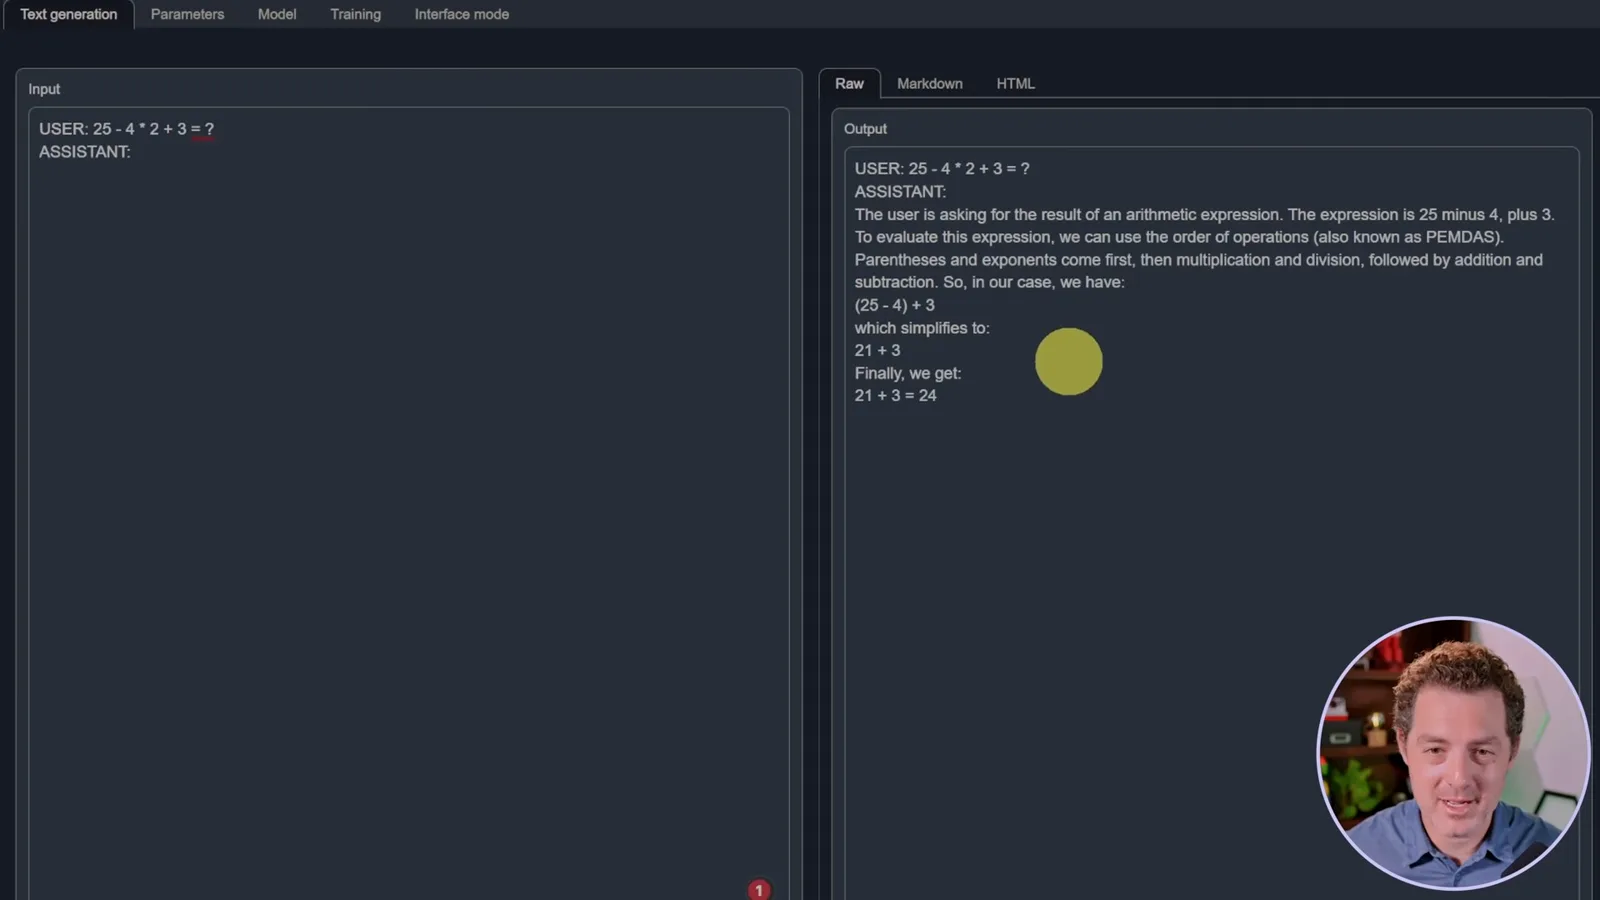
- 4算术错误模型说出了运算顺序规则,却没有正确应用。
要点建议
- UltraChat 介绍了使用两个 API 角色生成合成多轮对话数据的方法。
- 简单 Python 脚本成功,但生成的贪吃蛇游戏运行时报错。
- 诗歌比要求的短,尽管 Berman 将它算作通过。
- 在此次测试中,模型答错了数道逻辑和算术题。
- 榜单排名和少量非正式测试各有局限。
按章节阅读整理后的全文
UltraChat 与本地配置
Berman 介绍模型、数据和本地量化配置。
2023 年 7 月,我测试曾在 Alpaca 榜单开放模型中排名靠前的小模型 UltraLM 13B。榜单位置是测试的起点,不能证明它在所有任务上都能与更大的专有模型匹敌。
UltraChat 项目介绍了使用两个 ChatGPT Turbo API 角色生成多轮对话数据的方法:一个生成用户问题,另一个回答。项目列出的类别包括关于世界的问题、写作和处理已有材料。
我在配备 Nvidia GPU 的 Windows 电脑上本地运行 GPTQ 量化版本,并使用 text-generation-webui。我用 AutoGPTQ 加载模型,比较界面的指令模式和聊天模式。
编程与写作
他测试简单脚本、贪吃蛇、诗歌和辞职信。
模型很快生成一个笑话,输出 1 到 100 的 Python 脚本也正确。聊天模式的回答存在格式问题,因此我后来在部分测试中切换到指令模式。
指令模式下生成的贪吃蛇代码结构看起来更好,但运行 Python 时 pygame 报出属性错误。我将这个编程测试记为失败。
我要求写一首恰好 50 词的 AI 诗。即使提高温度,它也反复给出同一首更短的诗。我喜欢这首诗并将其算作通过,尽管它没有满足明确的长度要求。
模型写出了基本可用的辞职邮件,虽然格式有问题,也正确说出了 1996 年的美国总统。它拒绝了一个违法行为相关请求,我将其记录为拒答。
推理与算术
展示的几次逻辑和数学回答失败。
在晒衣服问题中,模型引入了没有依据的阳光和面积假设,并得出需要八小时的结论。我将其记为错误;这个问题还取决于是否有足够空间同时晾晒。
在速度排序题中,Jane 比 Joe 快,Joe 比 Sam 快,模型却说无法确定 Jane 和 Sam 的关系。展示的指令和聊天模式尝试均失败,不过我说此前一次尝试曾成功。
模型答对了 4 + 4,但处理 25 − 4 × 2 + 3 时出错,尽管它提到了运算顺序。先做乘法,正确答案是 20。
规划、总结与结论
Berman 测试其他任务,并反思榜单的局限。
一天的餐食计划请求得到了一份结构化回答,我认为有用。被要求计算自身回答的词数时,模型却给出了错误数字。
在杀手谜题中,它的解释错误陈述了题目前提,得出了错误答案。被问到当前年份时,它表示无法访问实时信息;我将承认这一局限算作通过。
在总结测试中,我提供一段关于鸟类飞行的文字,要求用项目符号总结。回答主要关注羽毛,但包含了一些原文内容,因此我有保留地算它通过。
我的结论是,考虑到模型规模,UltraLM 很有意思,也能处理一些写作和事实问题;但推理失败让我怀疑不能过度解读榜单排名。这些是单一配置下的非正式例子,不是全面评测。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文