30 秒看懂
AI Explained 回顾 2025 年初关于计算机使用智能体的报道、Sam Altman 的起飞预期和刚发布的 DeepSeek R1。讲解者区分具体基准任务与对未来能力更具推测性的说法。
- 1报道中的超级智能体早期报道尚未证实能力标签和时间。
- 2有范围的计算机任务搜索和桌面例子说明具体的智能体任务。
- 3变化中的预测Altman 说快速起飞更有可能,但定义仍然重要。
- 4初看 R1录制时讲解者只查看了初步结果。
要点建议
- 视频中的智能体预期是 2025 年 1 月的预测。
- 基准例子展示具体浏览器和桌面任务,而非通用自主性。
- Altman 表示,相比先前观点,快速 AI 起飞更有可能。
- 讲解者录制时,DeepSeek R1 的结果仍属初步信息。
按章节阅读整理后的全文
智能体早期报道
讲解者区分报道中的计划与已展示的能力。
2025 年 1 月 20 日,我回顾关于计算机使用智能体的早期报道、Sam Altman 对 AI 起飞速度不断变化的预期,以及刚发布的 DeepSeek R1。许多内容是当时的预测与传闻,而非对当前产品的描述。
我提出,短期内工作受到的影响可能取决于工作有多数字化,以及任务有多容易衡量。这是一个粗略判断,并不是对具体职业的可靠预测。
有报道称大型公司可能很快宣布能力很强的智能体,而 OpenAI 对多智能体研究和工具使用感兴趣。“博士水平”这一说法存在争议;我引用的报道对具体能力和时间提供的证据有限。
计算机使用任务
网页和桌面例子展示机会与局限。
我用 WebVoyager 和 OSWorld 的例子具体说明。一项浏览器任务要求智能体查询 Apple 配件的附近取货情况;另一项桌面任务涉及处理视频及其字幕轨道。
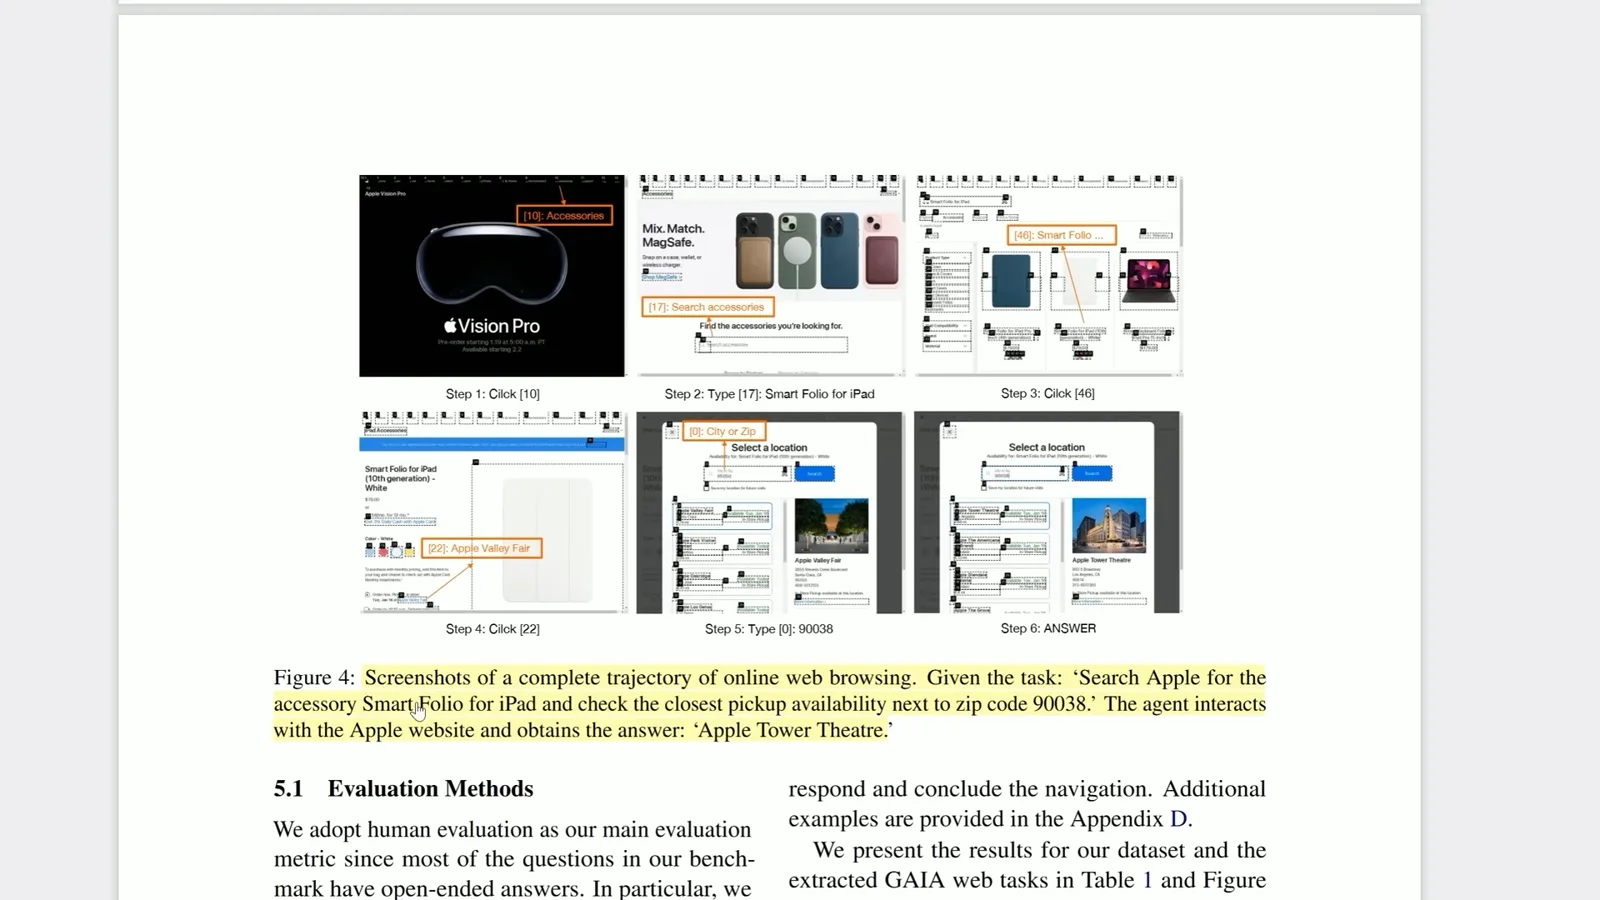
按制作时间和评价门槛寻找食谱可能有用,因为用户可以检查答案。这些任务范围相对有限,不能证明智能体能可靠地完成长期复杂项目。
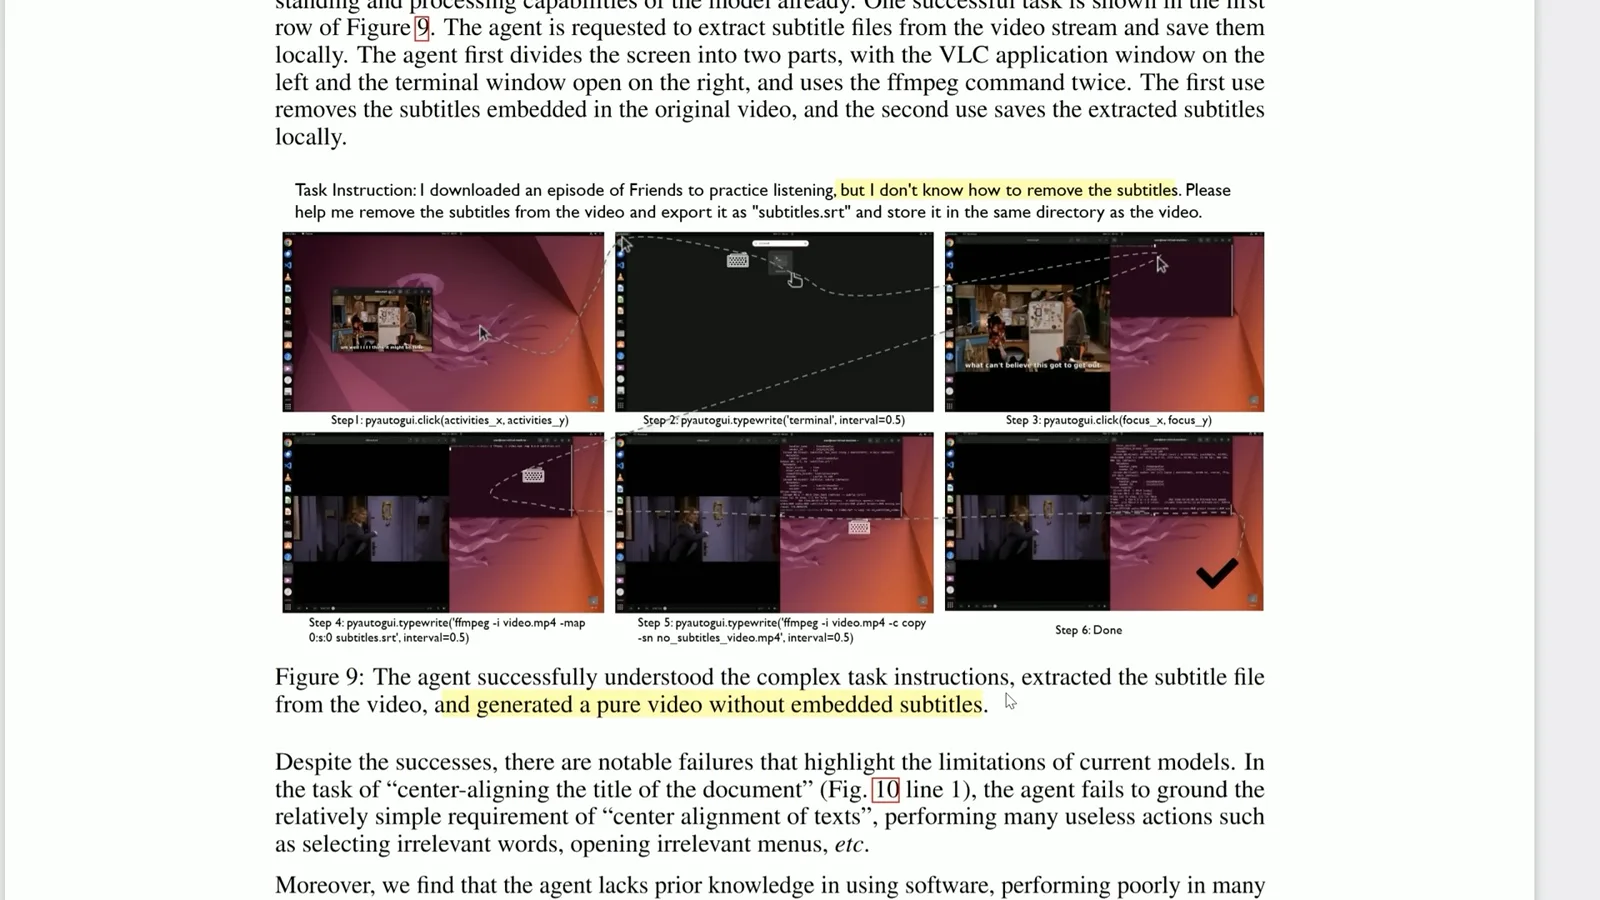
我提到报告中的点击不准确和网页干扰问题。智能体可能对广告采取行动的例子说明,将购买权限交给自动化系统需要谨慎;这是一个假设风险,并非已记录的购买事件。
我编写的数学谜题对早期 ChatGPT 模型很难,而后来的 o1 Pro 测试解出了其中许多题。这段经历让我预计智能体可能迅速进步,甚至可能发生在 2025 年内。这是基于个案的预测,不是受控测量。
我引用研究员 Noam Brown 的观点:当模型在某个自己关心的领域超过顶尖人类时,人们可能最强烈地感受到 AI 进步。他同时提醒,乐观预期之外仍有尚未解决的研究问题。
起飞与政策
讨论 Altman 不断变化的预测和当时的监管。
Altman 说,他认为快速 AI 起飞比几年前想象的更有可能,并将时间描述为几年而非十年。我把这与他早先对较慢起飞的预测作比较;由于定义不同,精确比较并不容易。
我将早先的 AI 监管呼吁与 OpenAI 2025 年经济政策文件作对照,后者敦促政策制定者不要阻碍 AI 发展。这些是当时讨论的立场,视频并未建立该组织政策历史的每个细节。
DeepSeek R1 与模型比较
讲解者查看早期结果和个人测试。
视频转向录制前不久发布的 DeepSeek R1。我查看了部分公布的基准和当时价格,但承认尚未读完整篇论文。这些早期数字不是当前价格,也不是对所有用途的独立评估。
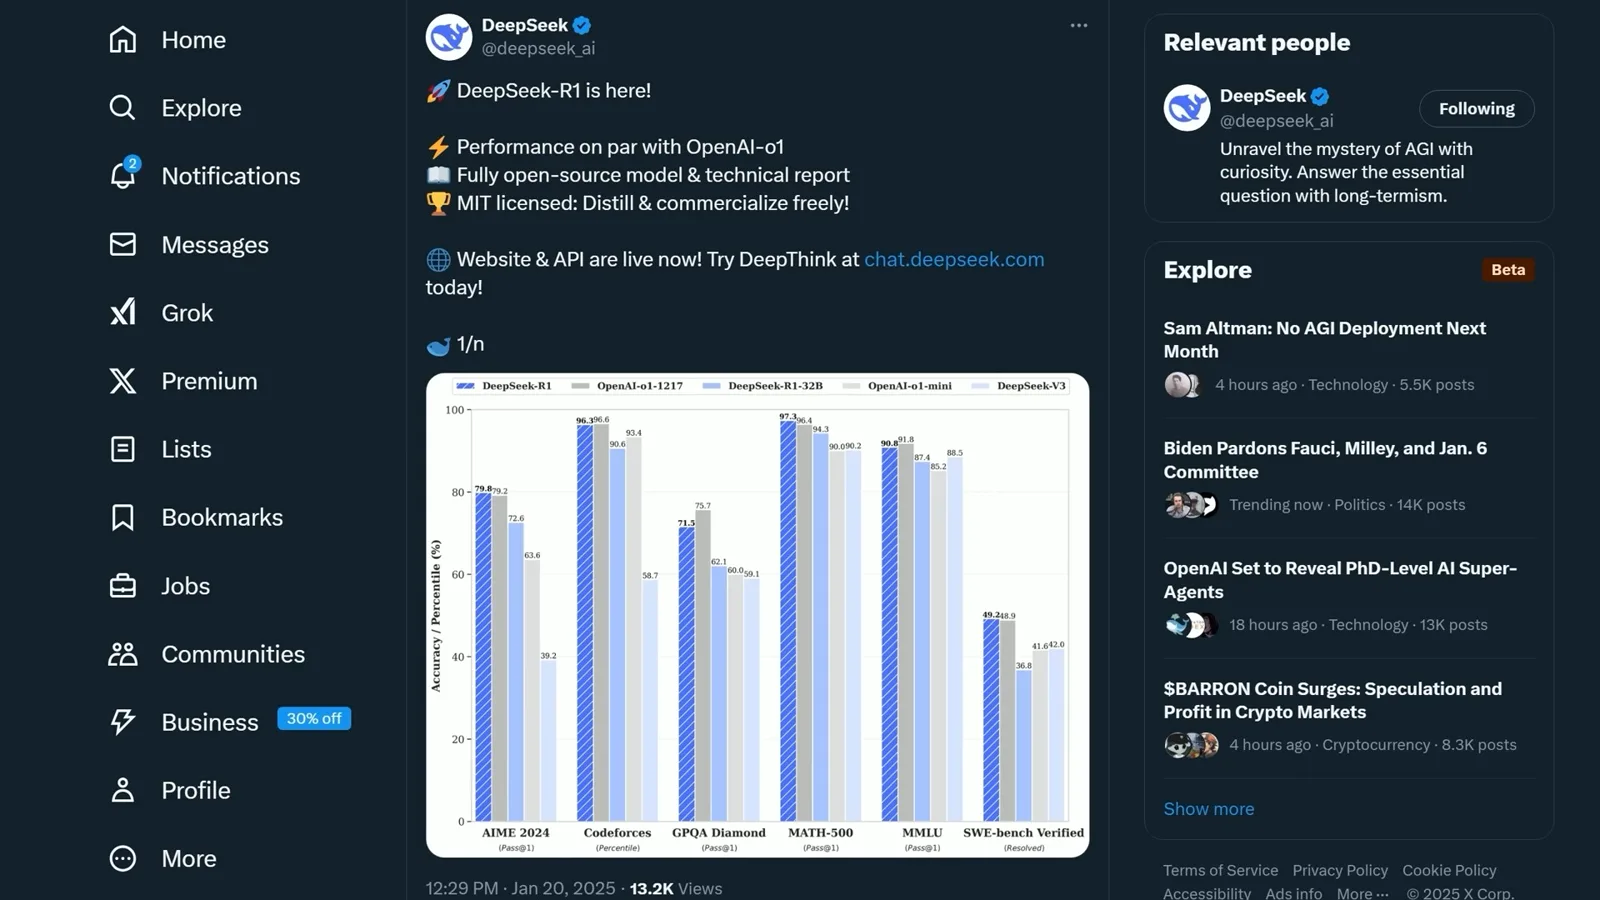
我说 R1 在我的 SimpleBench 公开题目初测中表现不太理想,完整测试仍待进行。我鼓励人们在与自己相关的任务上测试模型,而不是只依赖一个公开基准。
我还讨论通用 GPT 与推理模型路线可能结合,并关注其他实验室的进展。在我的一个编程项目中,Claude 3.5 在一项任务上优于 o1 Pro,但我明确将这视为个案。
最后我追问,2025 年会带来有用的智能体,还是社交媒体的期待已经超前于现实。我的回答是,真实进步与夸大的说法可以同时存在。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。