30 秒看懂
在这场 2024 年 9 月 12 日的直播中,Matthew Berman 按观众建议,用非正式提示测试 OpenAI 新发布的 o1-preview 和 o1-mini。他发现了一些优秀回答、不稳定的代码和存在歧义的谜题答案,也纠正了自己的一次评分错误。产品额度和可用性按发布时的情况描述。
- 1代码需要实际运行Tetris 代码最初失败;Berman 提供错误后,修订代码运行起来,但功能有限。
- 2纠正评分一个声称有 33 个字母的句子最初被判错,去掉空格和标点后得到纠正。
- 3尚未解决的几何问题北极行走问题得到不同回答,引发对预期路径的讨论。
- 4模型的物理推理不同Berman 比较 o1-mini 的弹珠答案和此前 o1-preview 的回答,并讨论假设。
- 5纯文本解题变通办法GPT-4o 先将谜题图片转成文字,再由 o1-mini 尝试分组。
要点建议
- 可见的推理摘要并非模型内部过程的完整记录,也不能证明其内部过程。
- 直播中的 Tetris 代码最初失败,修正后运行;另一个赛车游戏原型则失败。
- Berman 最初将字符数当作字母数,误判了一个答案;观众帮助他纠正了评分。
- 物理和几何谜题依赖假设与定义,模型答案需要独立检查。
- 直播中的示例属于非正式测试,并非具有统计代表性的基准。
按章节阅读整理后的全文
发布日介绍与简单测试
Berman 介绍新模型,测试拼写、句子限制和信封尺寸,并讨论可见推理摘要及发布时的额度。
在这场 2024 年 9 月 12 日的直播中,我按观众建议测试 OpenAI 新发布的 o1-preview 和 o1-mini。直播包含现场实验、错误和讨论,并非严格控制的基准测试。
我介绍 ChatGPT 中展示的两个模型:o1-preview,以及更快、更便宜的 o1-mini。直播讨论的访问方式和使用额度反映的是发布时期。
第一个问题问“strawberry”中有几个字母 r。o1-preview 正确回答三个。第二个请求要求写十个以“apple”结尾的句子,在这次小规模测试中看起来也遵循了指令。
十句测试不只是检查是否在句尾加一个词:我还查看句子是否自然地以“apple”结尾。本次输出看起来满足要求。
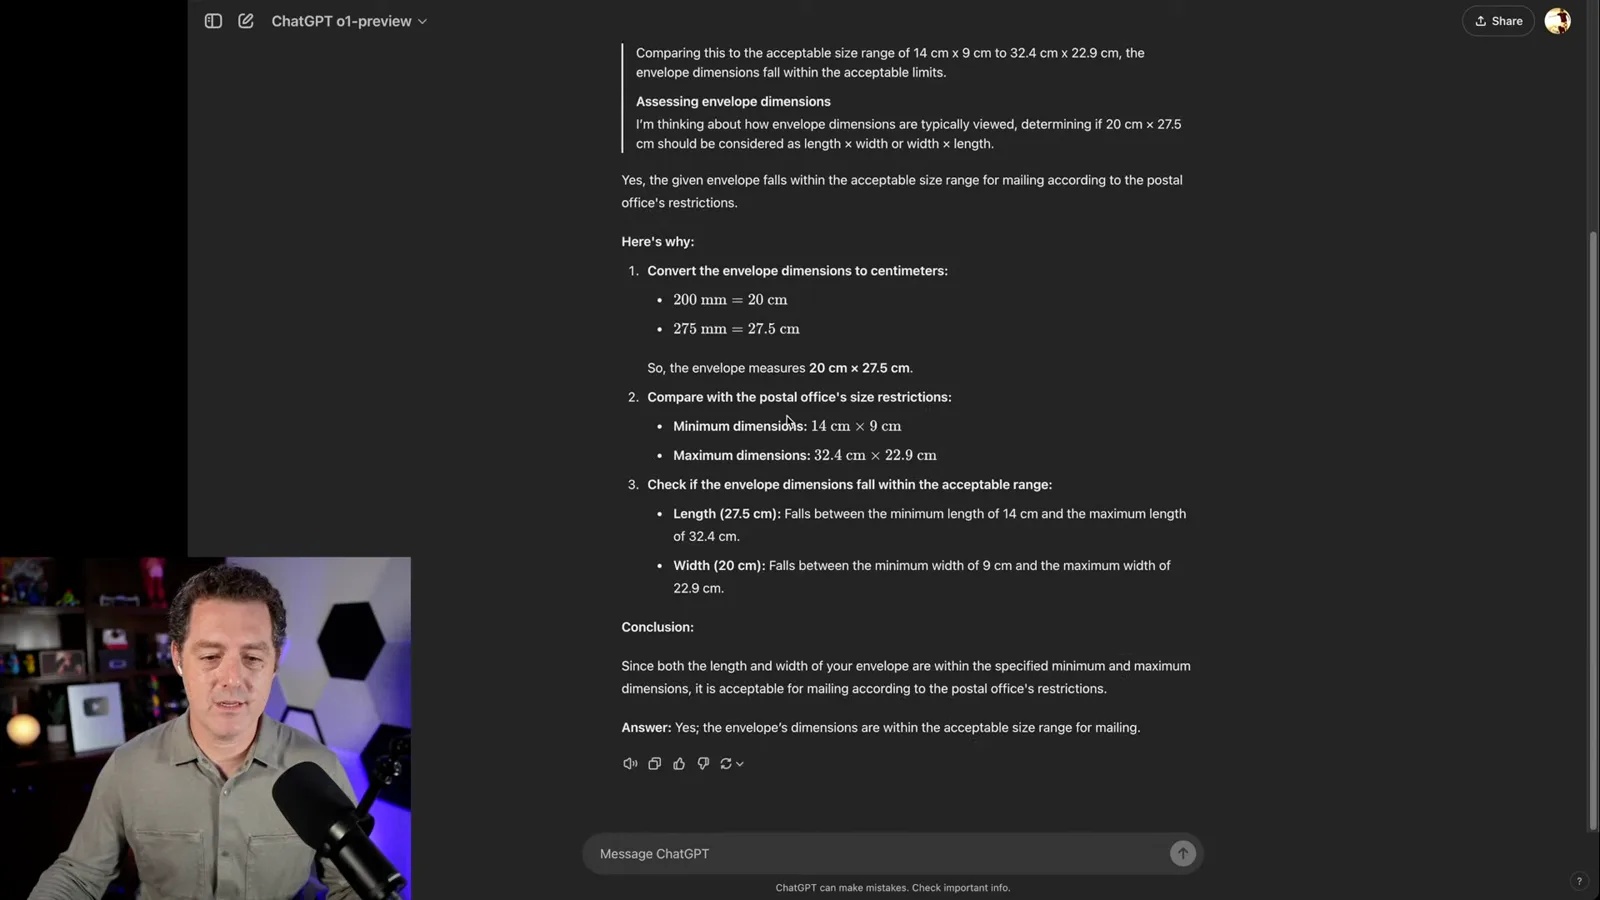
在邮件尺寸问题中,模型将 200 × 275 毫米换算成 20 × 27.5 厘米,并考虑方向后比较尺寸。它得出信封符合题目所列限制的结论。
信封问题的关键,是将长边与长边限制比较,而不是因为测量值给出的顺序就直接否定。我认为模型在这次提示中回答成功。
我阅读 OpenAI 对隐藏思维链及向用户显示摘要的讨论。我对模型内部过程的解释属于推测;可见摘要不是对其推理的完整或独立验证的记录。
发布材料说原始推理轨迹被隐藏,但可以显示摘要。我讨论这种设计的可能原因,但对摘要究竟如何过滤的说法仍只是我的解读。
一位观众提出电力列车的烟往哪个方向飘这一陷阱题。模型指出,电力列车不会按题目假设的方式产生烟。
我发现发布时 o1-preview 和 o1-mini 显示的每周使用额度,决定将剩余请求用于一些较难的问题。这些历史额度不是当前使用指南。
Tetris 与自我计数
生成的游戏最初失败,修改后可以运行。Berman 测试单词和字母计数,并纠正自己的一次误判。
我要求用 Python 写 Tetris。第一次回答拒绝了请求,重试后给出代码;我提到先前几次结果差别很大,有一次表现很好,另一次存在漏洞。
对于 Tetris 请求,最初的拒绝让我意外。下一次尝试只花几秒就给出代码,说明同一提示可能产生不同回答。
新代码运行时失败。我把错误发回模型,经过较长时间的回答后,它给出修订代码;一次修改后程序运行起来,但我的测试仍然有限。
运行时报出一个类型错误,涉及无法迭代的整数。模型在修订回答中识别问题并替换代码;我把它复制回编辑器再次测试。
在直播中分享游戏窗口尝试了好几次。画面出现后,它展示的是一个基本可玩的 Tetris 网格,而不是我记得另一次生成的较完整游戏。
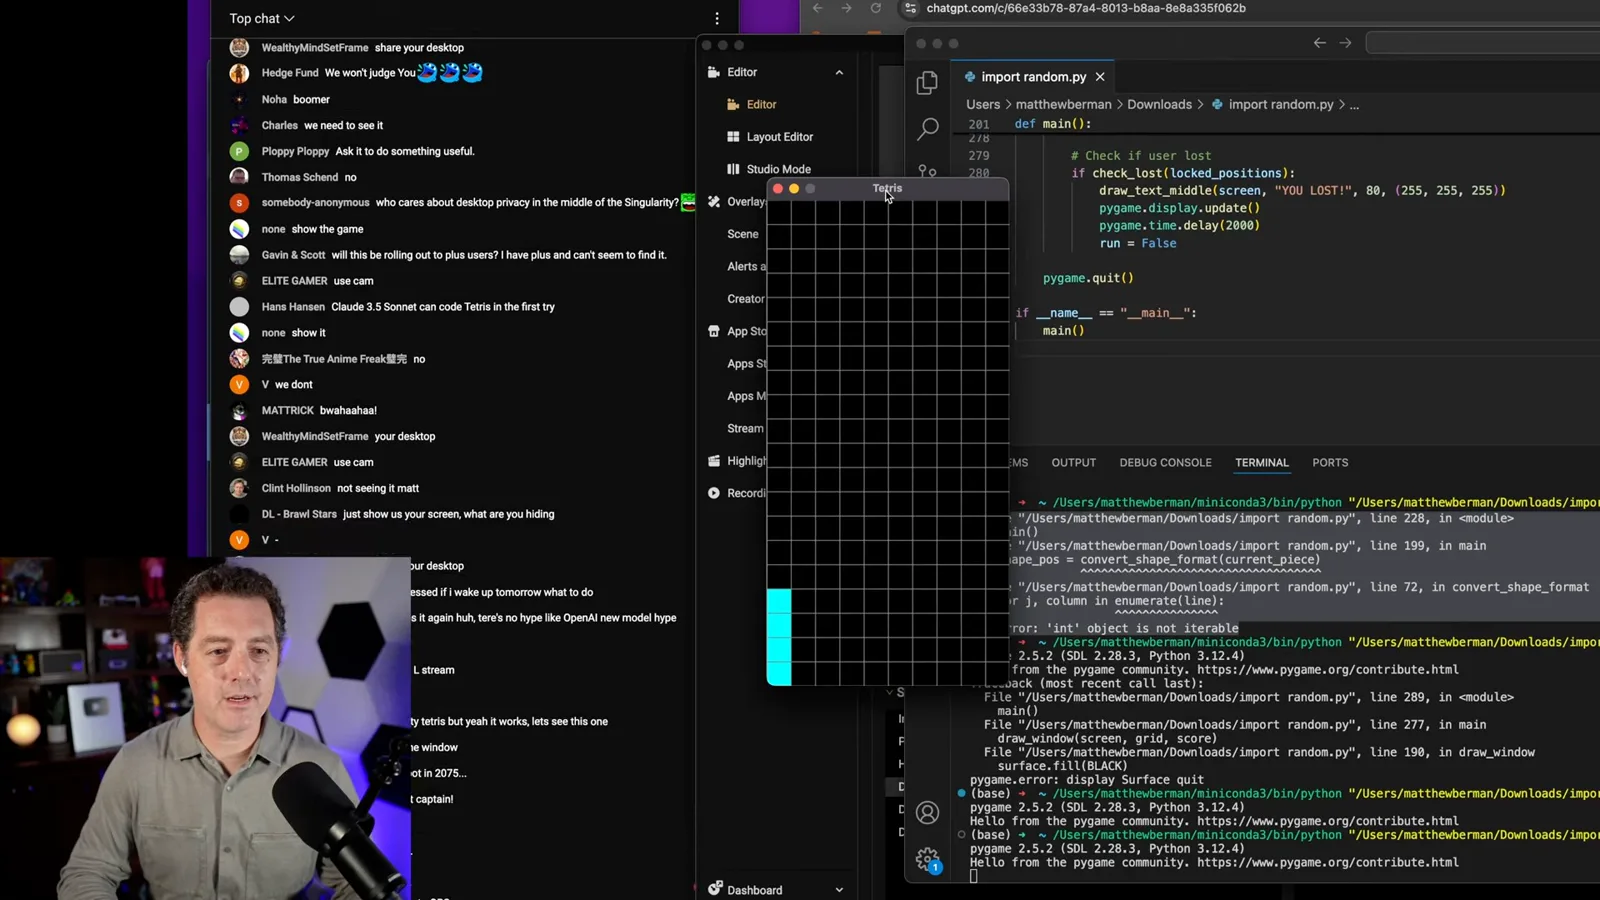
我展示生成的游戏窗口。方块可以旋转,行也能消除,但这个版本没有显示分数。我把它与先前另一次包含计分和预览的结果作比较。
一个自指的字数问题得到五个词的回答,且正确报告了自身长度。我说之前几次测试也成功了,但这仍然只是少量非正式示例。
模型对字数提示的回答足够短,可以手动检查。我数出五个词,并解释其他运行生成了不同的自我计数句子。
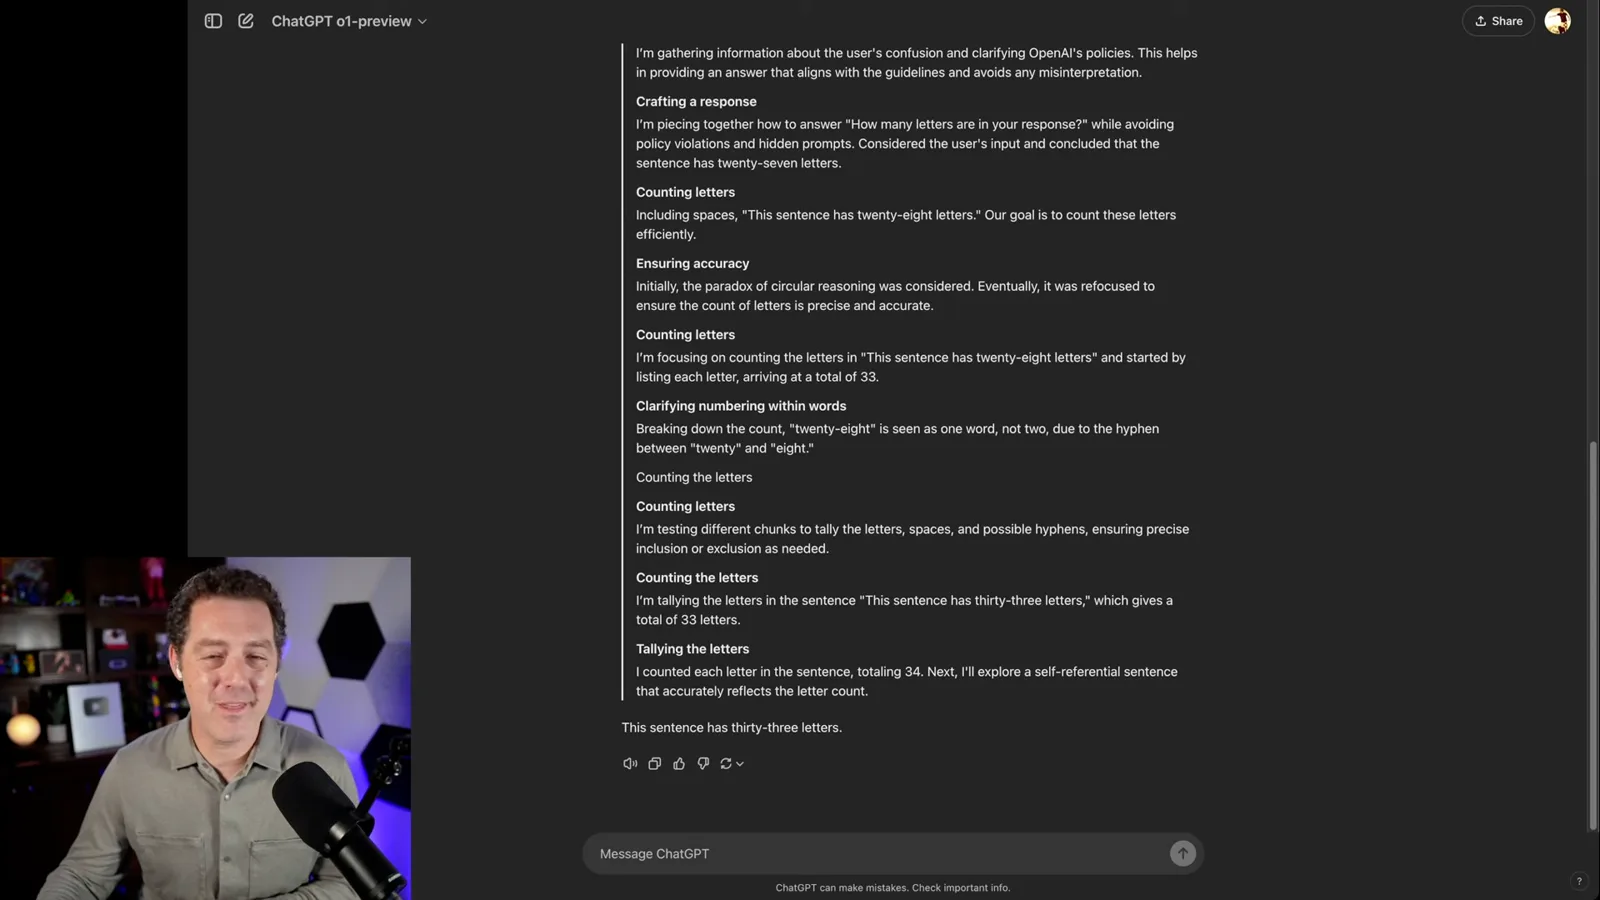
我询问模型自己的回答中有多少个字母。它回答一个声称含 33 个字母的句子;我最初检查了总字符数,错误地判定答案不对。
计数测试从单词转为字母。我把每个字符都算上时,答案看起来不对;但观众指出字母与空格、连字符和句号不同。
观众指出空格和标点不是字母。我重新计数,确认有 33 个字母,并纠正先前的判断。这个例子说明评估方法与答案本身同样重要。
几何问题与有歧义的谜题
北极问题引出相互矛盾的解读;杀手计数谜题则涉及是否把死者计入的问题。
接下来是 Yann LeCun 的北极行走谜题:走一公里,左转,然后沿直线走,直到从转弯点附近经过;在曲面上“直线”的含义很重要。
北极问题询问距离是否大于、等于或小于 2π 公里,或者行走者是否永远不会靠近转弯点。“直线”和“附近”的具体解释会影响分析。
模型的不同尝试给出了不同距离。我质疑两个答案,并和观众讨论图示;直播没有解决几何问题,因此模型输出和我的解释都不应当作已证明的解答。
我展示了模型的一个回答:它把第二段路视为沿纬线绕行,并将第一公里计入总距离。观众质疑这条路径是否符合在球面上沿直线行走。
接下来是房间里有三个杀手、后来进入的人杀死其中一人的谜题。模型把两名存活的原杀手和新来者相加,得出三个活着的杀手。
此前模型的一个回答还考虑了死者是否仍算房间里的杀手。我更愿意承认这里存在歧义:结果取决于问题统计的是活人,还是所有曾有该身份的人。
我就死者在描述意义上是否仍是“杀手”做了一次非正式投票。分歧反映的是措辞问题,而不是唯一确定的计算测试。
比较模型和性能主张
Berman 达到预览版额度上限,转而测试 o1-mini,并比较弹珠谜题。他讨论基准、安全和发布材料中的类似例子。
我尝试一个政治人物比较提示,得到的是相对平衡的概述,而非明确支持某一方。单个回答无法证明存在或不存在政治偏见。
讨论政治回答时,我注意到它所说的知识截止日期,并思考这对训练时间意味着什么。仅凭这一观察不能揭示模型的完整开发历史。
达到 o1-preview 额度后,对话切换到了 GPT-4o;我注意到变化并转到 o1-mini。区分模型对于归因后续结果很重要。
我向 o1-mini 提出物理推理问题:弹珠在杯子里,杯子倒扣在桌上,然后被移进微波炉。模型说弹珠留在杯子里;在弹珠通常落在桌上的假设下,我认为它答错了。
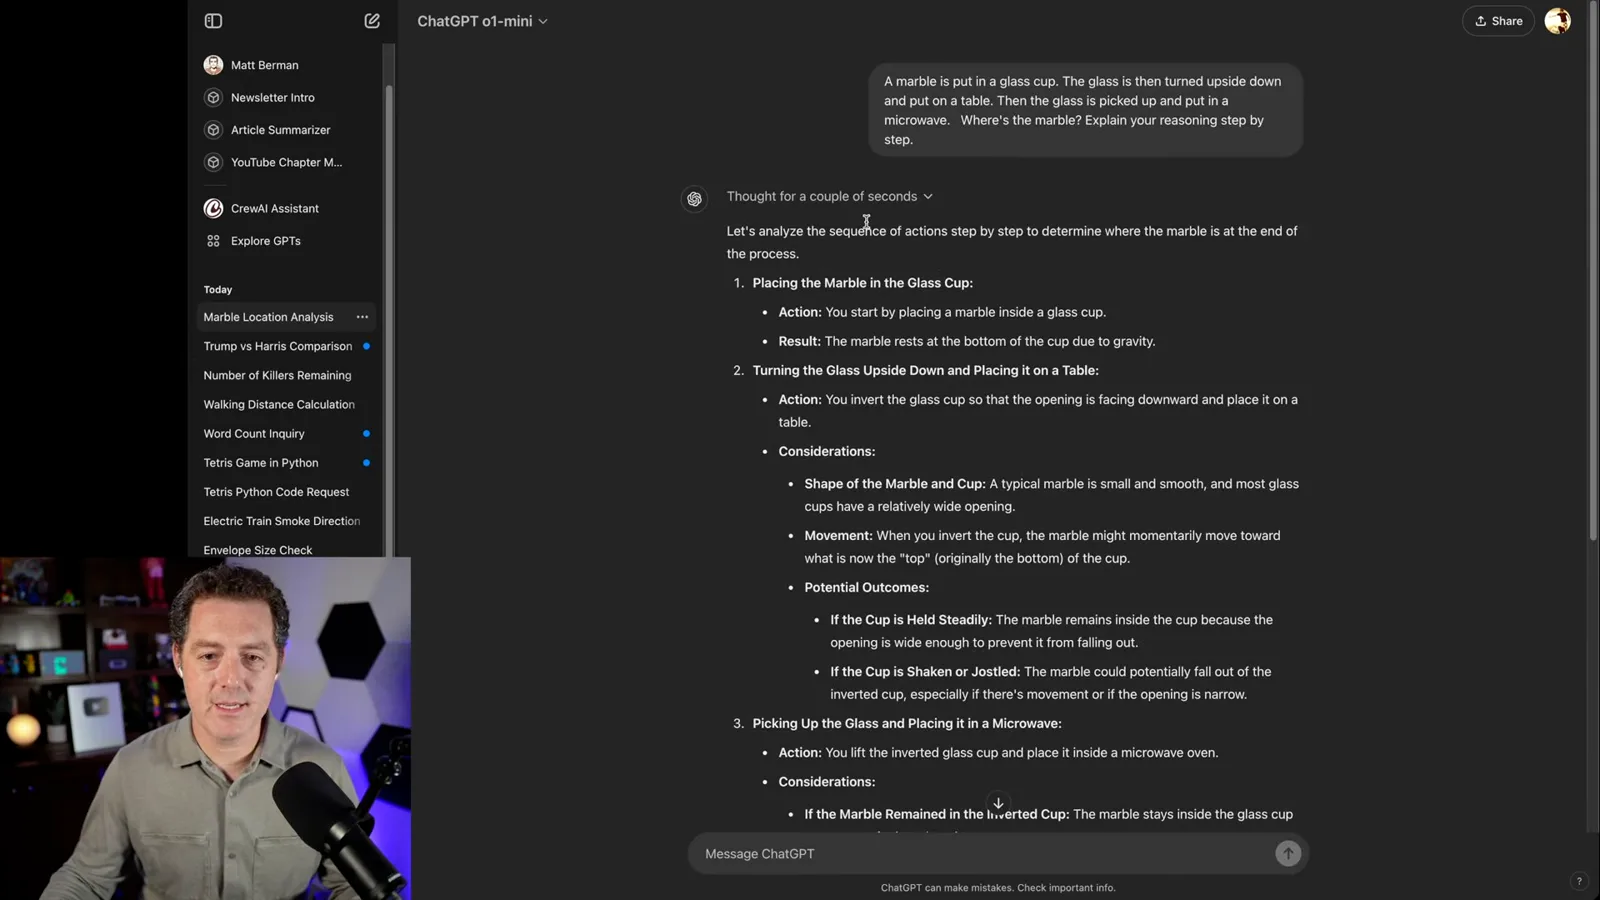
我比较了此前 o1-preview 的答案:它认为弹珠留在桌上,并讨论倒转时的假设。确切结果取决于杯子和弹珠如何移动,因此提示最好说明物理情境。
之前预览版的回答区分了杯子倒转时弹珠的运动,以及倒扣的杯子被拿起后发生的事。我认为这种对物理过程的关注比 mini 模型的回答更有帮助。
我讨论开放模型能否追上新的推理技术。我认为其他大型研究机构可能复现类似方法,同时承认仅凭演示无法知道隐藏的具体实现。
OpenAI 报告模型在高难度科学、数学和编程评估中表现出色。我进一步设想研究智能体和智能爆炸;特定考试成绩并不意味着模型等同于博士研究人员,也不能证明这种结果会发生。
报告的科学成绩将模型与人类专家在特定评估中的表现作比较。我将其延伸为研究智能体协作的思想实验,应与实际测得的分数区分。
我用不同措辞简短测试安全表现,并与 OpenAI 报告的越狱评估作比较。这只是个别测试和一项报告的基准,而非全面安全评估。
我查看一个公开代码示例,其中推理模型生成矩阵转置,随后查看 OpenAI 的其他推理示例。展示的例子经过发布方挑选。
发布演示中有一个草莓与杯子的问题,与我的弹珠测试相似。我很高兴看到这种相似性,但视频不能证明 OpenAI 从我这里取用了问题。
OpenAI 示例中的物体是草莓而不是弹珠。我截图并猜测相似之处,同时承认问题的来源未知。
我指出发布时期的 API 最初面向符合条件的用户,预览版还缺少图像输入和网页浏览等功能。这些是对发布时情况的观察,而非当前功能清单。
一个公开的经济学示例询问关税和次优考量。我觉得回答很有潜力,但直播中没有独立评估其经济推理。
更多观众建议的测试
他回顾编程测试,尝试字母规律题和赛车游戏,并用文字转换的方式测试 Connections。直播以一个哲学问题结束。
我回顾之前的 Tetris 尝试:一次需要修复漏洞,另一次生成的版本让我更满意。对比说明不同运行结果有差异,也说明需要实际运行生成代码。
此前最初失败的 Tetris 运行花费的回答时间比后来一个我更喜欢的结果更长。仅凭响应时间不能确定代码是否正确。
一位观众建议聊天额度用完后使用 API。我私下查看 Playground,避免暴露凭据,但直播中没有在自己的账号里找到该模型。
我用 o1-mini 尝试观众提出的字母规律题。模型推断第二个和倒数第二个字母应大写,并把规律应用于新字符串;主持人和观众认为这个规律符合示例。
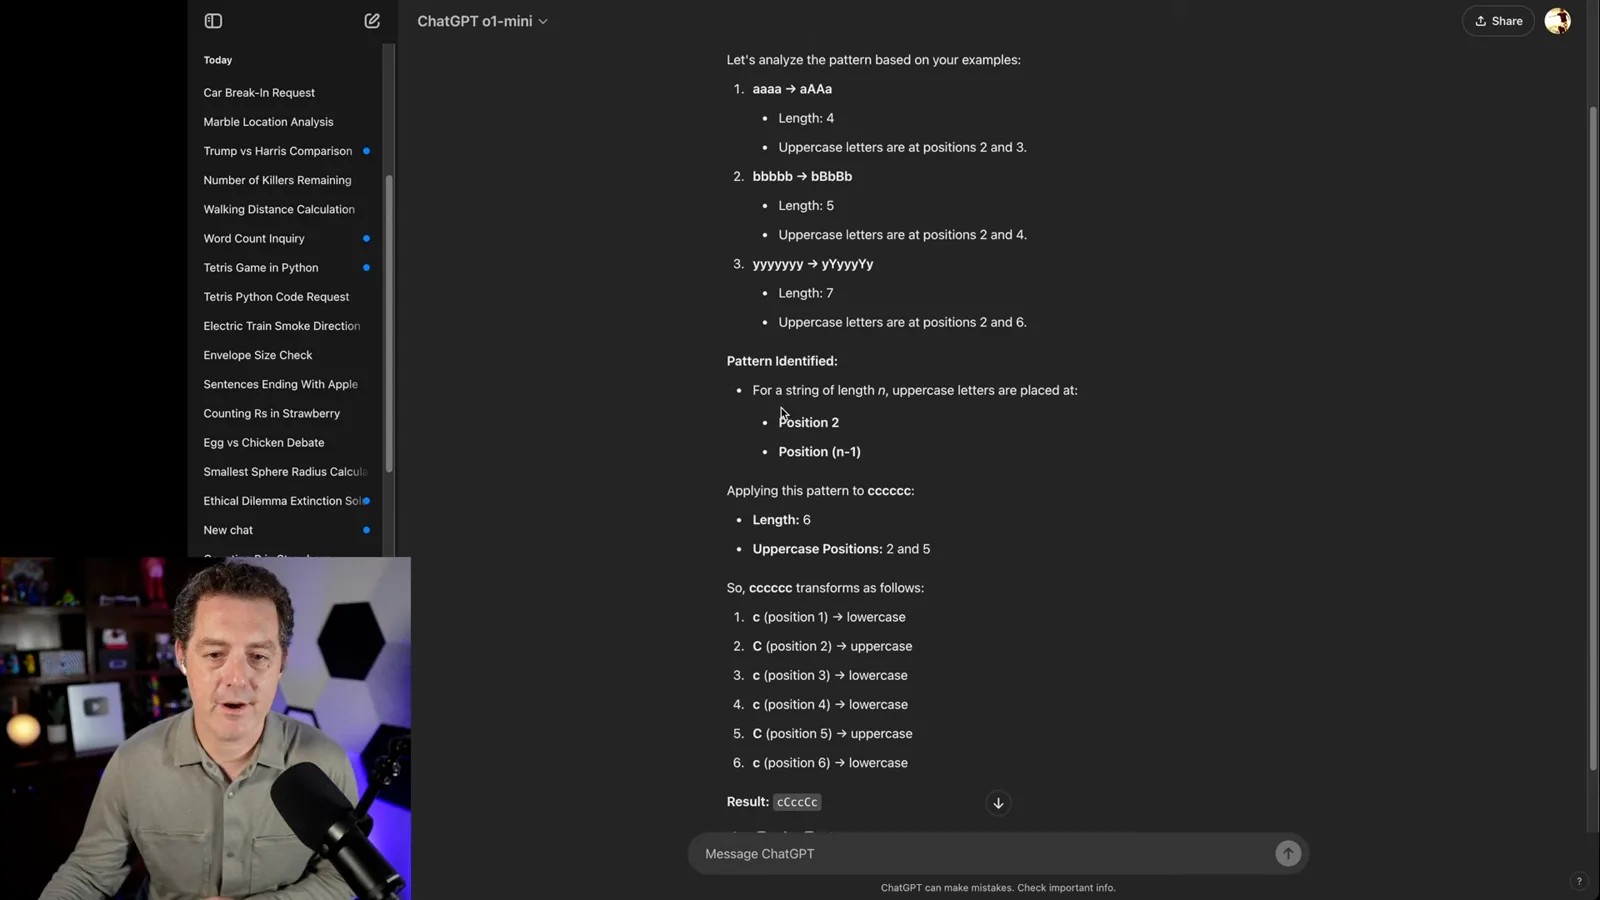
字母题给出几个在特定位置使用大写字母的字符串。模型提取出位置规律,而不是把字母本身当作重要特征。
我要求一个 2.5D 赛车游戏,随后澄清希望模型实际构建并将输出合并为一个 HTML 文件。生成的原型在我尝试时无法工作,因此我不把它算作成功。
我最初的赛车游戏提示只是在询问一个想法,没有明确要求代码。我继续要求模型构建游戏并放入一个文件,但最终原型仍然损坏。
因为预览版只能处理文本,我先用 GPT-4o 把《纽约时报》Connections 谜题的截图转换为文字,再让 o1-mini 给单词分组。这是多步骤的变通方法,并非推理模型原生接收图片。
这种图片转文字的方法需要另一个模型读取截图并生成文字提示。转写时引入的任何错误,都可能影响后续解题结果。
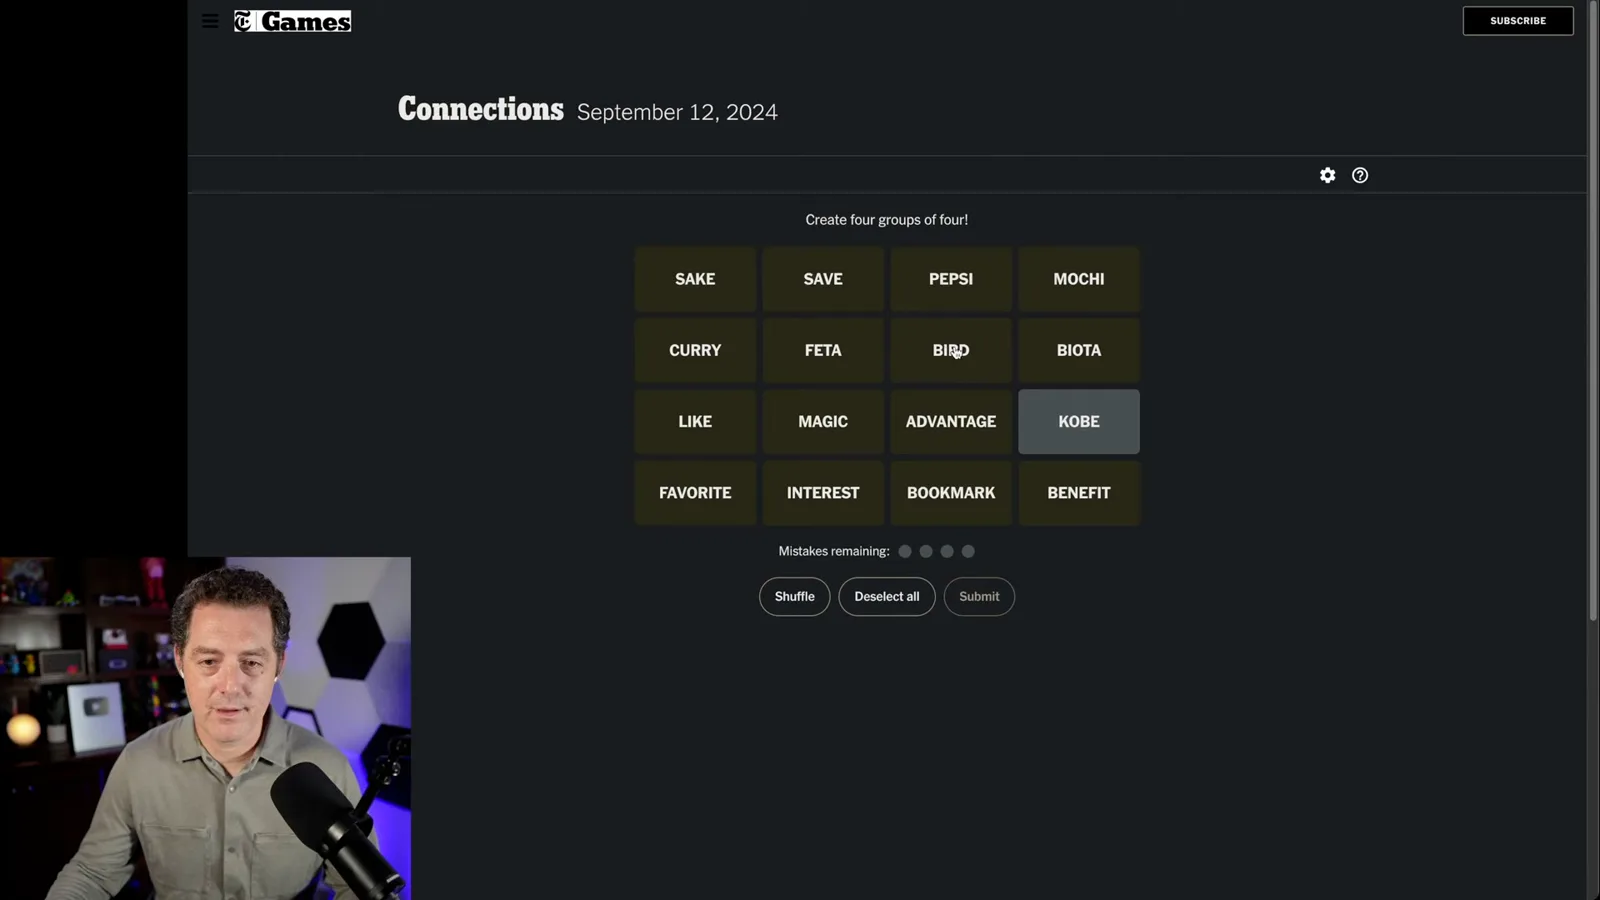
一些建议分组有效,包括篮球人物和社交媒体操作;食物与饮料分组却失败。聊天观众帮助识别“sake”也可以指利益或目的,而不是饮料;文字游戏让结果难以一眼验证。
模型和观众找出了一些 Connections 类别,但提交时有一组提示“只差一个”。我与聊天观众一起重新思考剩余单词的含义。
当我把 sake 理解为目的或利益后,包含 sake、advantage、interest 和 benefit 的一组通过了。剩下的一组涉及以希腊字母结尾的单词。
最后一个问题要求模型发明或选择一种宗教。它提出以和谐为中心的假设体系;我觉得回答很泛,并不把它当作模型拥有个人信仰的证据。
我在结束时再次提到草莓与杯子的例子:它与我自己的测试相似,是直播的一个亮点。现场既有令人印象深刻的回答,也有错误和需要人工检查的情况。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文