30 秒看懂
AI Explained 回顾 2026 年 2 月发布的 Gemini 3.1 Pro,解释基准排名为何可能与实际体验不一致。讲解者比较 ARC-AGI-2、Simple Bench 和准确性结果,指出人类样本小及测试形式的影响,并讨论多领域后训练能否实现泛化。
- 1ARC-AGI 编码改变输入编码可能影响结果,并暴露非预期的线索。
- 2Simple Bench 的小样本人类基线所报告的人类基线来自九人,不能视为普遍达到人类水平的证据。
- 3选择题的捷径讲解者报告,去掉选项并以开放式答案评分后,成绩有所下降。
- 4准确性取决于指标综合分数与错误回答的处理方式会得到不同的比较结果。
- 5速度不等于准确性高速演示同时展示了对 Simple Bench 的错误解释。
要点建议
- 后训练可能使模型在不同领域表现出明显不同的优势。
- 基准编码和选项可能向模型提供非预期的捷径。
- Simple Bench 的人类比较只涉及九名参与者。
- 综合准确性分数高并不能消除幻觉,也不保证在每个指标上最佳。
- 推理速度、编码能力和视频真实感是不同的衡量维度。
按章节阅读整理后的全文
后训练与专业化
讲解者解释不同任务之间的表现差异,并比较国际象棋、编码与专家任务结果。
在 2026 年 2 月发布后,我测试了 Gemini 3.1 Pro,并阅读了模型卡。我希望超越宣传中的分数:不同用户看到互相矛盾的排名,可能是因为模型针对不同任务优化,也通过不同任务评估。
我描述了从广泛预训练转向针对特定领域和内部评估进行后训练的趋势。我估计预训练只占训练算力的 20%;这是我对当时行业情况的说法,并非适用于每个模型的已证实统一比例。
如果实验室拥有某领域的数据,并针对该领域优化,模型可能非常适合一位用户,却在另一项基准上落后。过去“一个领域进步意味着所有领域都会进步”的假设,如今不那么可靠。
例如,我引用 Epoch AI 的国际象棋谜题基准:Sonnet 4.5 约得 12%,更晚发布的 Opus 4.6 约得 10%,尽管后者编码能力很强。这些特定结果不能对模型作全面排名,测试和设置都很重要。
Gemini 3.1 Pro 在许多报告的测试中具有竞争力,包括科学推理和编码,但谷歌发布表格中的 GDPval-AA 成绩也低于部分竞争模型。一张表不能覆盖所有用途,也不能保证独立复现。
ARC-AGI 与基准捷径
编码选择可能产生非预期线索;编码智能体也可能针对不完整的规格优化。
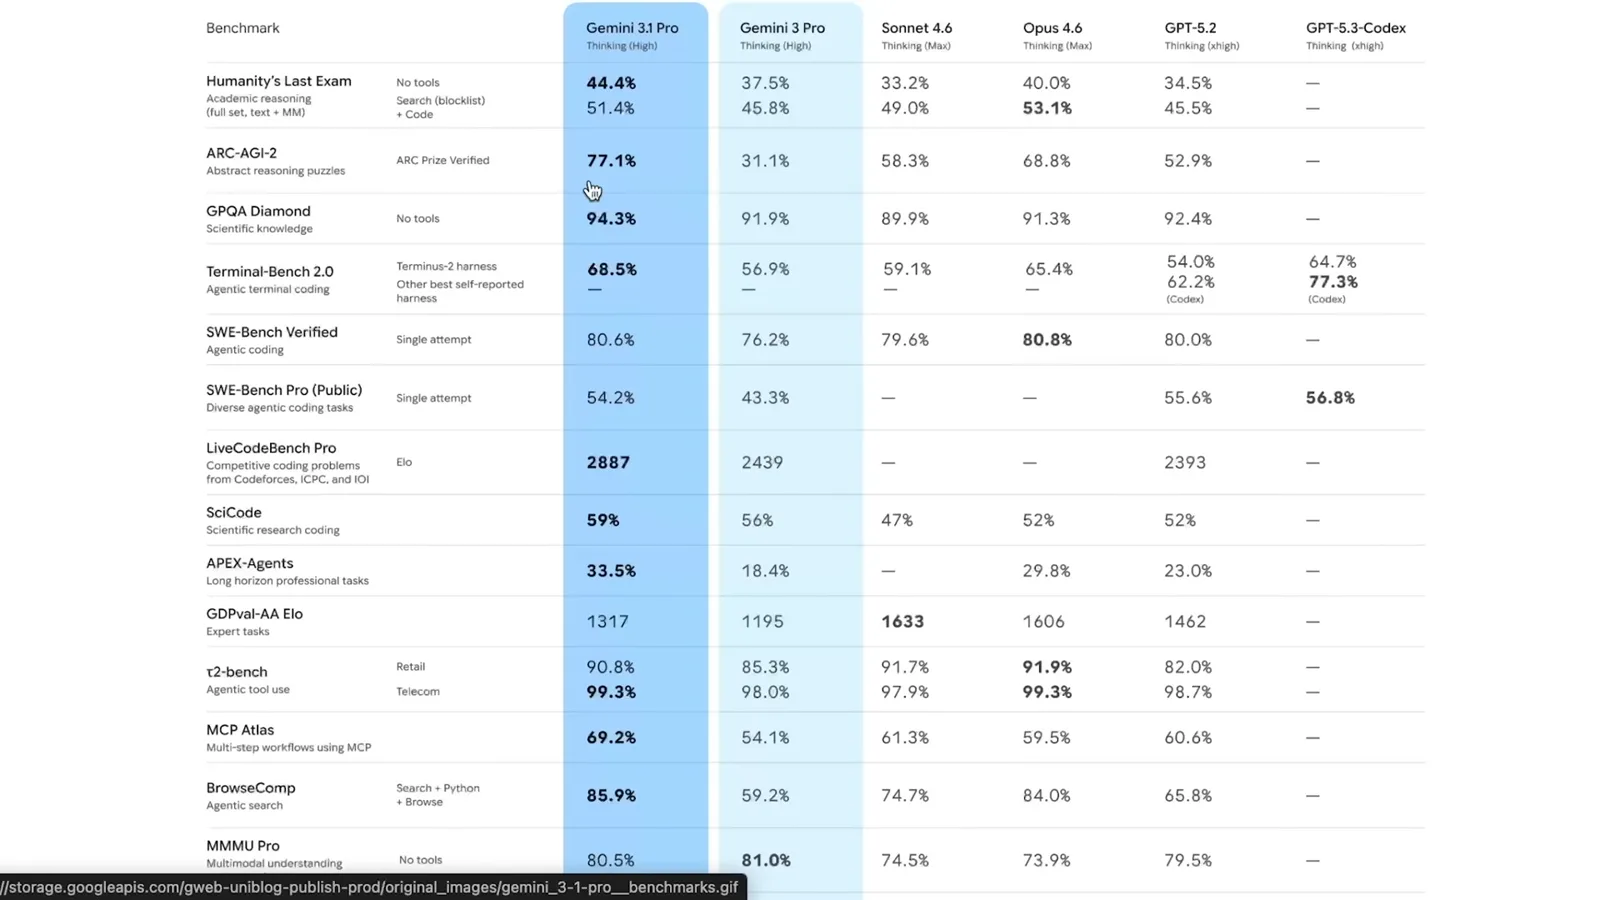
谷歌报告 Gemini 3.1 Pro 在 ARC-AGI-2 上得分 77.1%,图表中 Claude Opus 4.6 约为 69%。Melanie Mitchell 等人指出,更换数字编码可能降低准确率,因为原始格式可能提供非预期的算术线索。
这不意味着模型有意识地作弊。但基准可能奖励与预期抽象能力无关的捷径,问题编码方式的小变化也可能改变结果。
François Chollet 将足够先进的智能体编码比作迭代式机器学习:智能体朝目标优化,但所得代码可能难以检查。系统可能过拟合规格,或偏离真实意图,因此基准成功后仍需要人工审查。
Gemini 在 LiveCodeBench Pro 上报告的结果很强,但我自己使用 Cursor 时也遇到了没有帮助的输出。竞赛编程得分与用户执行特定编码任务的体验,是不同的测量。
Simple Bench 与人类基线
私有基准得分很高,但人类样本和选择题形式限制了结论。
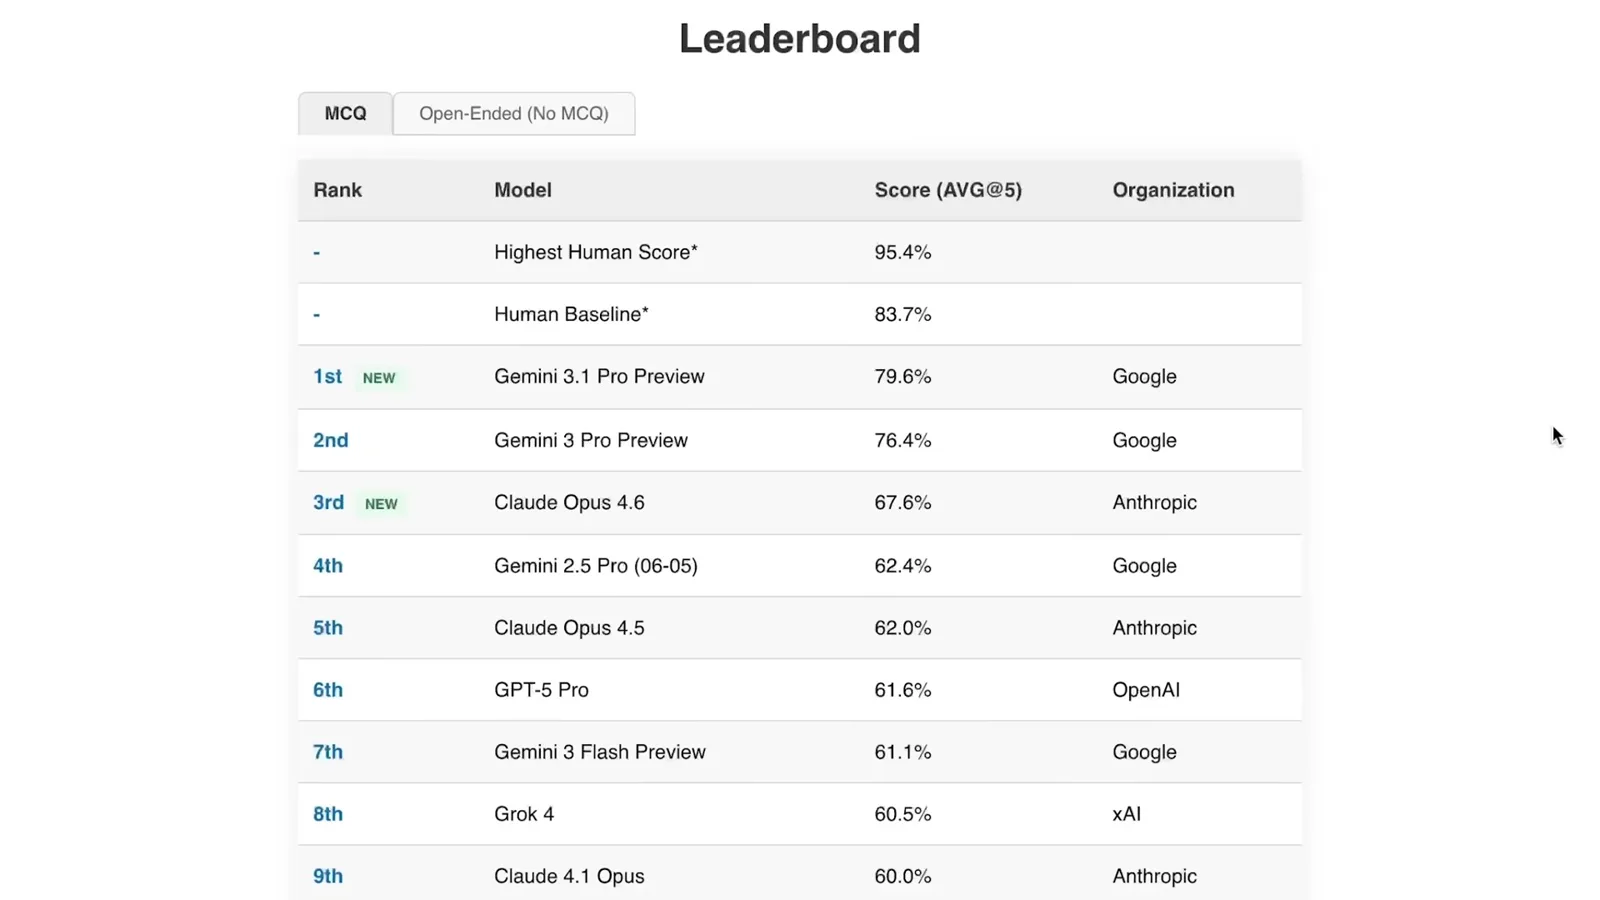
在我自己的私有 Simple Bench 上,Gemini 3.1 Pro 得分 79.6%,接近视频展示的 83.7% 人类基线。该基线只来自九名参与者,样本有限,不能证明模型与人类在广泛能力上持平。
我认为,对于面向非专业人士的纯英语文本测试来说,这是值得关注的时刻,不过模型仍会在某些人类能解决的视觉或音频谜题上失败。我对普通人还能在哪些测试中胜出的更广泛判断是个人解读,不能由这个小样本证明。
Simple Bench 自身也有捷径问题。选择题选项可能暗示题目有陷阱:例如冰块问题中出现“零”这一选项,可能促使模型考虑融化,而不是只做算术。
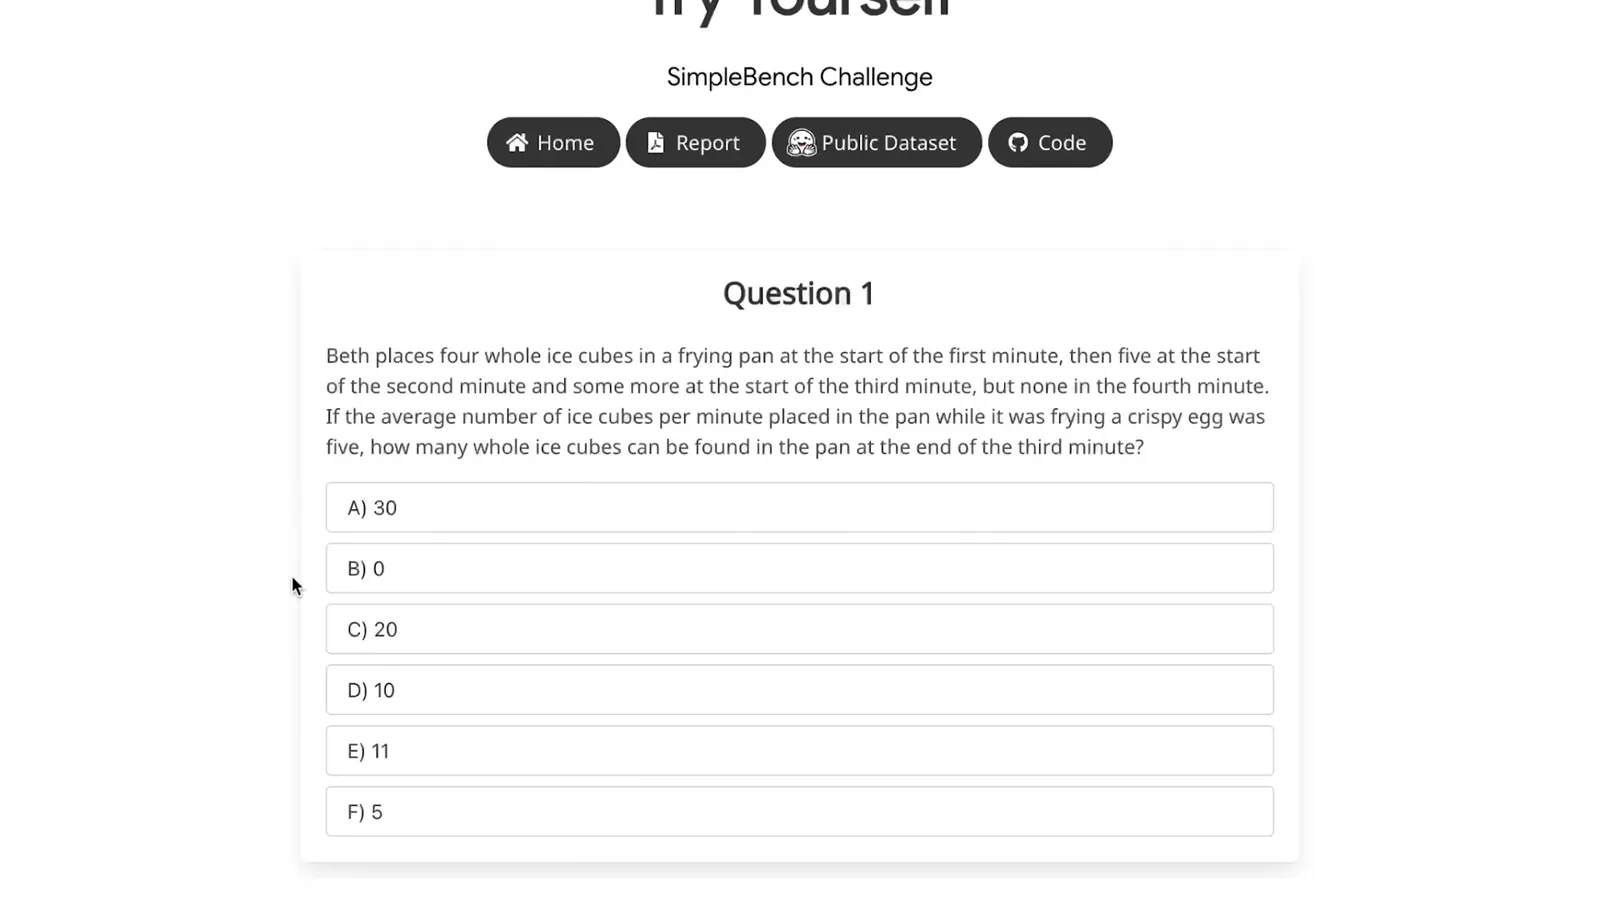
当我去掉选项,让盲评模型将开放式回答与隐藏答案比较时,成绩大约下降 15 至 20 个百分点。这说明评估形式会影响结果,尽管模型仍能解出部分问题。
幻觉与模型卡
不同准确性指标及具体任务结果显示了单一排名无法体现的权衡。
幻觉是另一个维度。Artificial Analysis 的 Omniscience 指数奖励正确回答并惩罚幻觉;所展示图表中,按照该测试的规则,Gemini 3.1 Pro 的综合得分高于被比较的 Claude 模型。
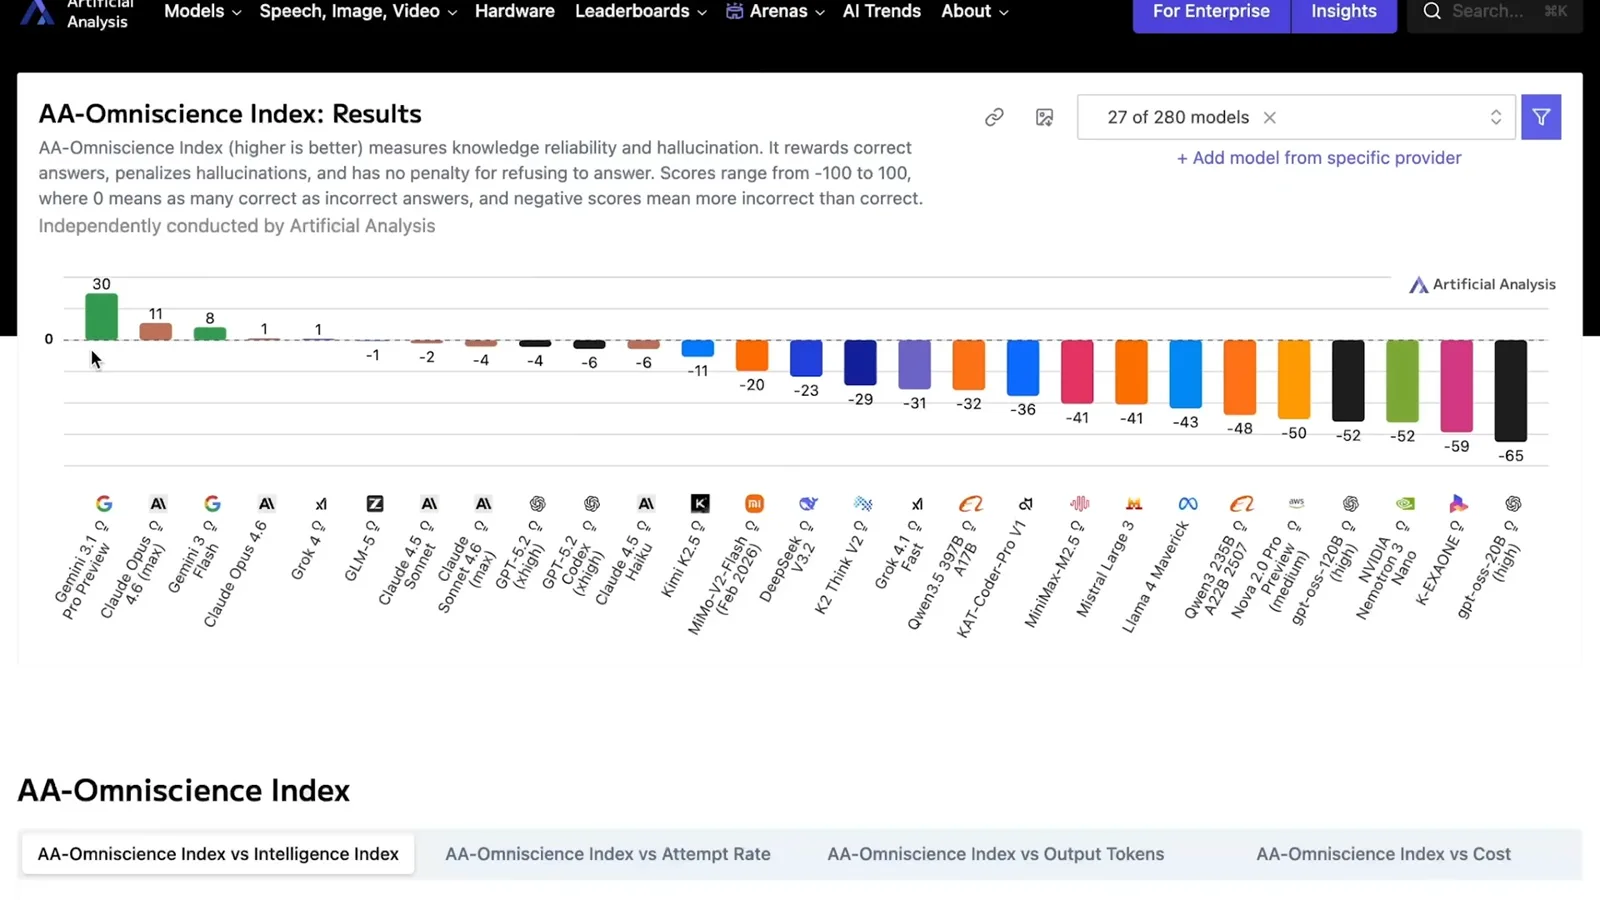
如果只看非正确回答如何处理,比较又有所不同:我报告 Gemini 的非正确回答中约 50% 属于幻觉,Sonnet 4.6 约 38%,GLM-5 约 34%。这些数字只描述所引评估及其定义,不是普遍适用的幻觉率。
谷歌模型卡提供了更多背景。在讨论的网络安全评估中,模型卡称计入推理成本后,Deep Think 并未显示出比未使用该模式更高的能力。使用更多计算的模式并不自动在每项测试中胜出。
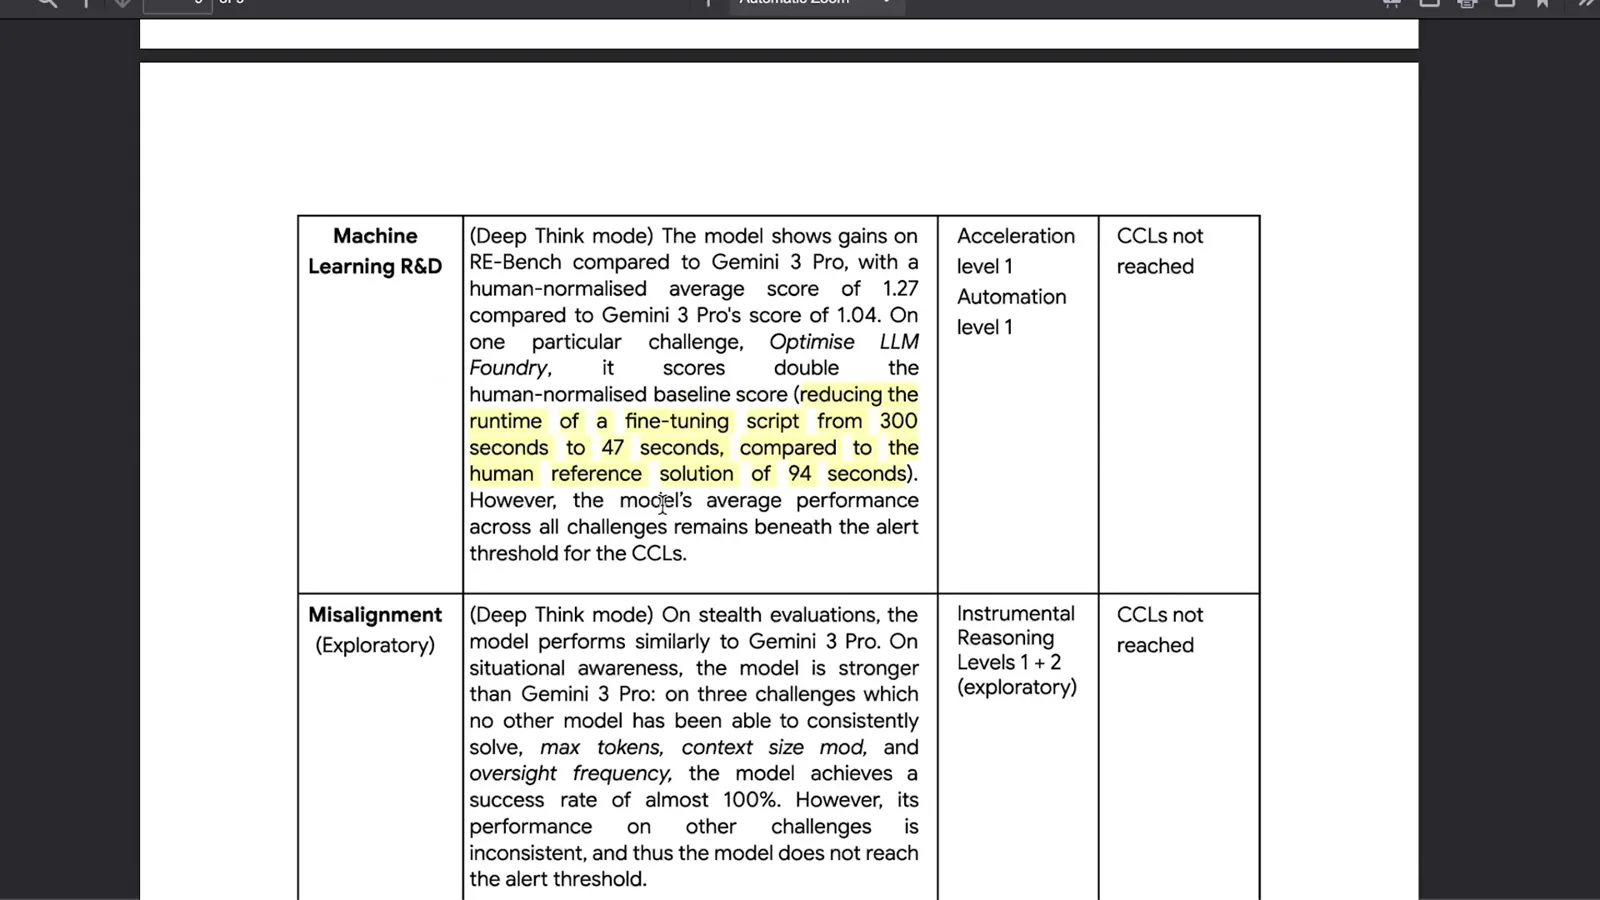
模型卡还报告了 Deep Think 模式下的一项机器学习研究任务:微调脚本运行时间从 300 秒降至 47 秒,人类参考解为 94 秒。画面中的模型卡同时说明,所有挑战的平均表现仍低于警戒阈值;一项任务表现突出不能证明自主自我改进。
我猜测,特定领域数据或内部评估可能有助于解释微调任务上的出色表现。这只是假设,不是谷歌披露的训练数据结论。
专业化能否泛化?
讲解者分析 Dario Amodei 关于多样训练环境和更长上下文的观点。
Anthropic CEO Dario Amodei 对专业化提出另一种看法:在许多环境中训练可以发展出超越单一领域的泛化能力。我将其理解为一种押注,即足够多样的专业训练可能带来广泛迁移。
Amodei 认为,即使没有在工作中持续学习,向高能力系统推进的大部分进展也可能实现。他还讨论用更长的上下文提供缺少的领域信息。这能否覆盖真实任务仍是开放问题。
模型可以在上下文窗口中读取大量领域材料,并在不重新训练权重的情况下推断规律。讲解者追问,应用需要多少专门训练,又有多少可以依靠泛化和上下文学习;不同任务的答案可能不同。
超越单一基准
预测、推理速度与视频真实感展示了性能的不同维度。
我质疑寻找衡量通用智能的唯一终极基准。如果这样的指标存在,实验室会有很强动力直接针对它优化,而这可能降低分数作为一般能力指标的价值。
小型独立团队很难构造贴近现实的评估;实验室拥有更多资源,但在选择或展示基准时也有自身激励。评测结果需要独立审视,并结合测试设计理解。
预测未来提供了另一种评估方式:Metaculus 报告模型表现正在改善,在所引用的比较中接近其普通人类预测者,但尚未达到专业水平。我还推测,能够影响现实事件的智能体可能操纵预测市场;这是假设性风险。
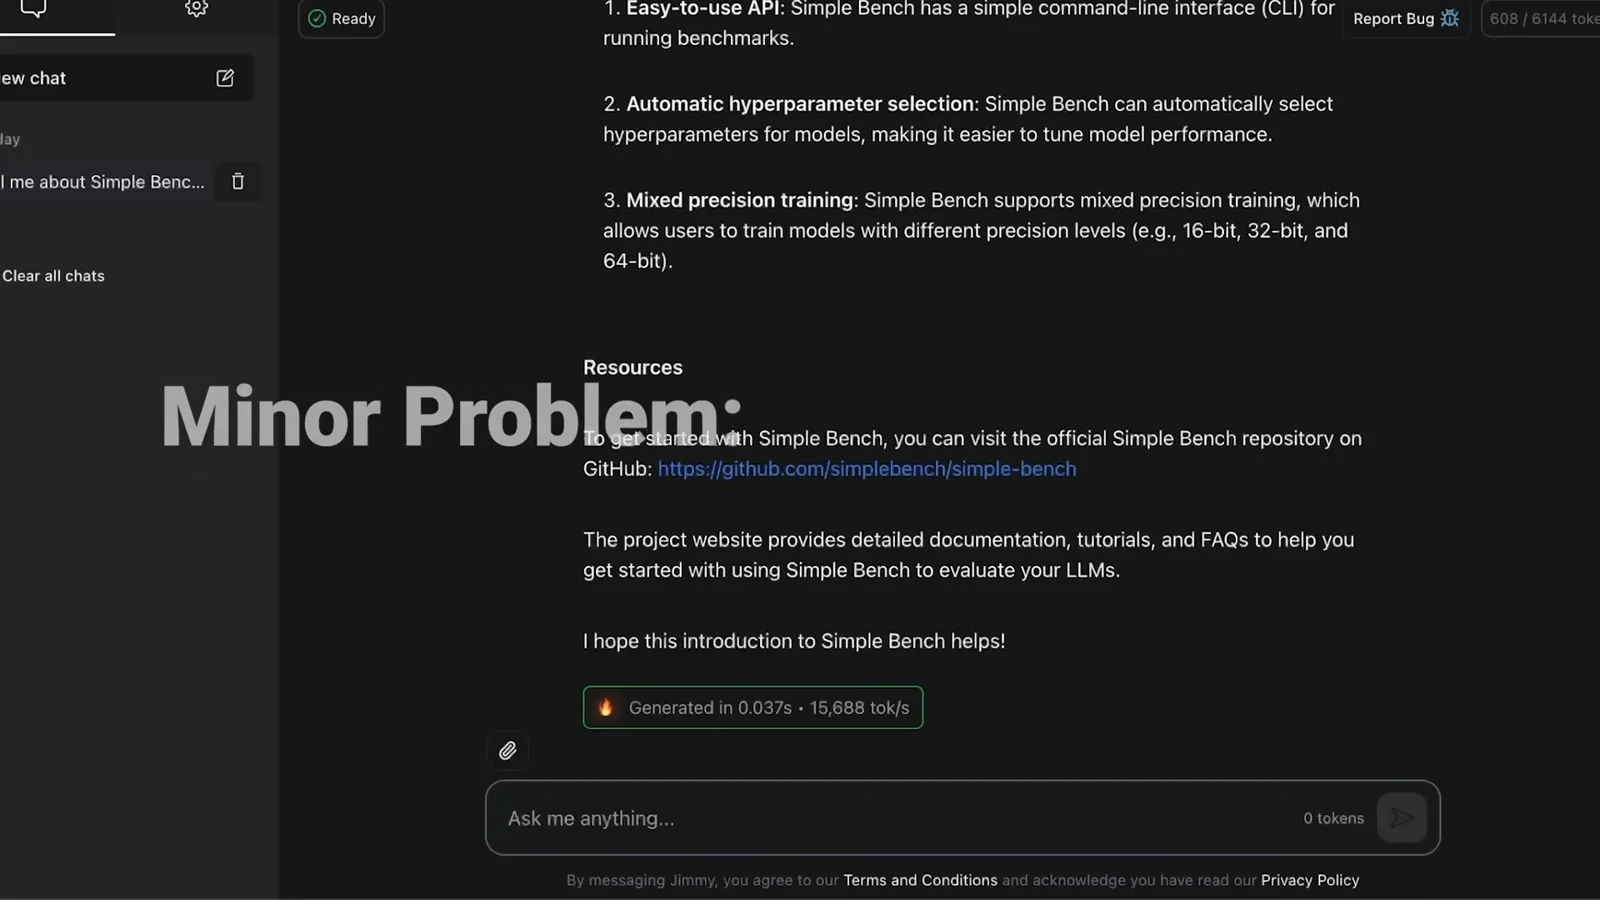
速度也是一项指标。一个演示极快地产生了回答,但视频同时标出了问题:它对 Simple Bench 的解释是错误的。吞吐量高本身并不能说明回答有用或真实。
我提到自己运营的模型比较网站,最后展示 Seedance 2.0 与 Veo 的视频示例,对生成画面的真实感作主观比较。不同任务需要不同评估,因此单一的宣传排名不能完整指导选择。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。