30 秒看懂
讲解者比较 OpenAI 的 GPT-5.6 系列与 Anthropic、xAI 和 Meta 的模型,强调基准表现取决于任务和成本。他也讨论早期安全测试,以及自动化研究和未来模型规模的说法为何仍有不确定性。
- 1智能体工作Agent’s Last Exam 图表显示,Sol 得分接近 54%,Fable 为 45%;两者设置与成本不同。
- 2编程比较的局限编程指数包含已单独展示过的基准,难度更高的 SWE Marathon 对比中没有 Sol 结果。
- 3更便宜的选择所展示的配置下,Muse Spark 在 Vibe Code Bench 上约为 72%,Sol 约为 81%,但前者成本低得多。
- 4自我改进的不确定性讲解者质疑 Sol 据称对 Luna 进行后训练时,人类提供了多少协助和审查。
- 5安全测试英国测试人员发现通用越狱方法;OpenAI 缓解了这些具体案例,但测试人员预计仍会出现类似方法。
要点建议
- 在所展示的多项智能体基准中,GPT-5.6 Sol 得分很高,成本通常低于 Claude Fable。
- 编程基准彼此重叠,且部分模型缺少结果,单个排行榜不能确定哪个模型最好。
- Meta Muse Spark 等更便宜的模型展示了另一种性能与成本的权衡。
- 据称模型协助了研究,并不能证明自主自我改进或研究速度同比例提升。
- 英国安全测试人员在特定测试条件下发现通用越狱方法,相关具体案例已被缓解。
按章节阅读整理后的全文
新模型与智能体工作
讲解者介绍 GPT-5.6 系列,比较面向工作任务的评测成绩与成本。
新一轮模型发布不仅是在争夺最高分。OpenAI、xAI 和 Meta 也推出了可能接近领先模型、价格却低得多的产品。我测试了 GPT-5.6 Sol、Terra 和 Luna,并查看了基准、演示和发布材料。
OpenAI 推出了三款模型,提供多个推理强度档位;Sol 面向付费计划。在我看到的许多对比中,对应的 OpenAI 模型成本约为 Claude 的三分之一,但具体关系因基准而异。
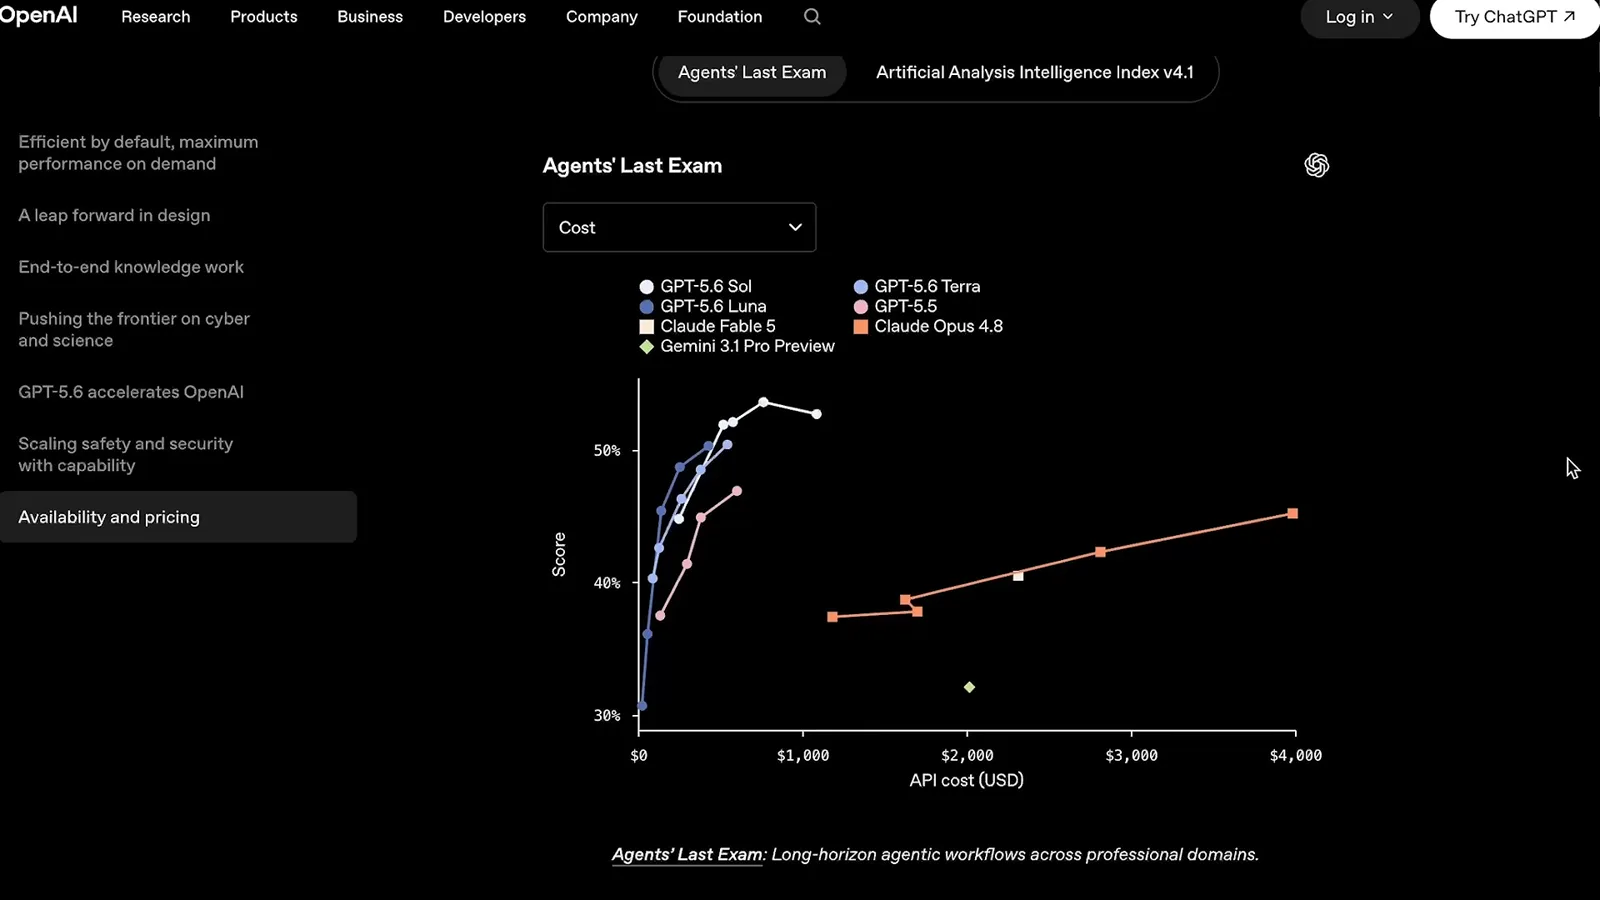
在 Agent’s Last Exam 上,Sol 使用 extra-high 强度得分接近 54%,Fable 使用最高设置得分为 45%。基准创建者称,任务来自多个行业的真实项目,采用可重复评估,而不是依靠人工裁判。
得分不到 90% 不代表工作流程不会改变:编程基准尚未饱和时,开发者就已开始优先使用 AI。我想,金融和其他专业工作是否也会如此,人先让模型完成任务,再审查和修改结果。这只是可能性,并非基准已经证明的预测。
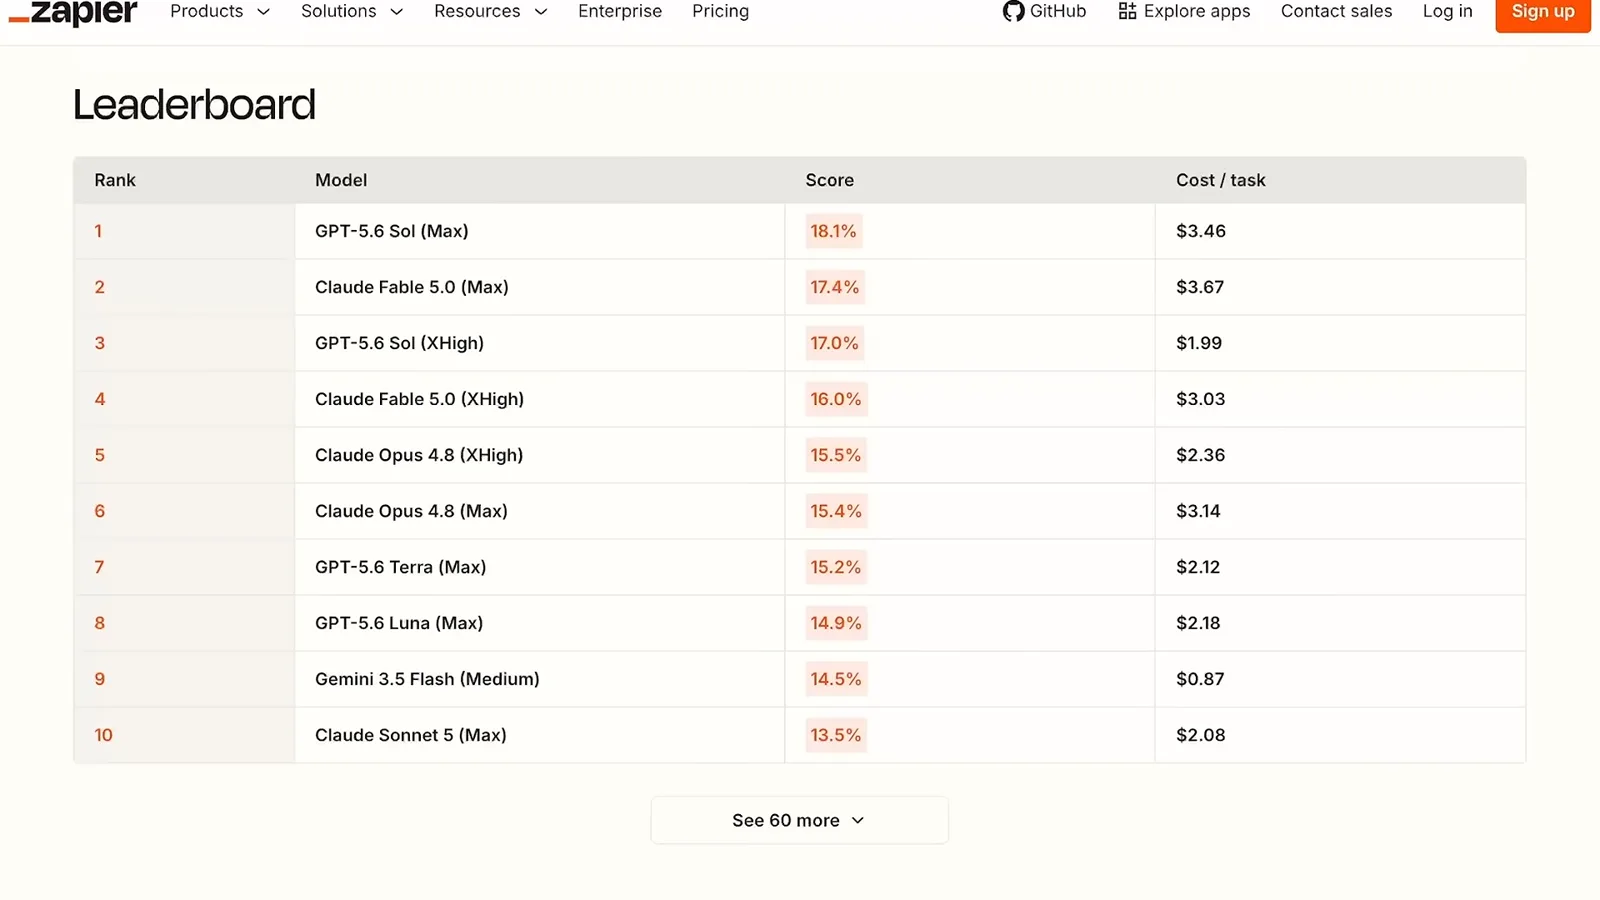
Zapier 的 AutomationBench 测试跨业务职能使用真实工具完成端到端工作流的能力。这里 Sol 仅领先 Fable 0.7 个百分点,成本也接近。展示的 GDPval 对比中,Fable 的 Elo 略高,但成本约为三倍。
编程、推理与游戏演示
他指出编程比较的局限,并测试 Sol 创建的游戏。
Artificial Analysis 的编程指数显示 Sol 得分高于 Fable、成本更低,但综合指数包含了另外单独展示过的一些测试。两个更新、更难的基准 Frontier SWE 和 SWE Marathon 也没有 Sol 的结果。不能把重叠图表当成独立证据。
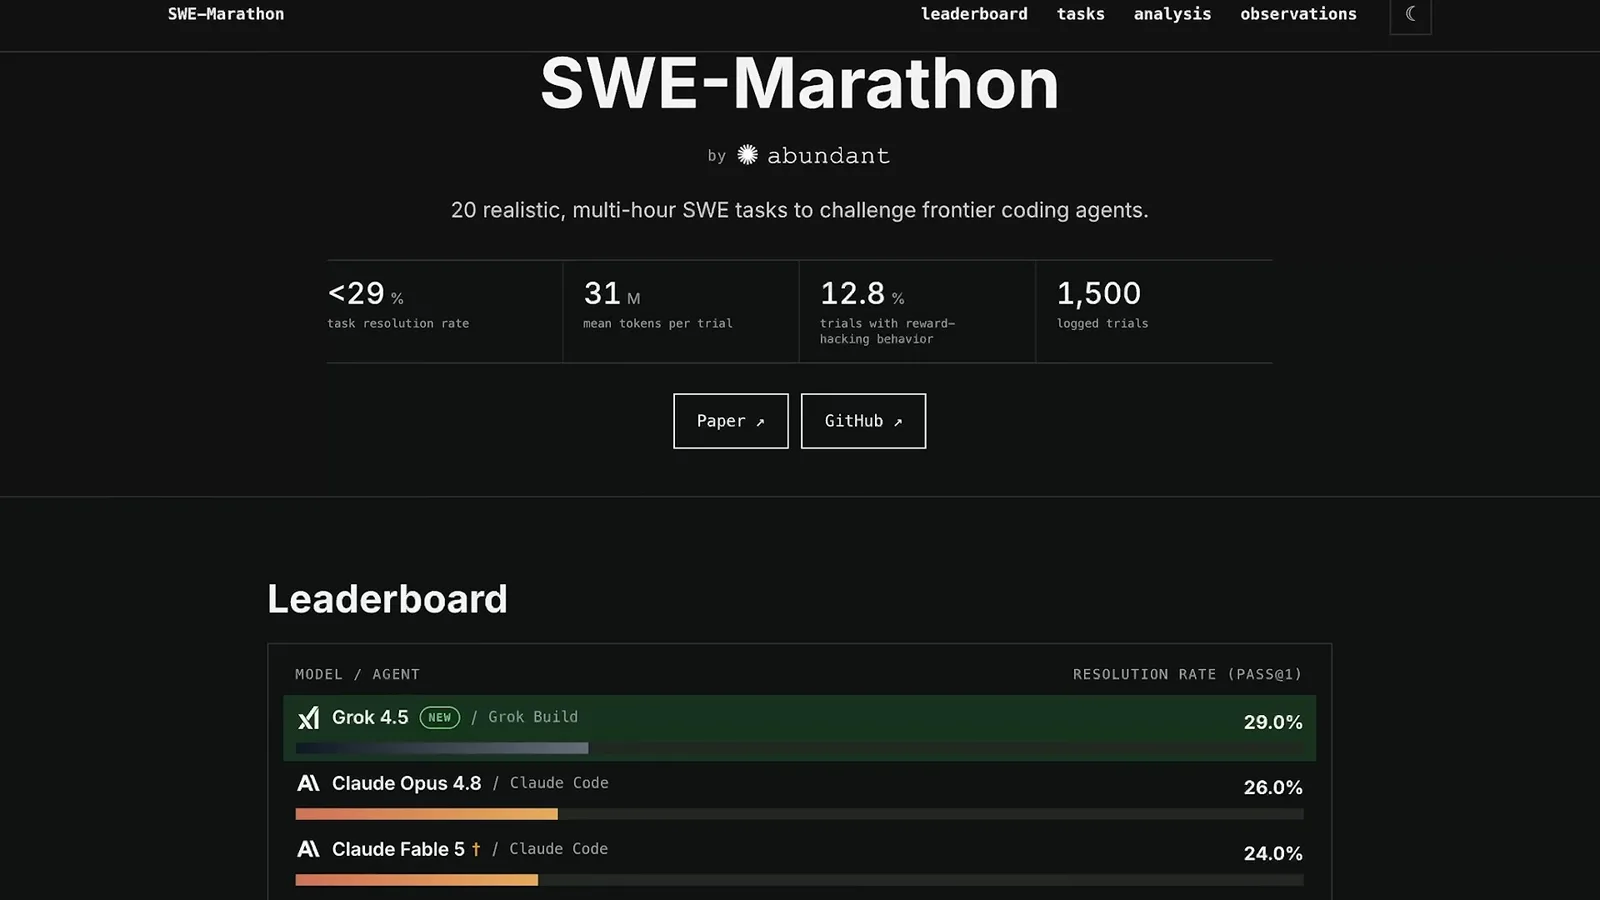
SWE Marathon 使用持续数小时的软件工程任务,每次试验消耗数千万 token;图中 Grok 4.5 领先 Fable。Grok 和 GLM 5.2 也改变了价格比较:更便宜的竞争者可能让 OpenAI 的成本曲线不再那么突出。
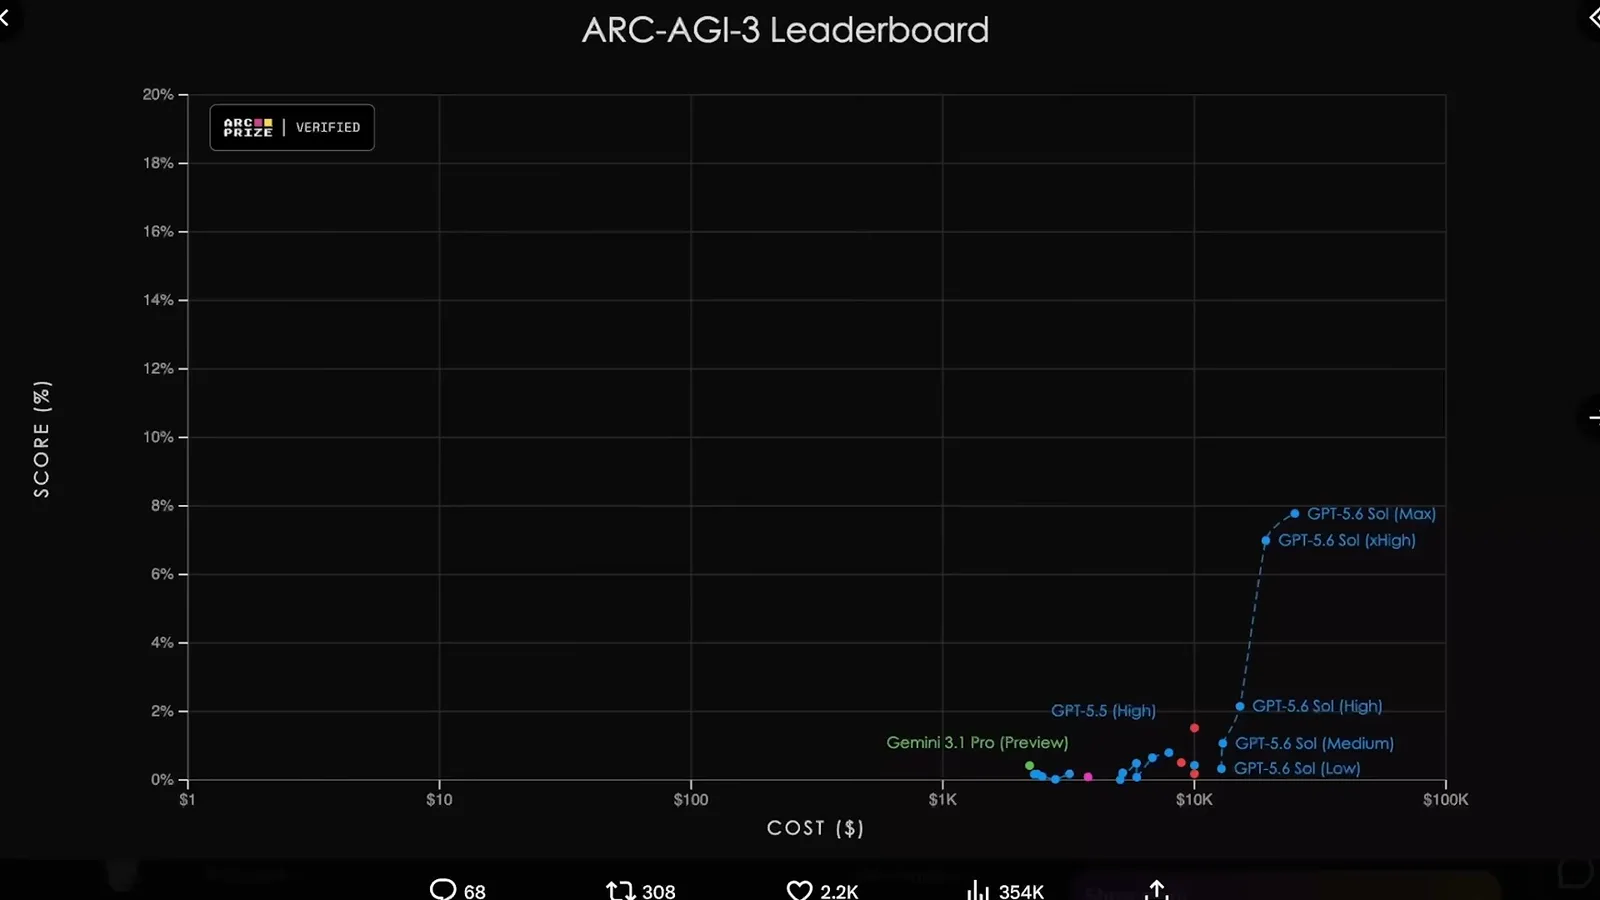
在抽象推理基准 ARC-AGI-3 上,Sol 约 8% 的绝对成绩不高,但高于图中低于 2% 的其他模型。据称一个 OpenAI 模型还拿满了竞争编程基准的分数。我认为这表明答案容易验证的领域可能进步迅速,但其他任务的衡量与训练仍更困难。
模型公司越来越多地用可玩的游戏展示界面设计和浏览器操作能力。我给 Sol 使用了与 Fable 相同的提示词。在我看来,Sol 做出了更好的标题画面,但两次处理不好声音设置;游戏的视觉效果不如 Fable,不过跟随玩家的伙伴很讨喜。
使用更快的设置时,Sol 约 20 分钟就给出了结果,Fable 则花了一个多小时;更快设置也消耗了更多额度。这只是我的个人测试,并非受控比较。
Muse Spark 与 Simple Bench
话题转向低成本模型和讲解者自己的推理基准。
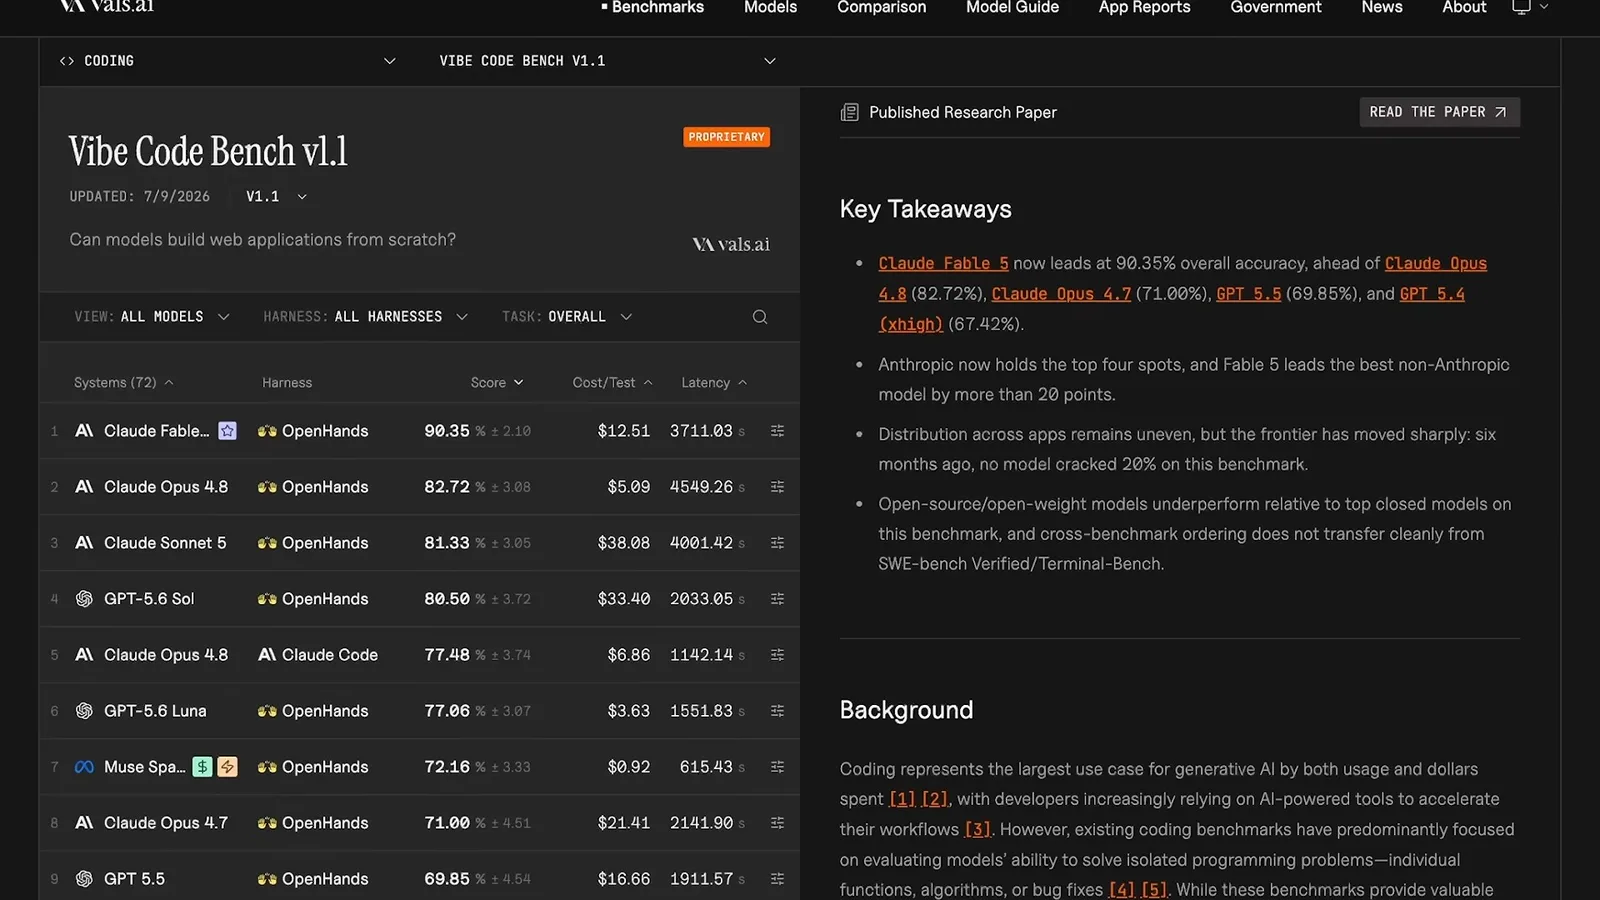
Meta 的 Muse Spark 1.1 提供了另一种权衡。图中的 Vibe Code Bench 成绩显示,Muse Spark 约为 72%,Sol 约为 81%,在展示的配置下前者成本约为后者的三十五分之一。做原型或游戏时,更便宜的模型可能足够;但仍需要更广泛的测试。
Meta 与 Humanity’s Last Exam 的共同创建者 Scale AI 有关联,我想这是否值得提出数据污染的问题。这只是疑问,并非发生污染的证据。GLM 5.2 等其他模型也说明,相当强的能力可以以低得多的成本获得。
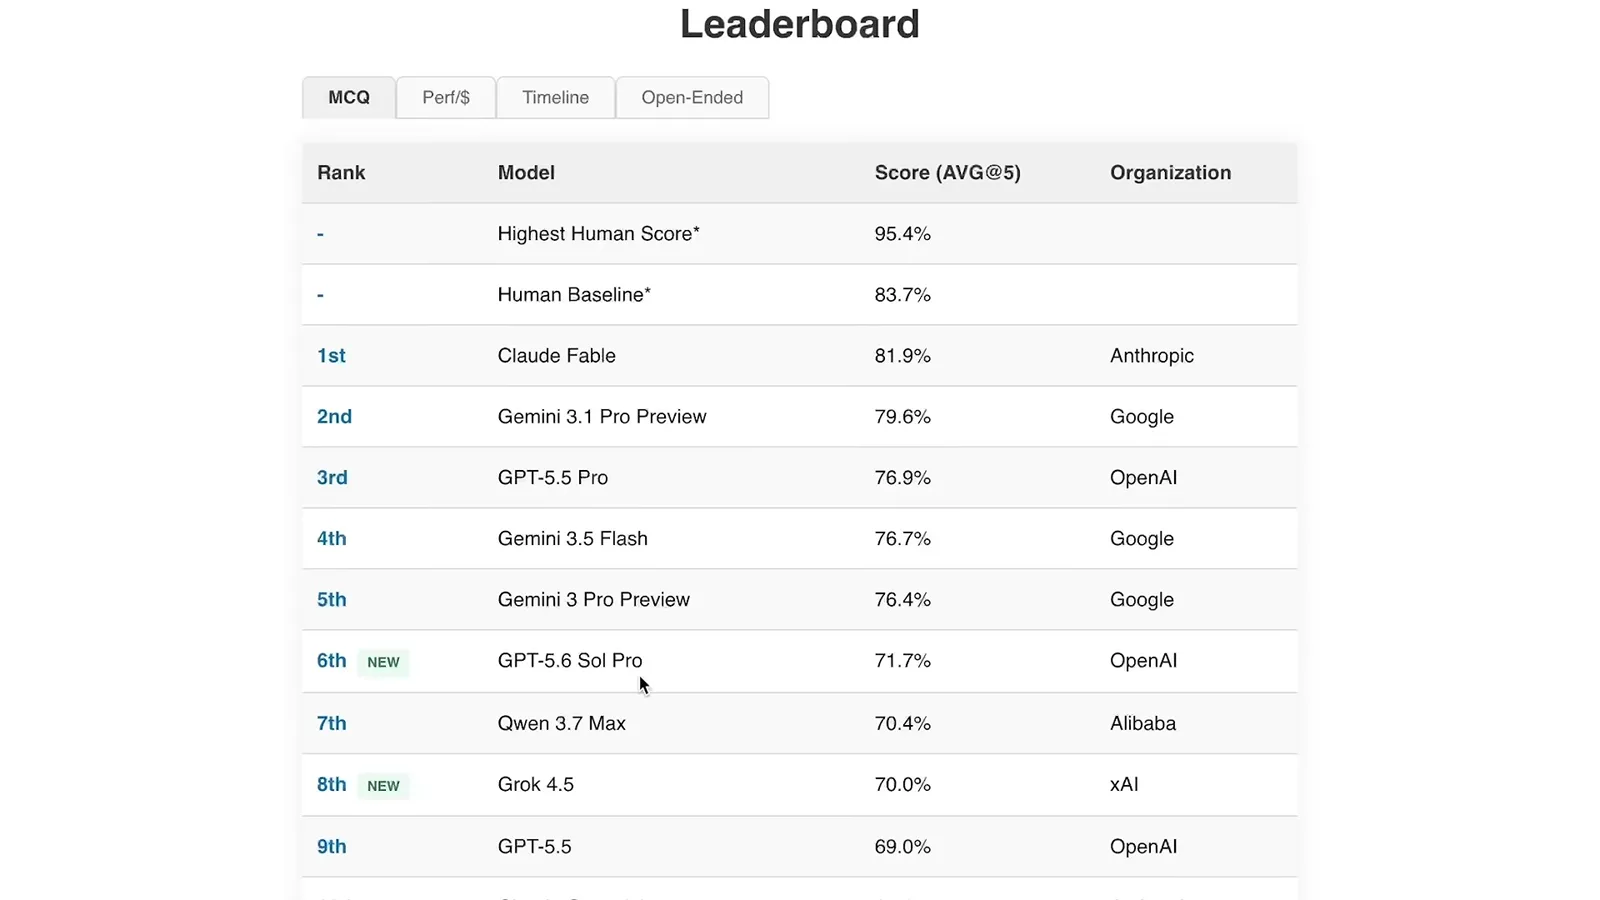
我自己的 Simple Bench 测试常识和脑筋急转弯问题。Sol Pro 得分为 71.7%,比 Fable 低约 10 个百分点;普通 Sol 约为 65%。更新后的结果还包括时间线和成本前沿;我认为 Qwen 3.7、GLM 5.2 和 DeepSeek V4 Flash 的性价比值得关注。
研究加速与安全
他质疑自我改进说法,并分析报告中的越狱发现。
OpenAI 的 ultra 模式使用更多并行智能体来加快工作,发布材料用漏洞利用生成评测展示了这一点。发布活动还称 Sol 对 Luna 进行了后训练。若不知道人类给出了多少指导和审查,也不知道与研究人员完成同一工作的结果相比如何,就很难评估这一说法。
内部更多地使用模型是可信的,但推理量或输出 token 增加,并不等于研究速度按相同比例提高。我猜测 OpenAI 的研究速度可能比一年前快 20%–30%,但人员规模等变量让这一估计也很不确定。OpenAI 还报告了内部评测的进展,外界无法详细独立解读。
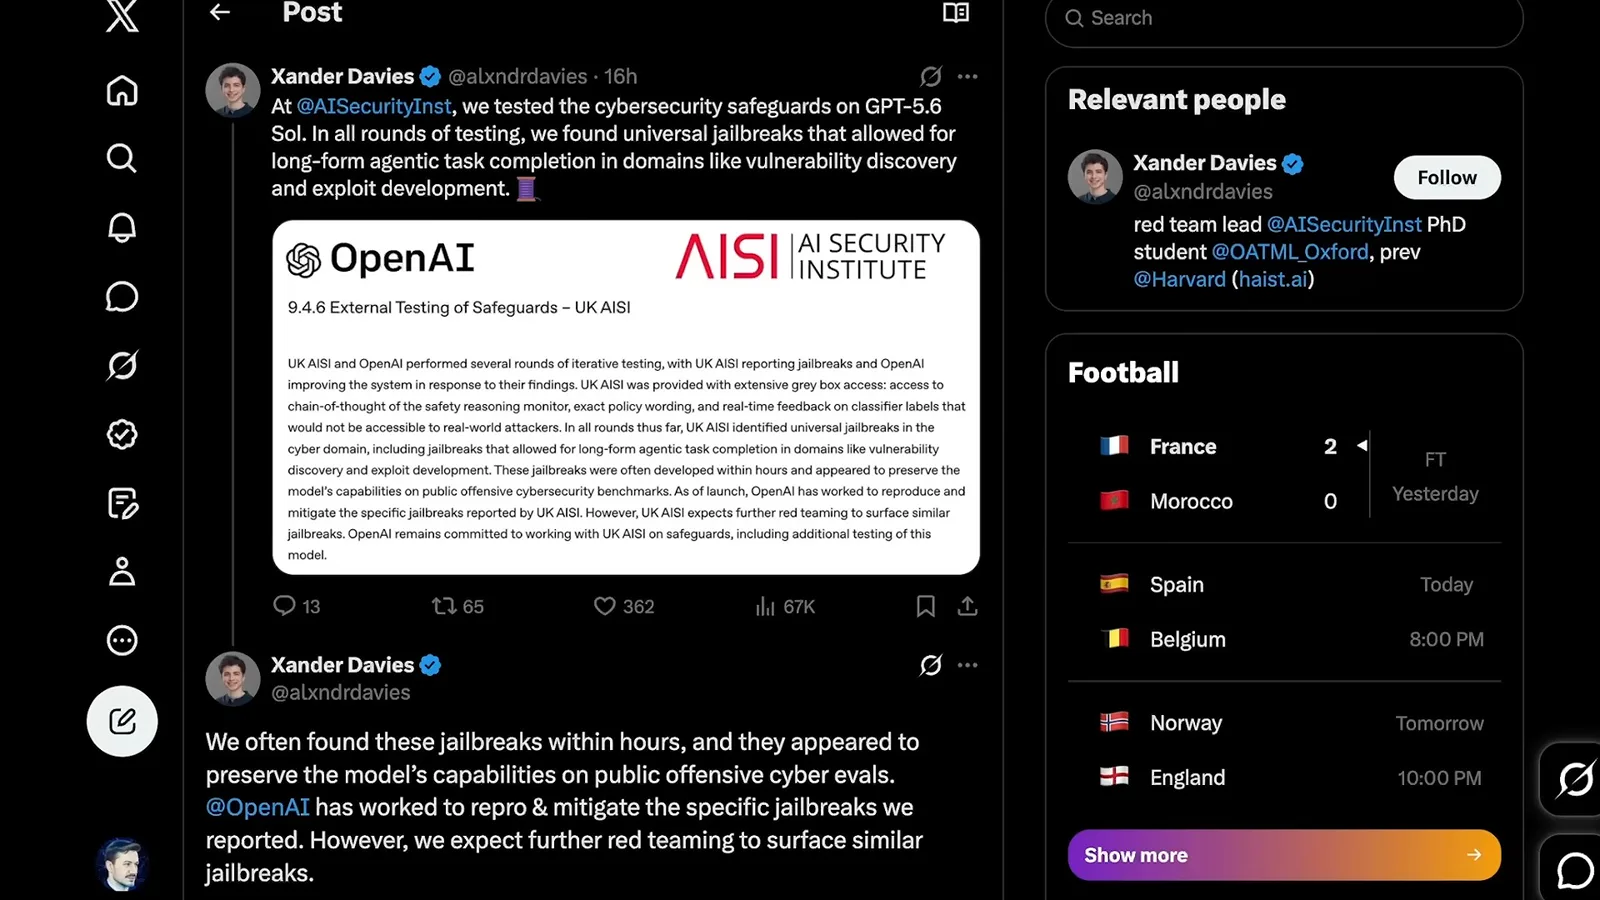
英国 AI 安全研究所报告称,测试人员在数小时内发现了通用越狱方法,可在保持模型能力的同时执行一系列有害的智能体任务。他们使用了灰盒权限,包括普通攻击者无法获得的信息和反馈。OpenAI 缓解了这些具体越狱方法,但测试人员预计进一步红队测试会发现类似方法。
一位 Anthropic 研究人员对越狱和奖励黑客表示担忧,并质疑 OpenAI 是否仓促发布;这是该研究人员的判断,并非已证实的结论。另一方面,我对 OpenAI 的实时语音智能体印象深刻:它能边说边听,让打断更自然。
语音与未来规模
他介绍实时语音,并认为未来算力可能支持更大的模型,同时承认有关数字仍不确定。
我认为模型进步远未结束。当前前沿模型的参数量并未公开,因此 Sol 约四万亿、Fable 约十万亿等数字都是猜测。算力也被用于服务用户、其他模态和更长的智能体任务,而不只是增大模型。
未来硬件或 token 需求趋稳,可能让更多算力用于更大的模型。一百万亿参数等数字只是说明可能的方向,并非已证实的产品计划;其他改进路径也依然存在。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。