30 秒看懂
在这场 2020 年的演讲中,独立研究员 Raph Levien 解释了 GPU 吞吐量、SIMD 分支分歧和内存层级,随后推导一种分块二维渲染方法。他最后回顾当时的 GPU API 和语言,并回答有关可移植性和硬件专用化的问题。
- 1通过并行获得吞吐量Levien 对比了面向单线程性能的 CPU 与强调吞吐量和延迟隐藏的 GPU。
- 2分支分歧当通道选择不同分支时,GPU 会用掩码执行两条路径,使部分通道空闲。
- 3内存层级寄存器、线程组共享内存和全局内存在容量、带宽与延迟之间各有取舍。
- 4按块渲染第一遍按图块筛选对象,第二遍渲染像素,从而减少重复读取对象。
- 5通道协作一种拟议的掩码转置方法重新组织对象与图块的相交关系,以便并行输出;当时它仍处于设计阶段。
- 6部署仍然困难Levien 从 2020 年的视角介绍 CUDA、图形 API、SPIR-V、WebGPU 和新兴语言。
要点建议
- GPU 吞吐量取决于充足的并行工作、高效的内存访问,以及保持 SIMD 通道活跃。
- 将计算按输入缓冲区、调度和输出缓冲区做函数式分解,可以明确数据依赖。
- 简单的逐像素渲染器并行度高,却会反复读取每个对象;分块可以减少冗余工作。
- 通道协作和转置相交掩码能减少空转迭代,但所提出的优化当时尚未实现。
- GPU API、硬件子组宽度和着色器工具链都会带来可移植性与调优方面的权衡。
- 演讲对 WebGPU 和着色器标准的讨论反映了它们在 2020 年的状态和提案。
按章节阅读整理后的全文
为什么使用 GPU 计算?
Levien 介绍吞吐量、并行性及影响性能的硬件差异。他以自己的二维渲染器作为出发点。
GPU 计算是一门深入且技术性很强的课题,因此这只是一次浅尝,而不是完整指南。我会解释硬件、提出一种组织 GPU 程序的函数式方法,并以自己开发高性能二维渲染器的工作为例。
最后一部分涉及部署:写好 GPU 程序之后,要让它在不同硬件上运行仍然困难。本次演讲反映了 2020 年前后的硬件及不断演进的 API。
随着 Dennard 缩放放缓,提高单核速度不再能像过去那样增加吞吐量。并行性因此越来越重要。GPU 提供的并行能力远高于 CPU,但实际收益取决于工作负载。
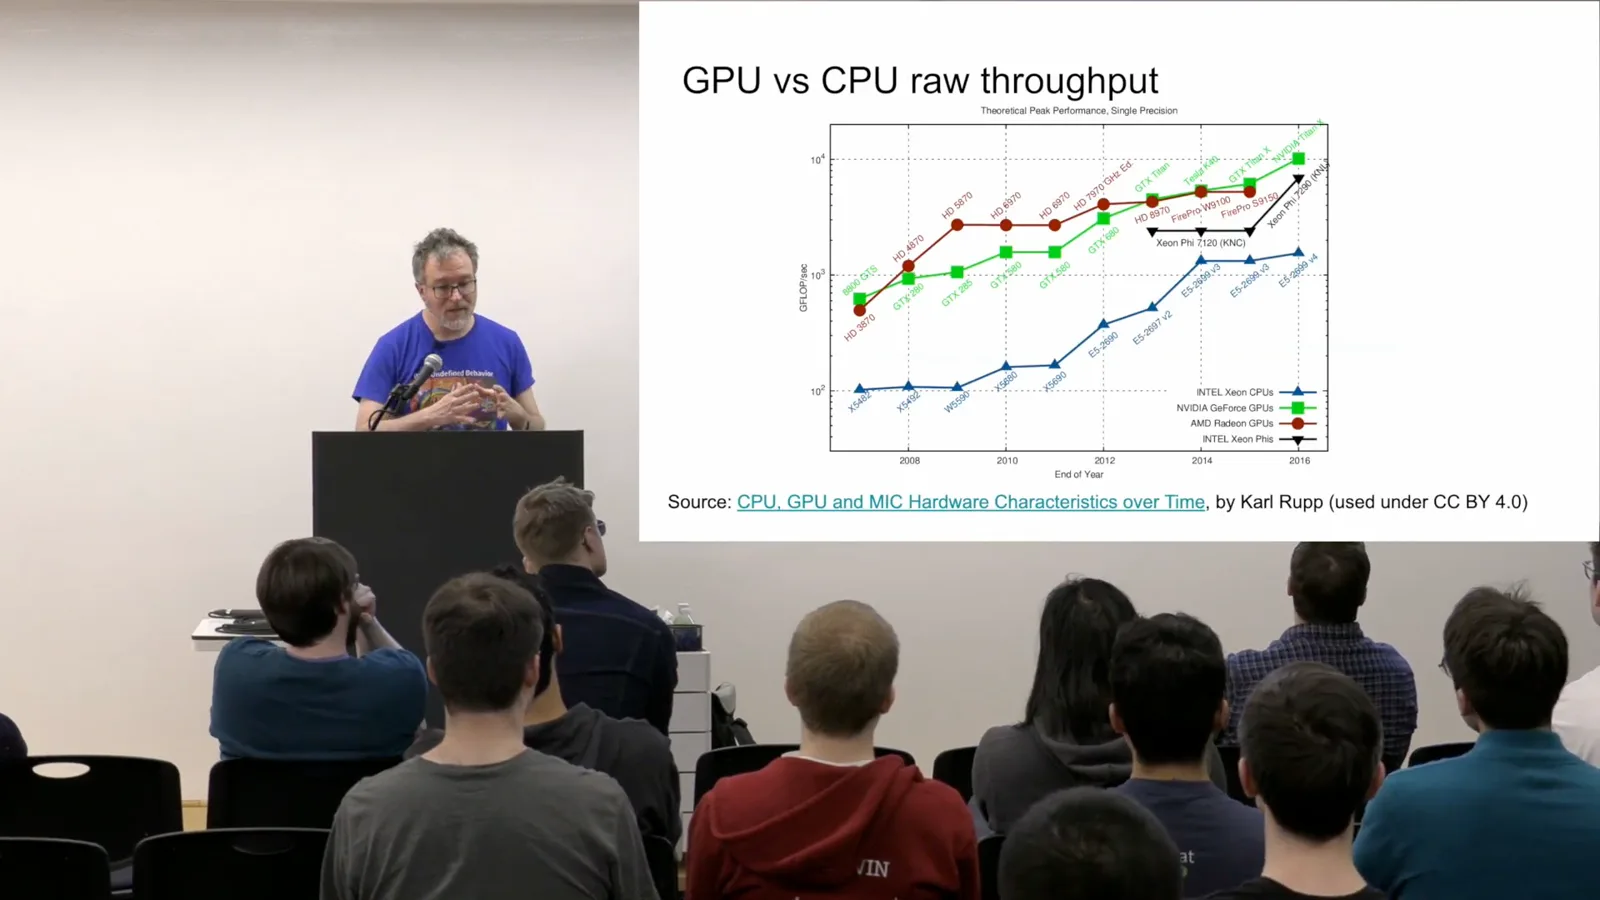
一张理论浮点吞吐量的历史图表显示,高端 GPU 大约比 CPU 高一个数量级。Levien 还估计,在他讨论的例子中,每美元和每瓦的吞吐量优势也大致处于同一数量级,这推动了机器学习等工作负载的发展。
芯片照片显示,大量面积可以分配给 GPU 及其共享内存设施。但 GPU 设计差异很大;这次硬件介绍经过有意简化,重点放在桌面级设备,而非移动 GPU。
执行、分歧与内存
简化的 Intel 执行单元展示了调度、SIMD 通道和分支分歧。内存层级决定哪些计算和数据移动代价高昂。
在图示的 Intel 执行单元中,多个执行线程各有程序计数器和寄存器文件。每个线程有多个通道。仲裁器选择已就绪的工作,将其分配给算术、分支和加载/存储单元。
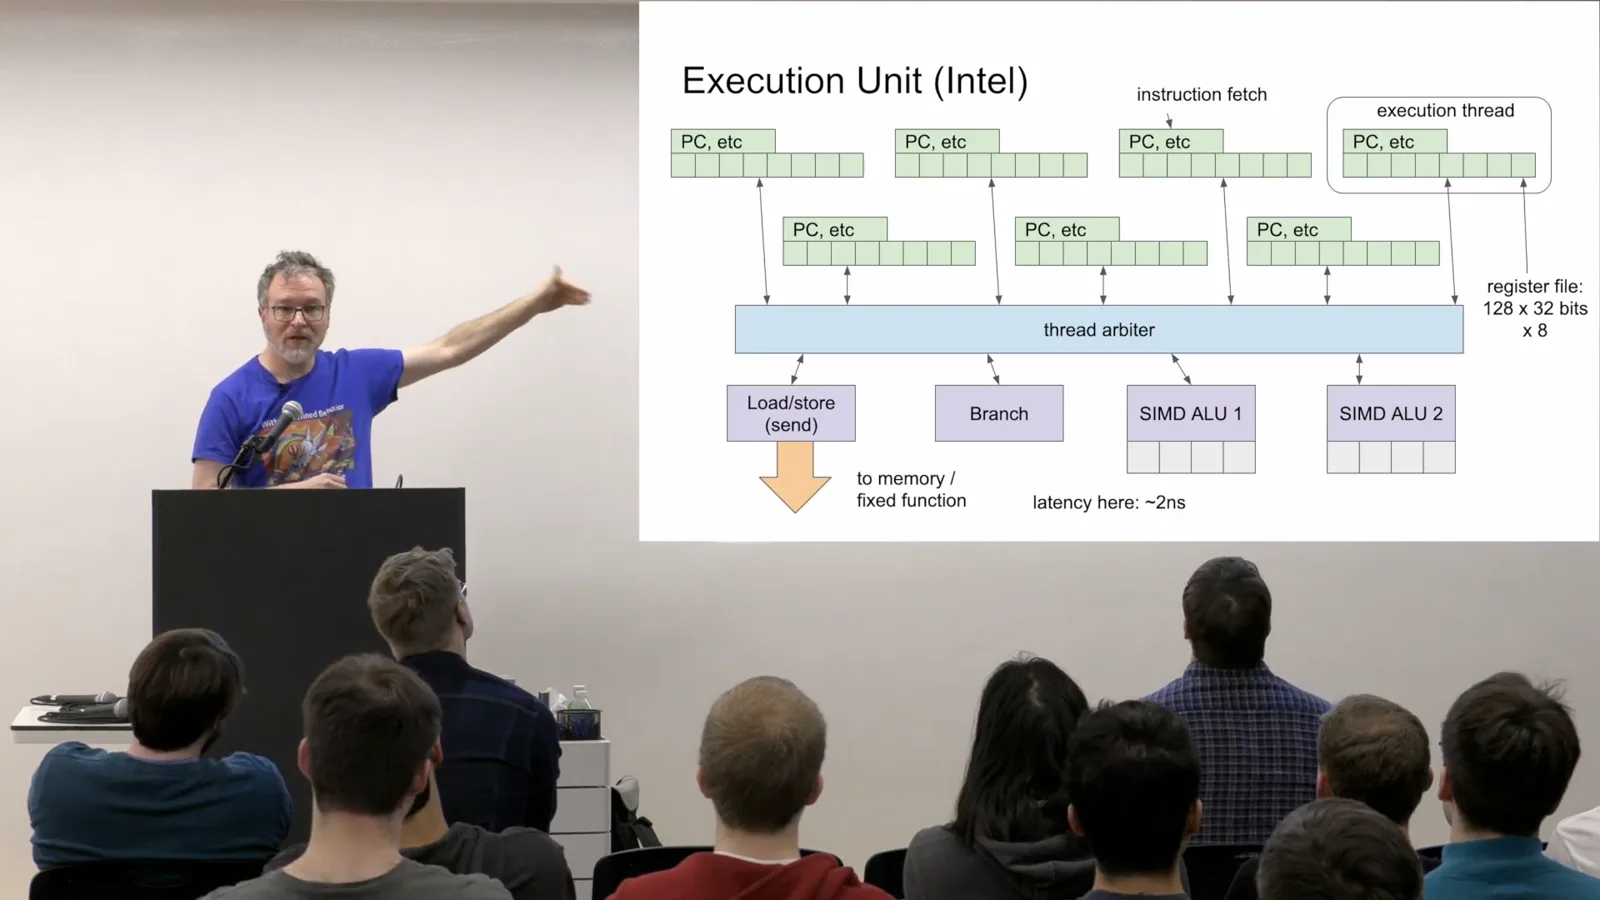
CPU 通过流水线、寄存器重命名和超标量执行,大量投入于提高单线程性能。GPU 则强调吞吐量:一个执行线程等待内存时,其他线程可以使用算术单元,从而隐藏延迟。
加载操作向内存发送请求,线程等待响应;仲裁器让其他就绪线程继续运行。Levien 给出图示执行单元内部操作约两纳秒的延迟,同时强调这些只是近似数值。
一个执行线程处理 SIMD 向量,宽度取决于硬件。着色器源代码通常看起来像是为单个线程编写,尽管硬件同时执行多个通道;“线程”这个词在不同层级有不同含义。
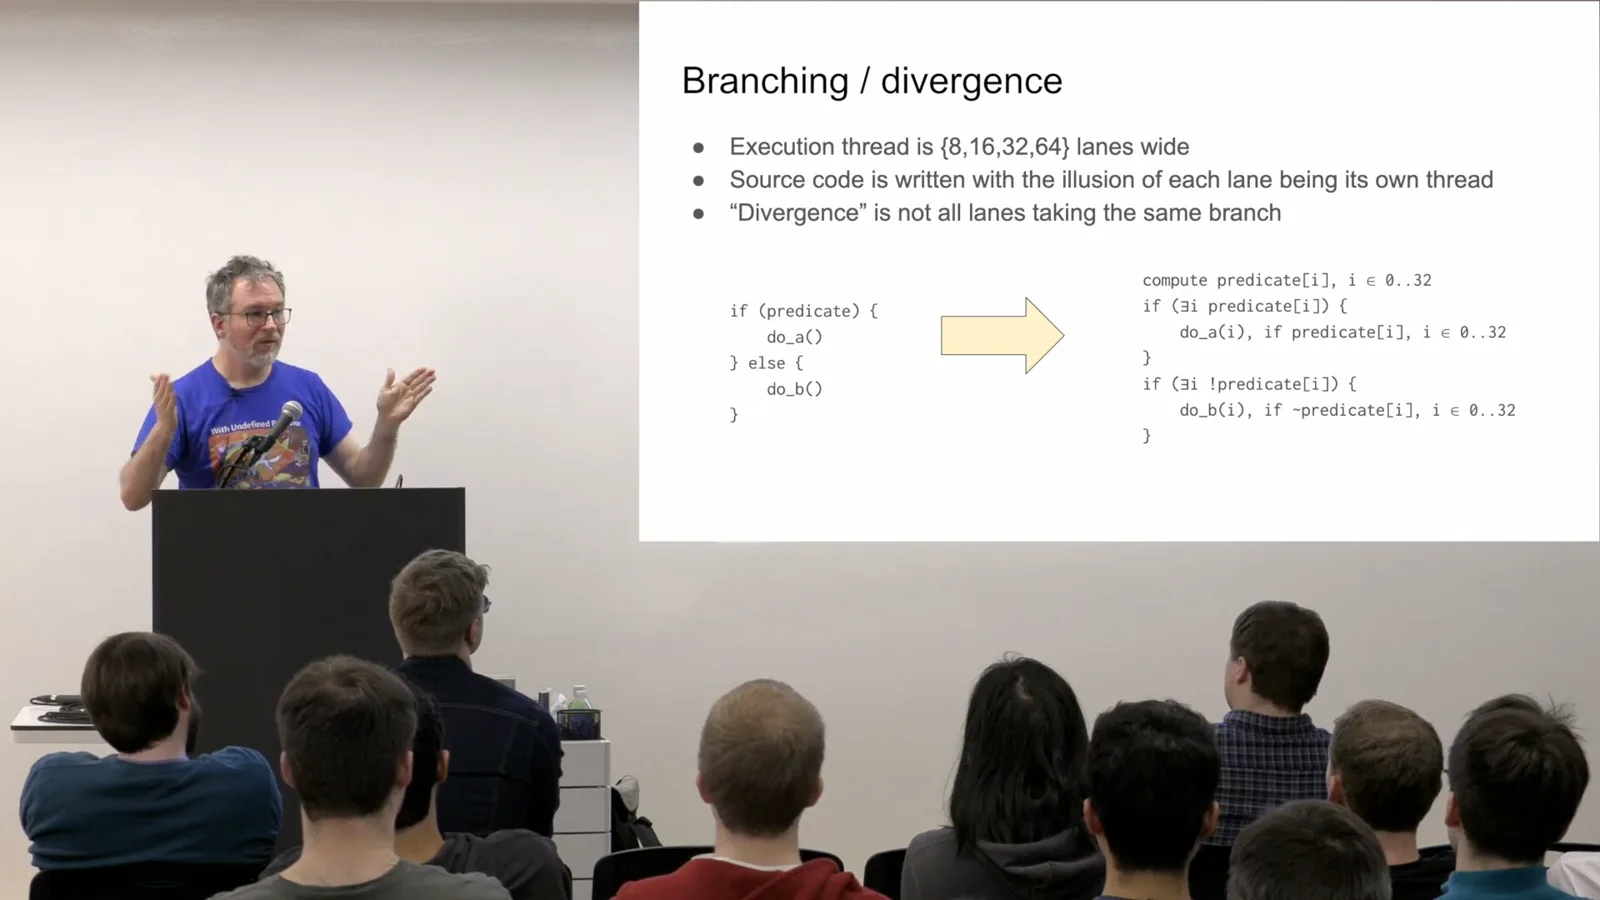
如果所有通道选择同一分支,执行过程很直接。如果一些通道选择一个分支,另一些选择另一个分支,硬件就会用掩码执行两条路径。这种分歧使不活跃的通道空闲,相对于有效工作增加了执行量。
执行单元会组成更大的结构,共享指令缓存和内存访问等资源。纹理采样器可以提供快速查找和硬件插值;具体组织和延迟因设备而异。
沿层级向外移动,会到达更大的共享结构和主内存。访问更远的资源需要更高延迟。以不同规模增加执行资源,可以制造功耗和吞吐量特征不同的设备。
计算工作以由线程组组成的一维、二维或三维网格形式调度。程序员必须把问题映射到网格,并选择能为硬件提供足够并行工作的组大小。
函数式结构与二维渲染
Levien 将调度建模为缓冲区上的函数。他对比了简单的并行渲染与顺序包围盒方法及其权衡。
虽然着色器代码看起来是命令式的,我发现用函数式方式思考很有帮助。线程组读取输入缓冲区,通过组内本地内存计算和通信,再写入输出缓冲区。每个输出都是输入的函数,各次调度构成依赖图。
机器学习工作负载天然容易映射为操作图和工作网格,这有助于解释 GPU 为什么适合它们。对于其他领域,问题在于我们能否找到同样有效的调度与线程分解方式。
性能受到内存层级的强烈制约。靠近算术单元的寄存器带宽高、延迟低,但容量很小。全局内存提供大得多的存储空间,延迟更高,相对带宽更低。
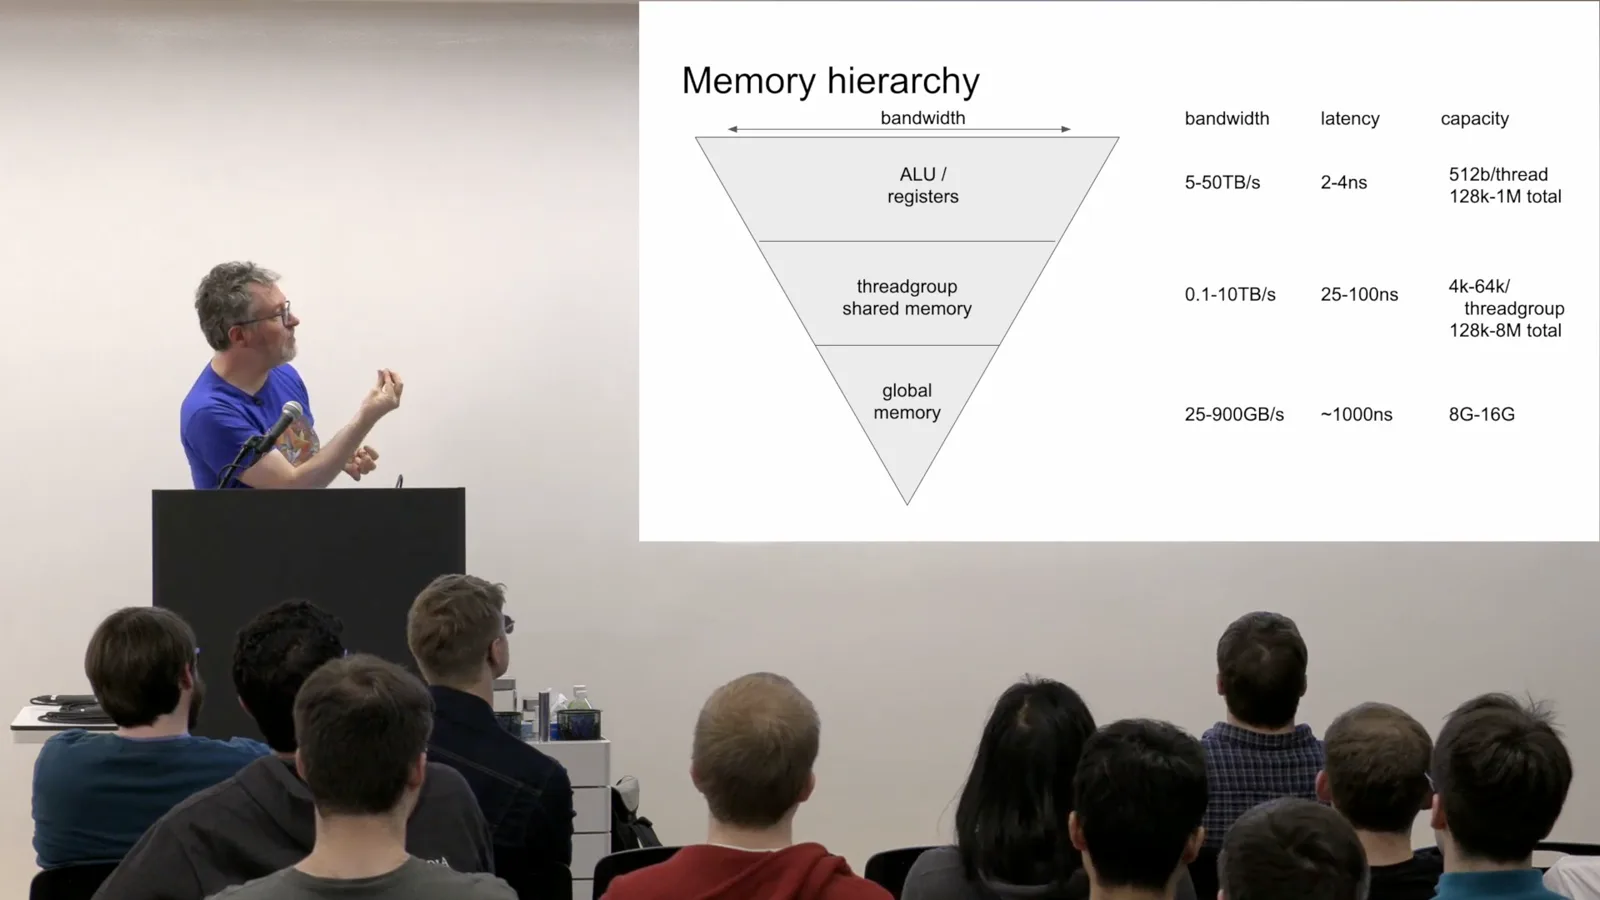
线程组共享内存位于两者之间,需要有意识地使用。在幻灯片的例子中,每组容量仅为几十千字节。合理组织工作以复用附近的数据,可以减少代价高昂的全局传输。
我的研究动力是二维渲染。Skia 和 Direct2D 等现有渲染器通常将场景映射为图形图元,并使用固定功能流水线。它们在包括旧硬件在内的设备上都能工作,但复杂混合和中间缓冲区会消耗带宽。
计算式渲染器可以改为在计算过程中完成中间混合,最后只写一次像素。这并非没有代价:GPU 必须遍历 CPU 上传的场景数据结构。我的原型 piet-metal 正在探索这种权衡。
在简化模型中,场景是一个对象列表,每个对象都能在指定坐标渲染一种颜色。使用满足结合律的 Porter-Duff over 运算符合成颜色。函数式程序遍历像素,并折叠每个像素上的对象颜色。
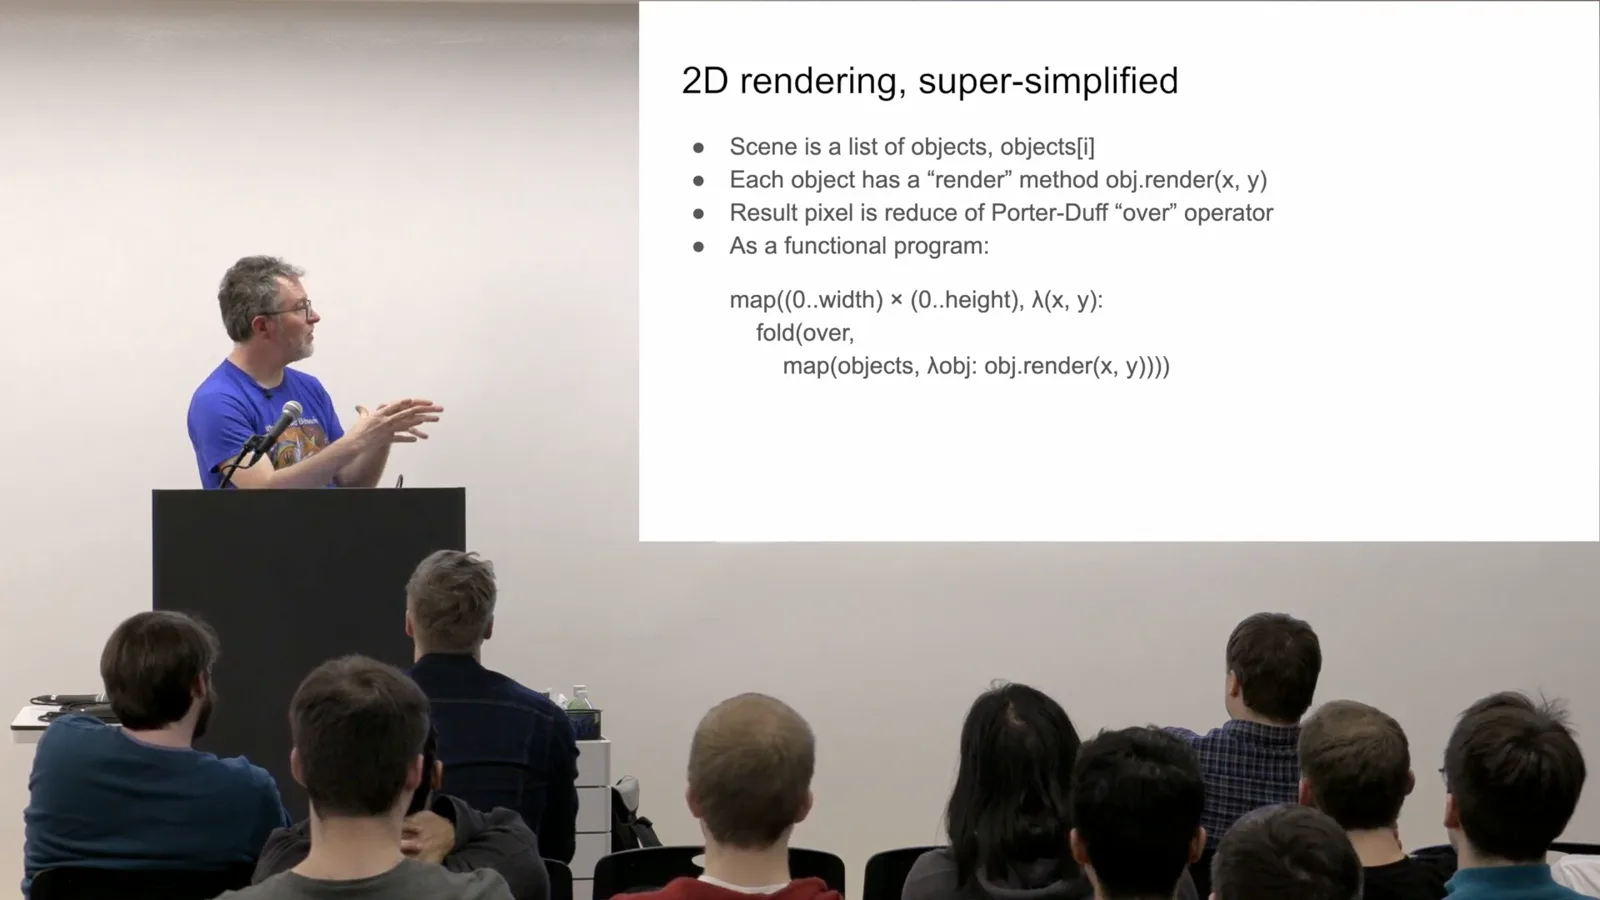
这种朴素形式具有极好的并行性:像素相互独立,满足结合律的折叠还能进一步并行。它也只写一次最终像素。但每个像素都必须读取场景中的每个对象,而大多数对象对它没有贡献。
包围盒表明大多数对象只影响图像的一小部分。顺序的 CPU 风格程序只访问每个对象一次,再只渲染其包围盒内的像素。这减少了对象读取和不必要的工作,但这种简单形式的并行性很差。
它的写入流量也取决于场景。如果大量对象重叠或混合,渲染器就会反复读写内存中的同一批像素。简单地给朴素并行版本添加逐像素包围盒筛选,并不能解决重复读取的问题。
分块与协作筛选
两遍分块流水线改善了读取和计算的权衡。拟议的 SIMD 掩码转置算法进一步减少空转,但仍有待实现。
另一种办法是将图像分块,使用两个阶段。一个 16×16 的图块有 256 个像素,因此每个图块筛选一次,而不是每个像素筛选一次,可以大幅减少对象读取。根据硬件调整图块大小,第二阶段再渲染像素。
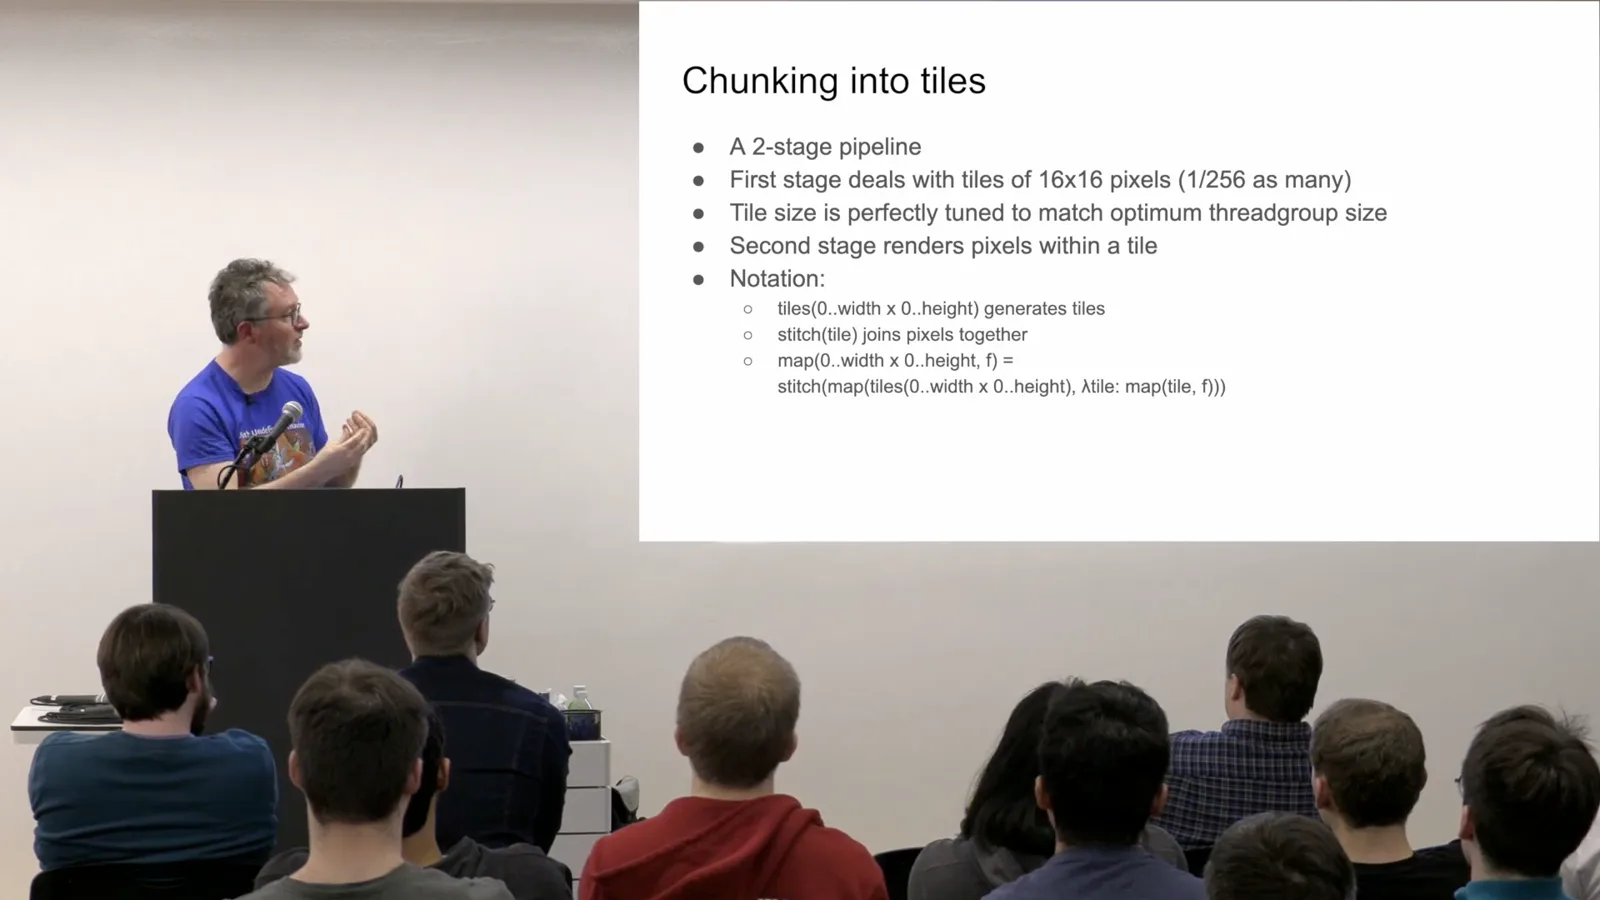
函数式表达遍历图块,筛选包围盒与各图块相交的对象,用这些对象渲染像素,再把图块拼成图像。并行性和最终写入方式仍然良好,而读取工作量大约按图块面积成比例减少。
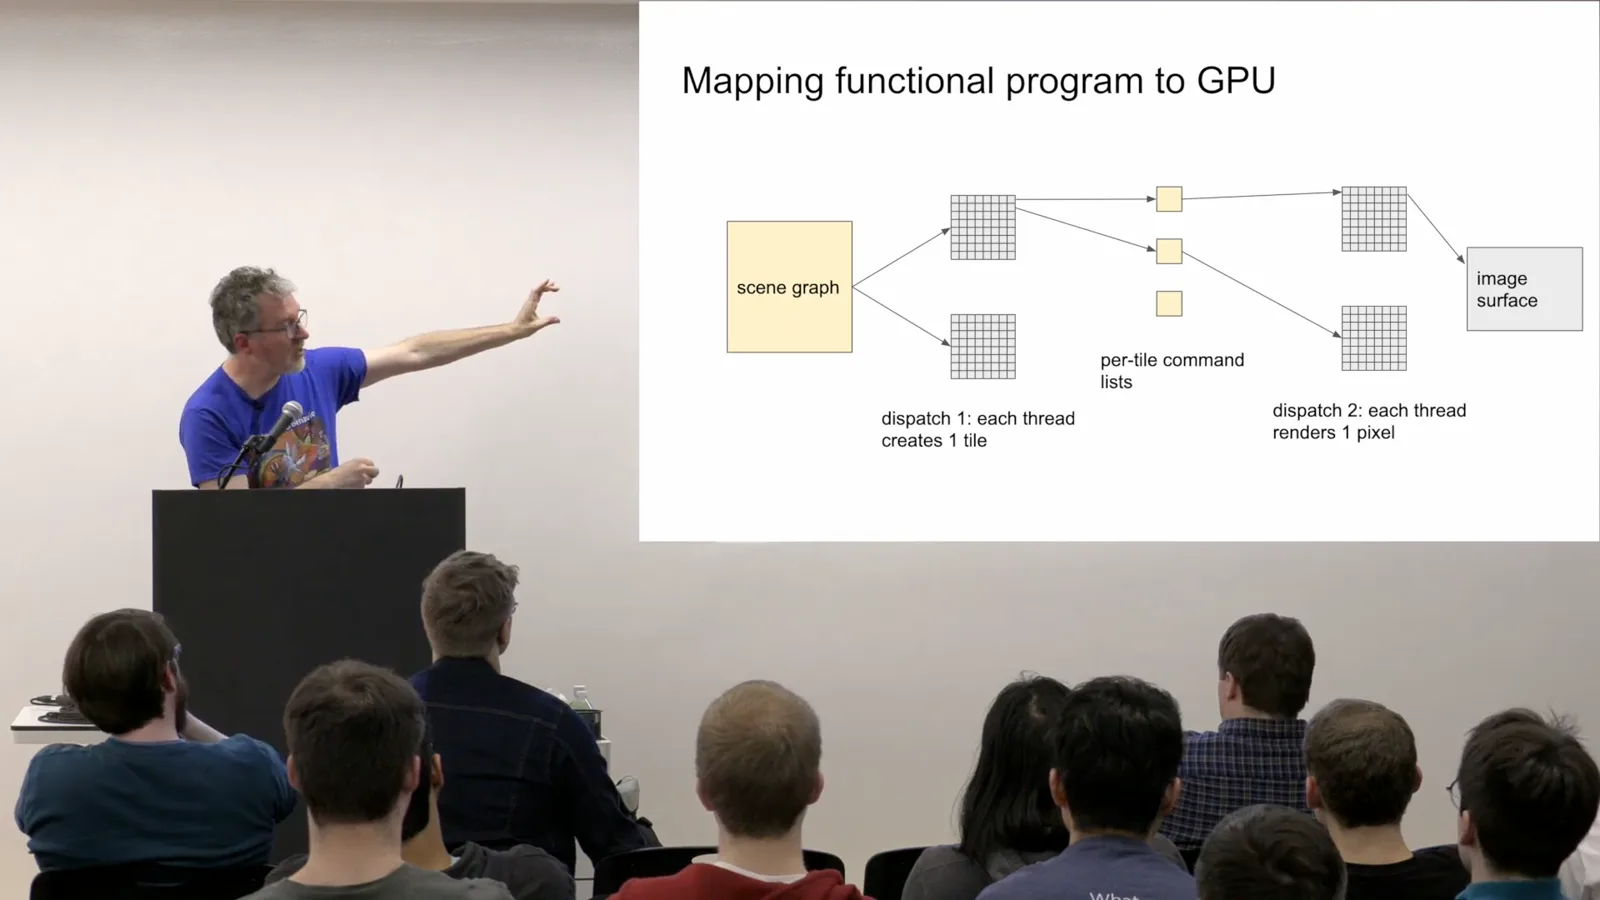
在 GPU 上,这变成两次调度。第一次为每个图块建立命令列表;第二次读取列表并渲染像素。Levien 将其比作把场景程序特化成每个图块的字节码,然后加以解释执行。
工作利用率仍有改进空间。考虑由 32 个对象和 32 个图块组成的块。一种直接的方法是让每个通道逐个测试对象与自己负责的图块,并将相交对象写入输出列表。
在 SIMD 通道中,每轮都读取同一个对象,并将它与多个图块比较。这种统一读取可能很高效,但大多数对象与大多数图块并不相交。掩码写入和重复迭代会让许多通道几乎没有做有效工作。
更强调协作的设计让各通道并行读取不同的包围盒,并计算相交位掩码。转置操作在通道间交换信息:以对象为索引、记录图块的掩码,变成以图块为索引、记录对象的掩码。
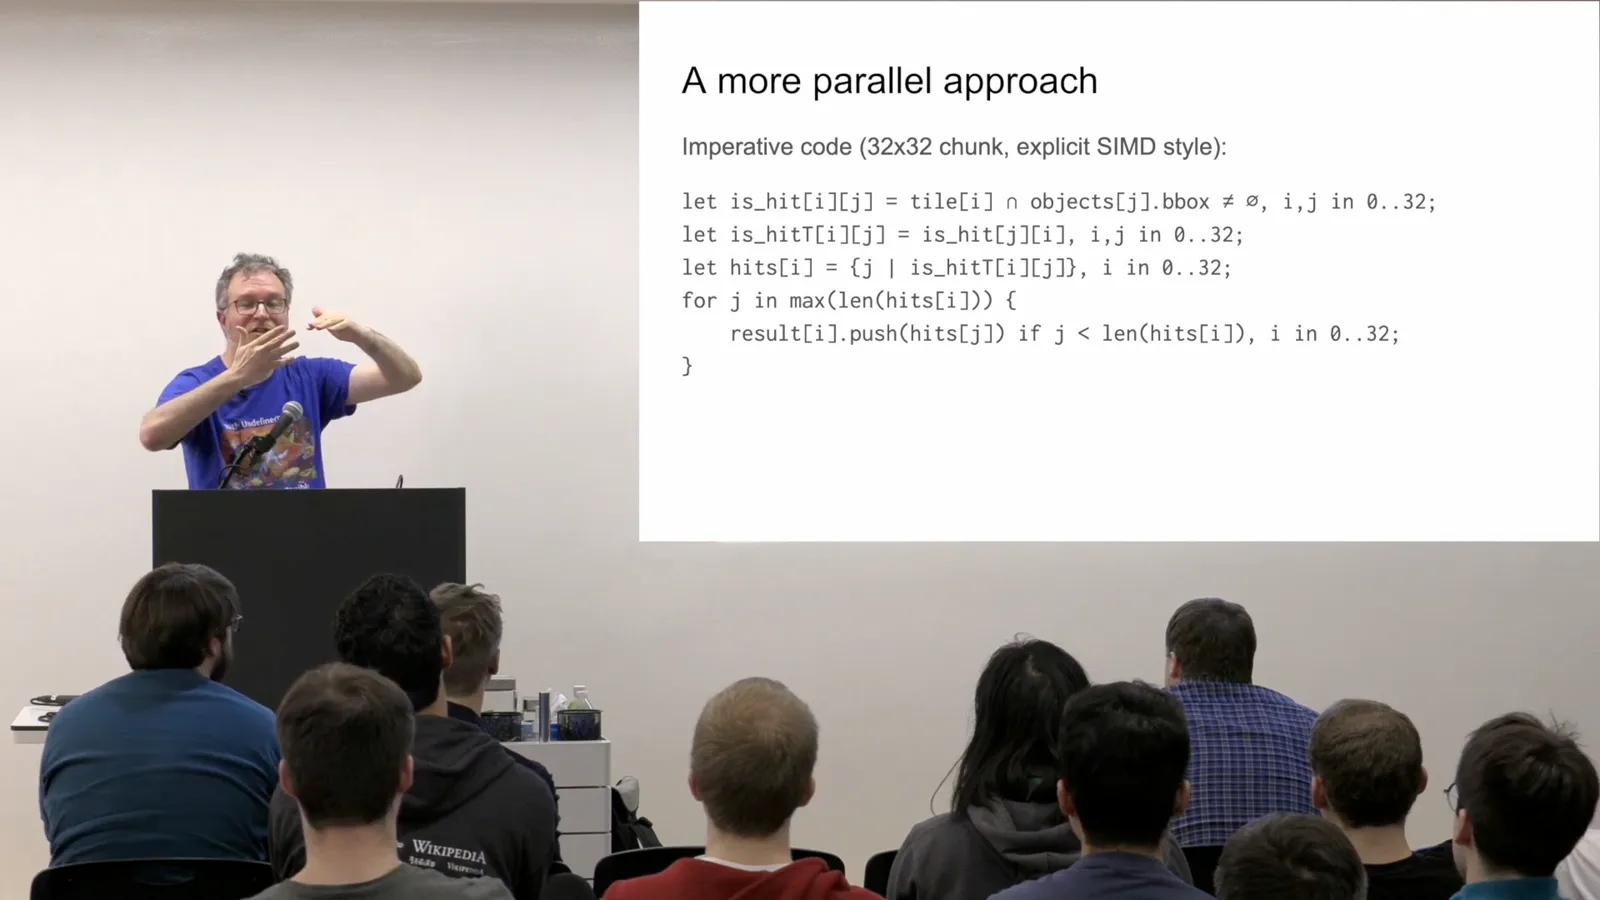
随后每个图块可以并行输出命中对象,只需迭代到当前块中最大的命中数量。如果完全没有相交,线程组就能直接跳到下一块。位操作和子组 shuffle 操作提供所需的协作。
演讲时,这项优化仍是一种设计,而非已经实现并测量的结果。我预计它能提高性能,但必须先编写着色器代码并在真实硬件上测试,才能确定这一预期。
2020 年的 API、语言与部署
演讲者介绍 CUDA、图形 API、SPIR-V、Vulkan 和早期 WebGPU 提案。他概述了希望能降低 GPU 计算部署难度的语言和工具。
部署仍是另一个挑战。CUDA 是较早实用的 GPU 计算平台;Levien 认为 OpenCL 在当时逐渐失去动力,并指出 DirectX 12 和 Metal 等图形 API 对计算的支持正在增加。
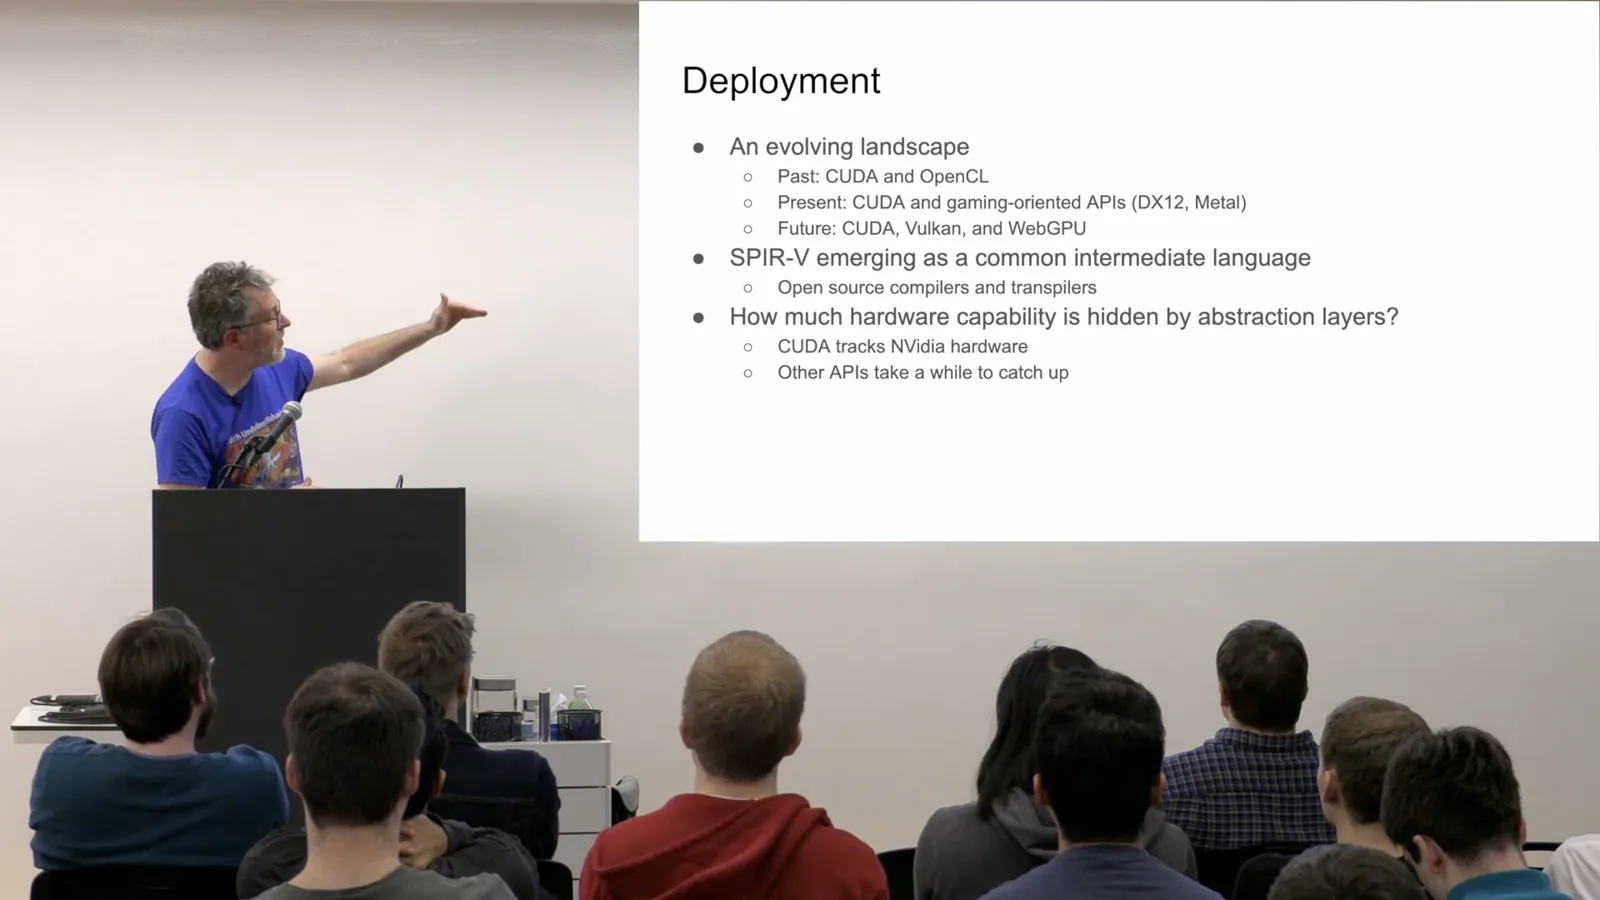
他预计 Vulkan 和 WebGPU 将与 CUDA 一起发展,并强调 SPIR-V 作为中间表示的作用。共同的中间层可以将源语言工具与硬件驱动分开,但抽象层未必能立即暴露所有新硬件功能。
着色器生态过去使用特定平台的语言和中间形式,例如 Metal 着色语言和 HLSL。SPIRV-Cross 可以将中间表示转回适用于其他目标的源码。Levien 讨论了当时新提出的 WGSL 和 Tint,作为不断演进的 WebGPU 设计的一部分。
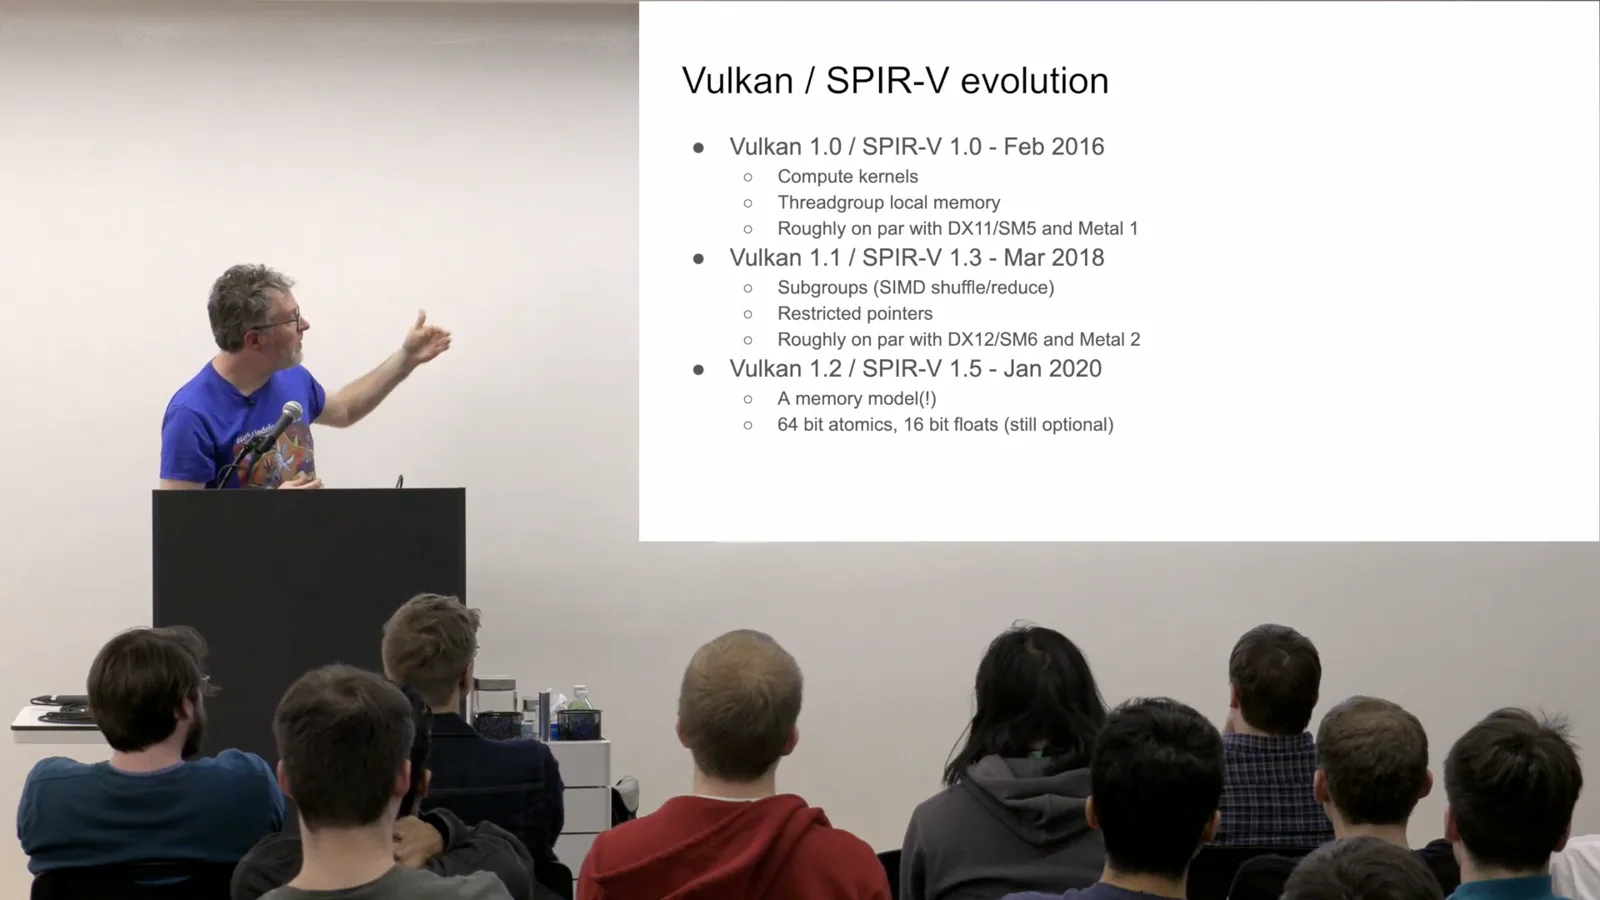
Vulkan 1.0 提供计算内核和组内本地内存;Vulkan 1.1 增加了子组 shuffle、归约操作和受限指针。Levien 强调 Vulkan 1.2 的形式化内存模型,以及 64 位原子操作和可选的 16 位浮点数等功能。
在 2020 年这场演讲中,WebGPU 仍处于提案和原型阶段。演讲者描述了二进制与文本着色器之间的争论,以及让 WGSL 语义与 SPIR-V 一致的提案。这些说法反映了当时的设计讨论。
当缓冲区跨越信任边界时,安全要求可能带来清零内存或额外同步等成本。Levien 还提到 wgpu、Dawn 等原生库和 Tint 编译器,它们可能让类似接口在浏览器之外使用。
更高层的 GPU 语言提供了不同方法。Halide 面向图像处理;Futhark 探索用于 GPU 的 ML 家族函数式语言;Co-dfns 借鉴 APL 和数组编程;Julia 提供交互式工作流,当时通常使用 CUDA。
Levien 还讨论了 MLIR,以及将机器学习计算逐步降低到 SPIR-V 和 Vulkan 的可能性。他希望更扎实的中间表示、内存模型和共享测试,能够减少部署计算工作负载的阻力。
他预测,更好的工具和语言可以让 GPU 吞吐量用于游戏、机器学习和挖矿之外的更多场景。他希望程序员能更顺畅地表达自己有意设计的硬件映射,而不是依赖一个神奇地产生最优结果的编译器。
有关调优与融合的提问
观众询问排序、取决于硬件的子组宽度,以及图形与机器学习硬件的关系。Levien 强调权衡与测试设计的必要性。
一位观众问,排序对象是否能增加包围盒测试后可跳过的块数。Levien 说这可能有效,但必须权衡收益与排序成本。重新排列不相交的对象以及使用其他空间结构,也是值得探索的方向。
另一位观众询问如何在不同硬件上选择最优线程组大小。Levien 区分了由程序员控制的线程组与取决于硬件和编译器的子组。当时,对子组宽度的控制尚未得到普遍支持。
他说,实际工作中团队可能对多个内核版本进行基准测试,并利用硬件查询和启发式方法进行选择。他没有声称存在通用的自动化解决方案;实现可移植的高性能仍是困难的工程问题。
最后,谈到图形与机器学习硬件是否会融合时,Levien 预计会出现更多面向机器学习的低精度专用张量硬件,而这些硬件未必同样有益于其他领域。不过,更好的工具和部署接口可以同时帮助图形与机器学习工作负载。
同频道的其他文章
 15:33EN → 简体中文
 Jane Street· 2026年10月26日Figgie 策略:解读手牌、争夺多数与定价Bradley, Mike · Jane StreetJane Street 交易员 Bradley 和 Mike 分析三局游戏,展示私人信息、市场竞争和时机如何影响牌价。
 1:48:29EN → 简体中文Jane Street· 2026年10月16日AI 如何改变编程:John Crepezzi 与 Ron Minsky 的对话Yaron Minsky, John Crepezzi · Jane StreetJane Street 的 AI 工具负责人和 Signals and Threads 主持人探讨智能体基础设施、安全、代码审查,以及软件开发体验的变化。
 1:36:37EN → 简体中文Jane Street· 2026年9月23日Aaron Bauer:在 AI 时代教授软件工程Yaron Minsky, Aaron Bauer · Jane Street当模型能够生成代码时,学习目标、主动练习和编辑器设计如何影响工程教育。
 1:05:45EN → 简体中文Jane Street· 2026年9月11日Cyrus Omar:实时编程与人与 AI 共享的计算公共空间Cyrus Omar通过 Hazel 演示,探讨即时反馈、结构化协作和精细权限如何帮助人类与 AI 智能体共同工作。
 1:25:00EN → 简体中文Jane Street· 2026年9月2日Eric Mannes:如何将杂乱的外部数据用于交易研究Yaron Minsky, Eric Mannes · Jane Street从商品期货和 Excel 风险系统,到时点数据集和 AI,Eric Mannes 解释 Jane Street 数据工程背后的领域知识。
 1:16:29EN → 简体中文Jane Street· 2026年8月26日Grant Sanderson 与 Alok Puranik:从群论看位置编码Grant Sanderson, Alok Puranik · 3Blue1Brown从注意力机制的假设出发,他们推导矩阵指数,并将旋转、衰减和 Jordan 块与 RoPE、ALiBi 联系起来。