30 秒看懂
修改提示词或训练模型之前,先建立能衡量智能体所需行为的评估。Stanford 的 Michael Ryan 展示了提示词优化器如何保留成功示例、利用失败反馈修改指令,而不改变模型权重。权重训练则可以把大量轨迹转化为较小模型的能力;强化学习则奖励学生自己的尝试。选择取决于访问方式、运行成本和任务变化频率,两种方法也可以结合使用。
- 1评估决定优化可以改善什么Ryan 说,系统、任务数据和指标缺一不可。邮件提取工具的测试可以表达简短提示词遗漏的日期格式等要求。
- 2不改变权重也能把成功轨迹变成示例DSPy 式自举搜索保留好的输出,尝试不同的上下文组合,并根据评估选择。
- 3MIPROv2 同时搜索指令和示例该方法利用程序与训练数据摘要提出指令,再通过搜索比较候选组合。
- 4GEPA 保留优势互补的提示词优化器通过反思轨迹变异提示词,还可以合并不同候选中有用的部分。
- 5GRPO 比较多次尝试,无需训练价值模型同一任务的一组解答提供相对奖励基线,从而减少部分 PPO 所需的机制。
- 6同策略蒸馏针对学生自己的动作提供指导学生生成轨迹,教师为学生实际到达的状态提供逐 token 概率信息。
- 7实际选择取决于成本、访问方式和数据Ryan 建议仅能通过 API 访问的模型或运行成本高的任务采用上下文优化;需要更便宜的学生模型或更短上下文时可以考虑权重优化。
要点建议
- 从有代表性的数据和可衡量的评估开始;优化会追逐指标奖励的东西。
- 强模型只能通过 API 访问或任务经常变化时,可以尝试上下文优化。
- 当更便宜的学生模型、更短的上下文或大量训练示例足以抵消额外工作时,考虑权重训练。
- GEPA 保留能解决不同示例的提示词,并利用观察到的失败提出修改。
- 同策略蒸馏用教师评价学生自己的轨迹,而不只是复制教师生成的示例。
按章节阅读整理后的全文
为什么优化从评估开始
示例与可衡量目标让团队把通用模型适配到实际任务。
准备这堂课时,我让 Codex 把之前演讲的幻灯片转换成课程格式。它逆向分析了 Keynote 的文件结构,写出转换代码,让我印象很深。
考虑三个让 PaLM 2-L 解决数学题的提示词。在实验中,“深呼吸,然后一步步解决这个问题”的表现胜过其他选项。重点不是这句话总是最好,而是如果不针对模型和任务进行测试,你很难可靠地知道答案。
优化让我们通过数据和评估来表达意图,而不是手写每一项要求。我们需要三样东西:一个系统、示例或反馈,以及一个能判断修改是否有帮助的指标。
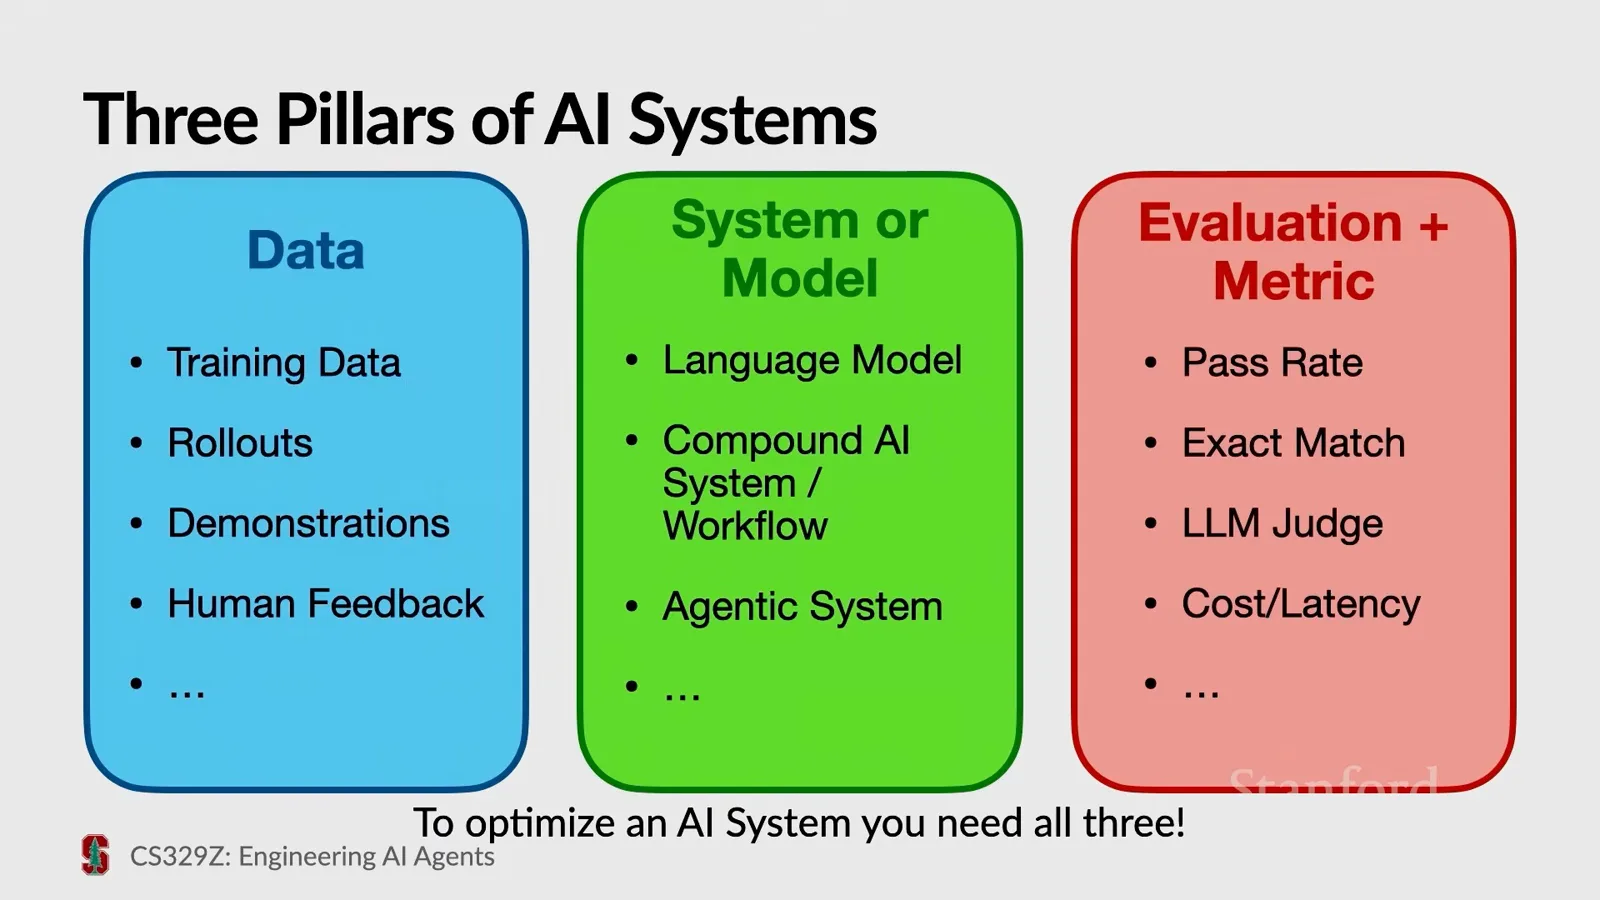
模型能力增强后,是否就不需要调整提示词了?细微的措辞技巧可能没那么重要,但上下文优化仍有助于完成最后一公里:通用模型必须适应产品真正需要完成的具体任务。
评估可以表达指令中遗漏的细节。例如,从邮件中提取日程的工具可能需要可解析的 ISO 日期格式,还需要处理多个事件的规则,即使书面提示词只说了提取日期和时间。
优化可以针对可靠性、领域表现、成本或延迟。底层模型变化时,它也能帮助团队适应:保留评估,再搜索适用于新模型的配置。
搜索有用的示例
少样本方法测试示例选择,并可自举生成成功轨迹。
少样本提示会把几个示例与任务描述放在一起,比如英语短语及其法语译文。模型从上下文中学习,无需改变权重。
一篇早期论文发现,示例的排列顺序会影响模型表现。作者尝试不同排列,衡量模型在探测集上的预测分布,而不使用探测集的真实标签来选择顺序。
论文中的全局熵衡量预测标签在整个数据集上的变化:总是输出同一类别的模型熵较低。局部熵则涉及模型对某个具体示例的各标签概率分配有多均匀。结果中,全局指标通常能选出表现更强的顺序。
主要思路是搜索:尝试不同示例或排列,观察表现如何变化。论文发现,与随机排列相比,这种方法有所提升,但具体最佳提示词取决于模型和任务。
带标签的示例通常给出答案,却没有推理过程。STaR 方法生成推理和答案,保留成功示例;出错时,还可以给模型提供包含正确答案的提示,再尝试生成推理。
DSPy 使用类似的自举思路,却不一定需要更新权重:运行训练输入,保留成功轨迹,把不同组合放入提示词并评估系统。随机搜索可以从候选池中抽取六个示例,测试后再尝试另外六个。
让模型提出改进的指令
OPRO 和 MIPROv2 利用既往表现与任务上下文生成并搜索提示词。
反思式优化会询问一次运行中哪些地方做得好、哪些地方做得不好,并据此提出修改。OPRO 把候选指令及其历史分数交给模型,再让它建议一条新指令来测试。
课程开头投票中的提示词就来自 OPRO。研究人员使用同一个目标模型比较生成的指令;在实际 API 评估中,多次试验有助于考虑输出的不确定性。
为什么模型写出的提示词可能有效?对于旧模型,一种直觉是它可能更接近训练分布。今天我认为更重要的用途是:失败轨迹可以暴露遗漏的任务要求,比如必须使用某种日期格式。
我参与主导的 MIPROv2 把三个步骤结合起来:自举生成成功示例、根据任务信息提出指令,再搜索指令和示例的组合。它使用贝叶斯搜索,而不是对所有组合均匀采样。
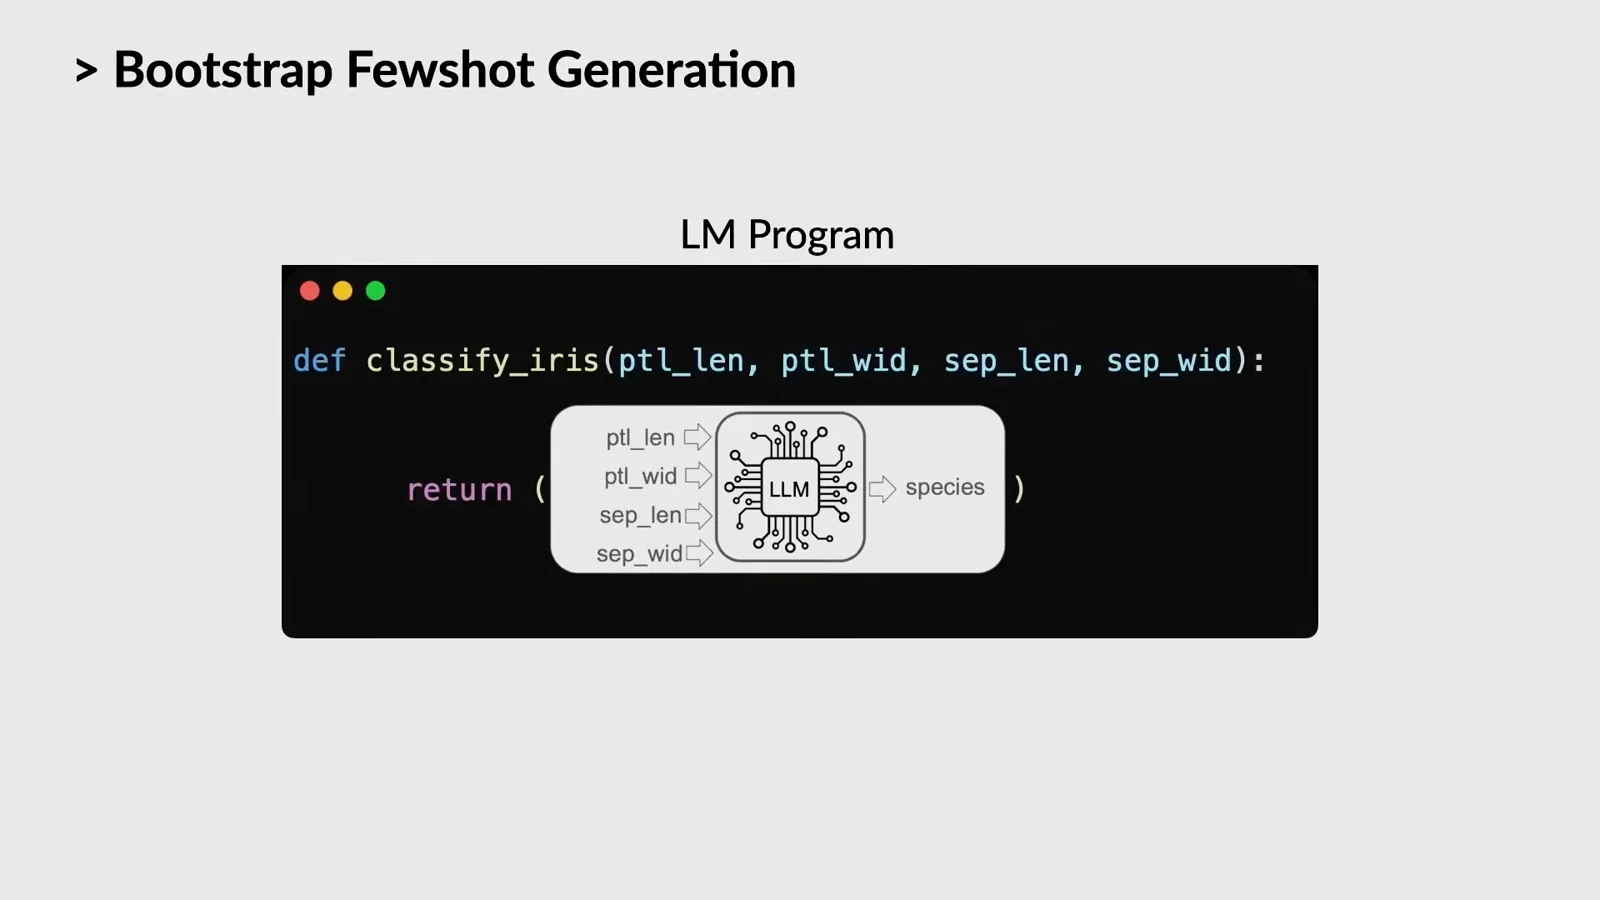
在鸢尾花例子中,程序接收花瓣和萼片尺寸,预测花的品种。运行训练样本并为预测打分,丢弃失败轨迹,保留正确轨迹作为候选示例。
为了提出指令,优化器总结程序、查看训练数据示例,并参考成功轨迹。它不会把留出的开发集示例送入这一步的指令生成过程。
MIPROv2 还使用过一些提示技巧,比如要求模型设想高风险场景或采用某种角色。有些技巧当时有效,但这些具体花招未必和整体方法一样经得起时间考验。
优化器抽取一条指令和一组示例,在一个批次上运行程序,并更新对这些选择是否有用的估计。定期进行完整评估,可以降低噪声批次决定最终组合的风险。
答案正确并不证明随附的推理正确。在那项工作中,我们通常没有监控推理轨迹;评估可以加入对推理质量的判断,但优化不完善的指标可能产生奇怪行为或奖励漏洞。
MIPRO 最终返回的是一组选定的指令和示例,而不是整个分布。搜索可以看成多臂老虎机问题,虽然利用这个分布也许还有其他有趣的方式。
反思失败,保留互补的提示词
TextGrad 和 GEPA 使用文字反馈;GEPA 保留能解决不同案例的候选方案。
TextGrad 用反馈沿语言模型调用链反向传播来描述这一过程。模型查看发生了什么,并为前面的阶段写出文字建议。尽管借用了深度学习术语,这个过程并没有对文本计算真正的导数。
GEPA,即遗传帕累托提示演化,维护一个提示词候选池,并在各个任务上评估它们。某个提示词即使在其他地方不如另一个,只要能解决别人遗漏的案例,仍可能有价值。
该方法向帕累托前沿筛选:如果另一个提示词在相关案例上至少同样好,且表现支配它,就不必继续从被支配的提示词采样。候选池保留互补的方案,方便搜索基于不同优势继续改进。
创建候选的一种方式是反思式变异:抽取提示词,在一批样本上运行,查看输出和指标反馈,再让模型修改提示词。这利用了失败的具体内容,而不只是一个分数。
另一种操作是合并两个候选程序的组成部分。在多阶段系统里,一个提示词可能擅长提取邮件,另一个擅长选择表情;感知系统结构的合并可以把有用部分组合起来。
新候选先接受批次评估。如果有改进,就进行更广泛的评估并加入候选池;否则丢弃。这个过程在固定预算内重复。
一位学生问,从单一种子出发会不会让搜索陷入局部最优。我提出可以尝试像其他方法那样用多条独立生成的初始指令,但我不知道那项工作是否试过这个实验。
课上的隐私示例先用本地模型改写包含敏感信息的用户请求,再把经过脱敏的请求交给强大的外部模型,最后在本地把外部回答与原始请求合并。目的是获得有用推理,又不发送私人细节。
GEPA 会优化系统的第一个和最后一个提示词。候选修改加入识别敏感信息、组织转换后请求和解释转换过程的指引;不同分支改善任务的不同方面。
在课上展示的基准测试表中,GEPA 及其感知系统结构的合并变体总体表现较强。更大的思路是结合有用示例与对真实任务行为的反思,同时记住评估决定了搜索会奖励什么。
被问到候选群体多样性时,我指出保留池受到评估案例上的帕累托前沿限制。修改算法以保留更广泛的候选方案,或许有值得探索的空间。
从教师轨迹训练权重
监督微调可以把智能体行为转移到较小模型中。
权重优化改变的是模型本身,而不仅是上下文。监督微调通过交叉熵损失,提高模型输出正确下一个 token 的概率,从而让模型学习期望的输出。
对于智能体,有能力的教师模型可以在不同环境中完成任务。学生的训练示例包含任务及教师轨迹:命令、工具结果、推理和最终答案。不同流程可能会验证或筛选这些轨迹。
一个示例要求智能体查找匹配的文件、排除某个子目录,并同时捕获标准输出和标准错误。教师编写命令、检查结果并验证捕获内容;这个序列可以成为训练示例。
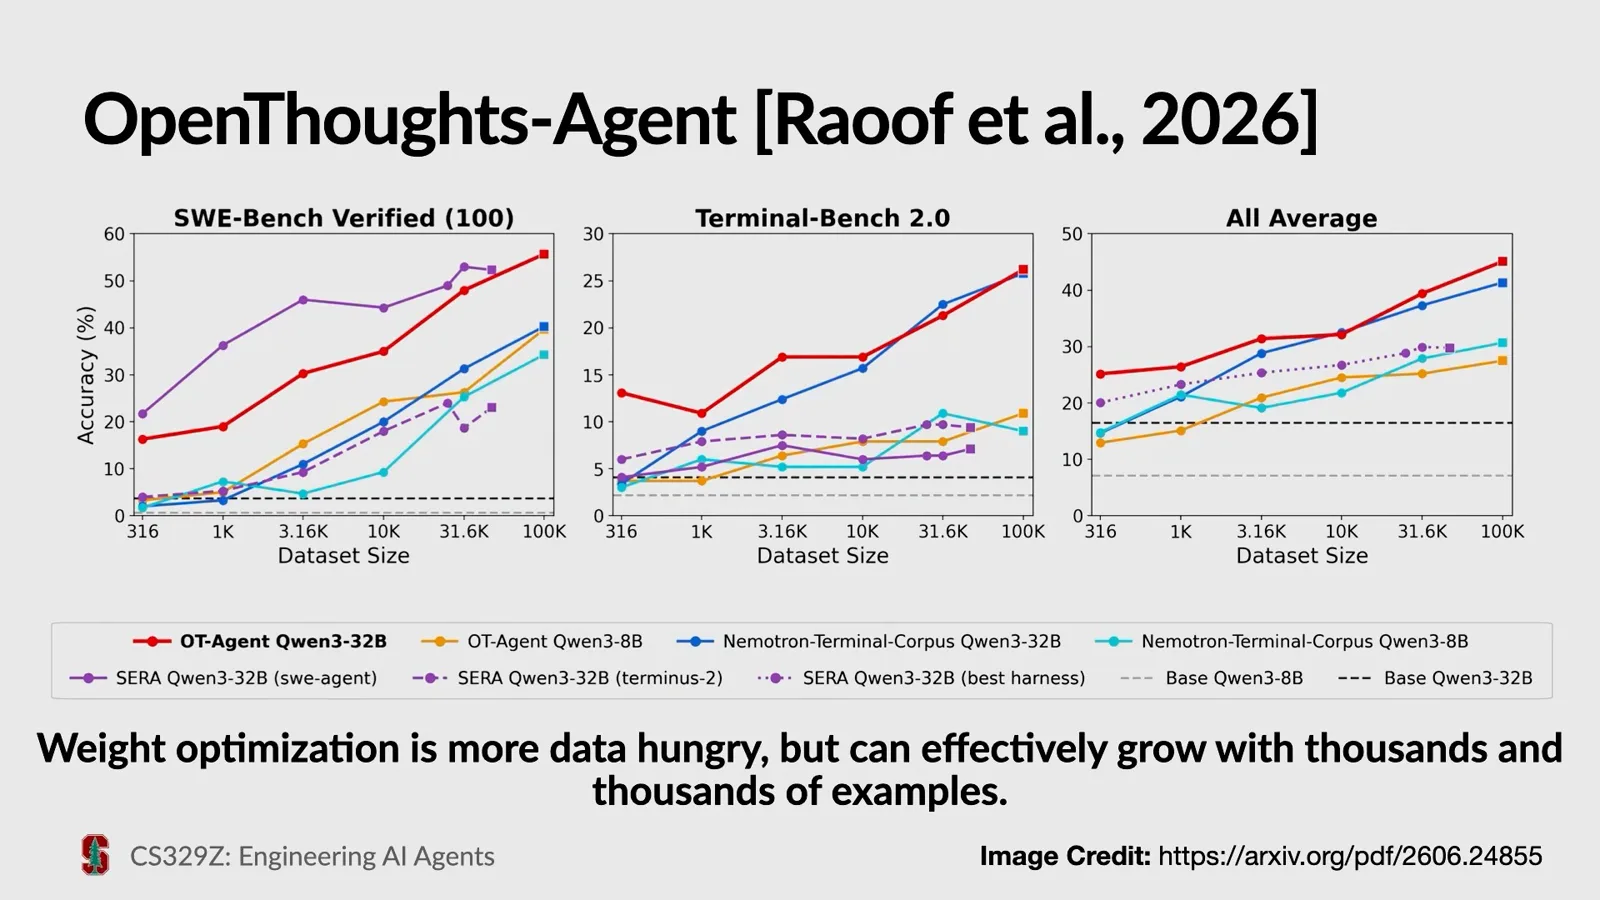
OpenThoughts-Agent 把多个来源的任务混合起来,选择教师模型、生成轨迹并筛选。最强教师不一定总是最佳选择:较小的学生模型可能更容易从接近自身能力的行为中学习。
论文中的图表显示,在展示的任务中,训练数据增多时表现也随之提高。权重训练相对需要更多数据,但有高质量数据和合适的教师时,监督训练可以利用大量示例。
FireAct 混合几种推理模式,用教师生成轨迹、筛除错误结果,再把成功轨迹整理为智能体微调格式。在论文展示的比较中,微调后的小模型超过了一个依靠提示的基线。
学生问这是否属于蒸馏。这通常被称为硬蒸馏:学生学习教师生成的输出。其他形式还可以利用教师概率分布中的更多信息。
奖励学生自己的尝试
Ryan 比较 PPO 和 GRPO 在智能体任务强化学习中的做法。
强化学习则采样学生自己的尝试,并根据结果给予奖励。对于编程,测试可以提供可验证的信号;无法直接验证时可以使用模型评判,但训练仍需要某种奖励。
在文件搜索的例子里,可以把输出文件与预期结果比较,并奖励正确匹配。通过改变任务、环境和难度,让学生在不同条件下练习自己的行动。
近端策略优化,也就是 PPO,使用正在训练的策略模型、奖励信号、参考模型以及通常还会有的价值模型。参考模型有助于防止模型偏离过远;价值模型估计轨迹中各位置的作用。
PPO 示例结合了最终奖励、与参考模型的差异以及逐 token 的价值估计,再通过优势估计,帮助策略更倾向于当时被判断为优于其他选项的动作。
这种做法成本不低:需要把多个模型放在内存中,更新策略和价值模型,还要跨 token 计算价值。奖励可以来自环境而不是单独的模型,但其他机制仍然昂贵。
DeepSeekMath 提出的 GRPO 会针对同一个任务采样一组答案,并给每个答案打分。它移除单独的价值模型,改用组内奖励分布来估计相对优势。
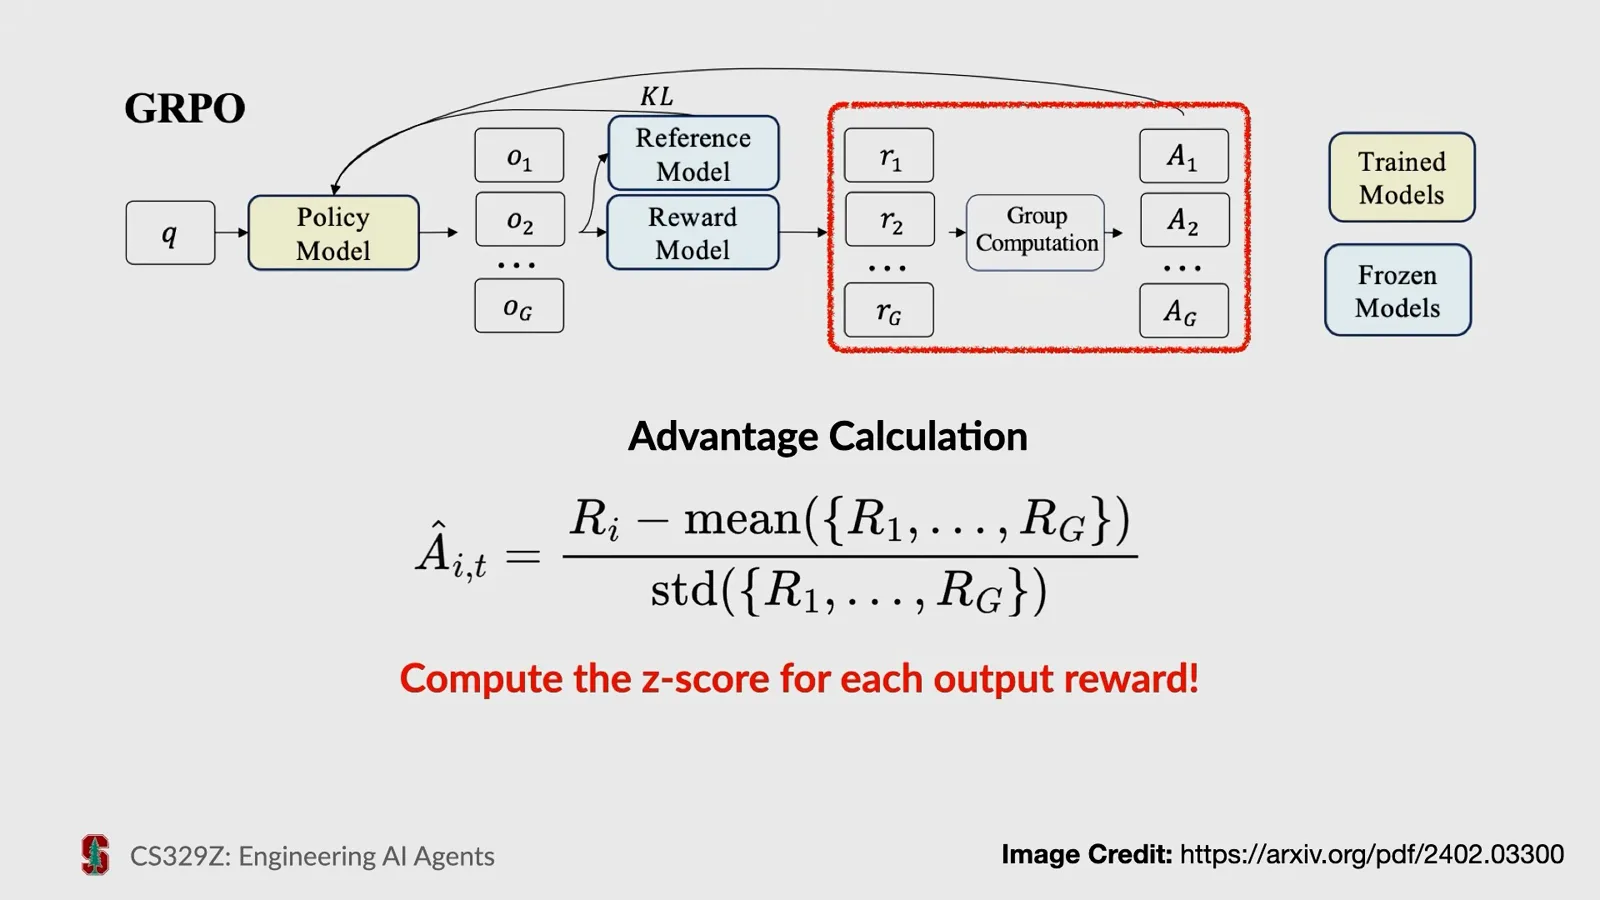
例如,一组代码解答平均通过十个测试中的四个,而其中一个通过七个,那么这个解答高于平均水平。用它的奖励减去组内平均奖励,再除以标准差,就得到归一化优势。
GRPO 目标函数使用当前策略与旧策略的概率比,再用相对优势加权。裁剪可以限制不稳定的更新,参考模型项则可以约束策略偏移的幅度。
DeepSeek R1 展示了一种实际组合:先用强化学习生成推理行为,收集示例进行监督训练,再继续训练。课程比较的是论文中特定数学任务上的 GRPO 与 PPO,而不是把某个结果视为普遍规律。
监督训练可以先让学生具备开始解决任务的能力,强化学习随后让它面对更多样的环境。如果在特定场景下,强化学习的表现不如可用的监督方法,就没有必要只因为它的名字而使用它。
教师可以对学生自己的轨迹打分
同策略蒸馏把学生生成的行为与更密集的教师信号结合。
同策略蒸馏提供了另一种选择。看国际象棋大师下棋,与自己下棋并由教练针对你的走法反馈不同;后者的反馈适用于你实际遇到的局面。
普通监督训练由教师生成轨迹;强化学习中学生自己行动,可能只得到最终分数。同策略蒸馏让学生行动,再由教师通过 token 概率评价其选择,提供更密集的信号。
课上的示例中,一个学生在算术题里忽略了热锅中的冰块会融化。教师逐 token 的概率可以在学生自己的回答展开时,对这一错误假设给予惩罚。
Ryan 比较了一个 Qwen 示例,其中离策略蒸馏、强化学习和同策略蒸馏得到不同效果与成本。在展示的实验中,同策略方法用更少的 GPU 小时取得了最高分;这是该实验设置下的结果。
用智能体执行搜索
自修改运行框架与 autoresearch 把代码修改和实验组成循环。
Darwin Gödel Machine 把智能体自己的运行框架视为可修改的代码。它保存版本档案,选择较早的候选继续修改,评估后产生分支。探索旧版本与改进最新版本同样重要。
在 autoresearch 中,智能体在代码仓库里提出修改、运行实验,并依据指标保留或撤销修改。评估是控制这一过程的关键:如果指标不好,自动迭代就可能优化错误的东西。
选择上下文、权重,或两者结合
合适的选择取决于访问方式、运行成本、提示词长度和可用训练数据。
提示词优化和权重优化可以配合使用。一项研究依次进行提示词优化、权重训练和再次提示词优化;课程还对比了 GEPA 的样本效率与权重训练利用更大数据集的能力。
当强模型只能通过 API 访问、任务经常变化或与环境交互的运行成本很高时,可以选择上下文优化。小模型对提示不够敏感、可以用教师训练更便宜的学生,或不断增长的提示词过长时,可以考虑权重训练。
同频道的其他文章
 58:52EN → 简体中文
 Stanford Online· 2026年11月17日Cynthia Bailey:明确 AI 智能体能做什么、何时必须停止Cynthia Bailey · Stanford University连接器让模型通过其他应用采取行动;明确权限、人工检查和停止条件决定了行动的安全程度。
 1:09:27EN → 简体中文Stanford Online· 2026年11月17日Cynthia Bailey:AI 上线后仍要持续测试Cynthia Bailey · Stanford University旧测试数据可能遗漏用户行为的变化。Bailey 介绍如何用独立审查、上线后检查和更好的数据发现 AI 风险。
 1:18:55EN → 简体中文Stanford Online· 2026年11月16日Michael Ryan:AI 智能体越多,任务可能越难Michael Ryan · Stanford University并行智能体能探索更多方案,但协调成本和相互冲突的工作可能让单个智能体更有效。
 1:18:54EN → 简体中文Stanford Online· 2026年11月15日AI 智能体记忆:该保存、检索和遗忘什么Michael Ryan · Stanford UniversityMichael Ryan 比较智能体记忆架构,并解释为什么记住更多不一定能改善决策。
 1:16:51EN → 简体中文Stanford Online· 2026年11月14日Michael Ryan:从控制流与上下文选择智能体模式Michael Ryan · Stanford University斯坦福 CS329Z 课程讲解工作流、推理与行动循环,以及让智能体上下文保持聚焦的方法。
 1:17:14EN → 简体中文Stanford Online· 2026年11月13日DSPy、LangGraph 与 AI 智能体周围的工程Michael Ryan · Stanford UniversityMichael Ryan 通过日历演示比较智能体框架,并说明评估、恢复和追踪为何重要。