30 秒看懂
Dwarkesh Patel 与 Ron Minsky、Dan Pontecorvo 一同参观 Jane Street 位于得克萨斯州的训练数据中心。他们介绍了原本为低密度风冷设计的设施如何适配高密度液冷 GPU 机柜,以及团队如何监测泄漏、电力和冷却。 参观还涉及算力的机会成本、网络、基础设施灵活性,以及公司从六台电脑的集群发展到现代低延迟系统的历程。
- 1冷却 GPU 服务器托盘液体流经冷板和快速接头;Pontecorvo 说,这些设备移除了托盘的大部分热负荷。
- 2平衡冷却液流量阀门和超声波流量计将建筑物的冷却能力分配到各机柜;热交换器将技术水回路分离出来。
- 3为 4,032 个 GPU 供电团队在各条母线槽之间平衡机柜负载,避免断路器过载并中断训练任务。
- 4算力的机会成本Minsky 说,内部团队竞争稀缺算力时,其机会成本可能比硬件成本更加重要。
- 5监控供电拓扑软件整合设施测量数据,并可关闭工作负载以避免断路器跳闸。
- 6从六台电脑到数据中心Minsky 回忆了早期在办公室里堆放的六台 Dell 电脑组成的集群,后来公司才将系统搬入机柜。
要点建议
- 得州设施在 56 个机柜中部署了 4,032 个 GPU,并使用液冷处理高密度 GPU 硬件的热量。
- 泄漏检测、过滤和流量平衡是运行液冷设施的关键。
- 即使有可用的地面空间,也必须管理电力配额与配电。
- 监控和受控的工作负载关闭有助于保护超额分配的基础设施,避免中断。
- 当内部需求超过可用容量时,算力的机会成本可能很高。
- 高密度计算需要大量电力、冷却和网络配套设施。
按章节阅读整理后的全文
GPU 集群与液冷
Patel 在得州设施与 Minsky 和 Pontecorvo 会面。他们介绍高密度 GPU 硬件、冷板和泄漏检测。
Dwarkesh Patel 与共同领导技术团队的 Ron Minsky 和物理工程团队负责人 Dan Pontecorvo,一起参观 Jane Street 在得克萨斯州的训练数据中心。Minsky 说,这个集群训练多种模型,包括语言模型,以及针对交易问题和数据集调整的定制架构。
建筑最初是为较低密度的风冷设计的。Pontecorvo 说,GPU 机柜的峰值功耗每个约为 140 kW,而传统风冷机柜约为 10–40 kW。其他一些负载仍使用风冷。
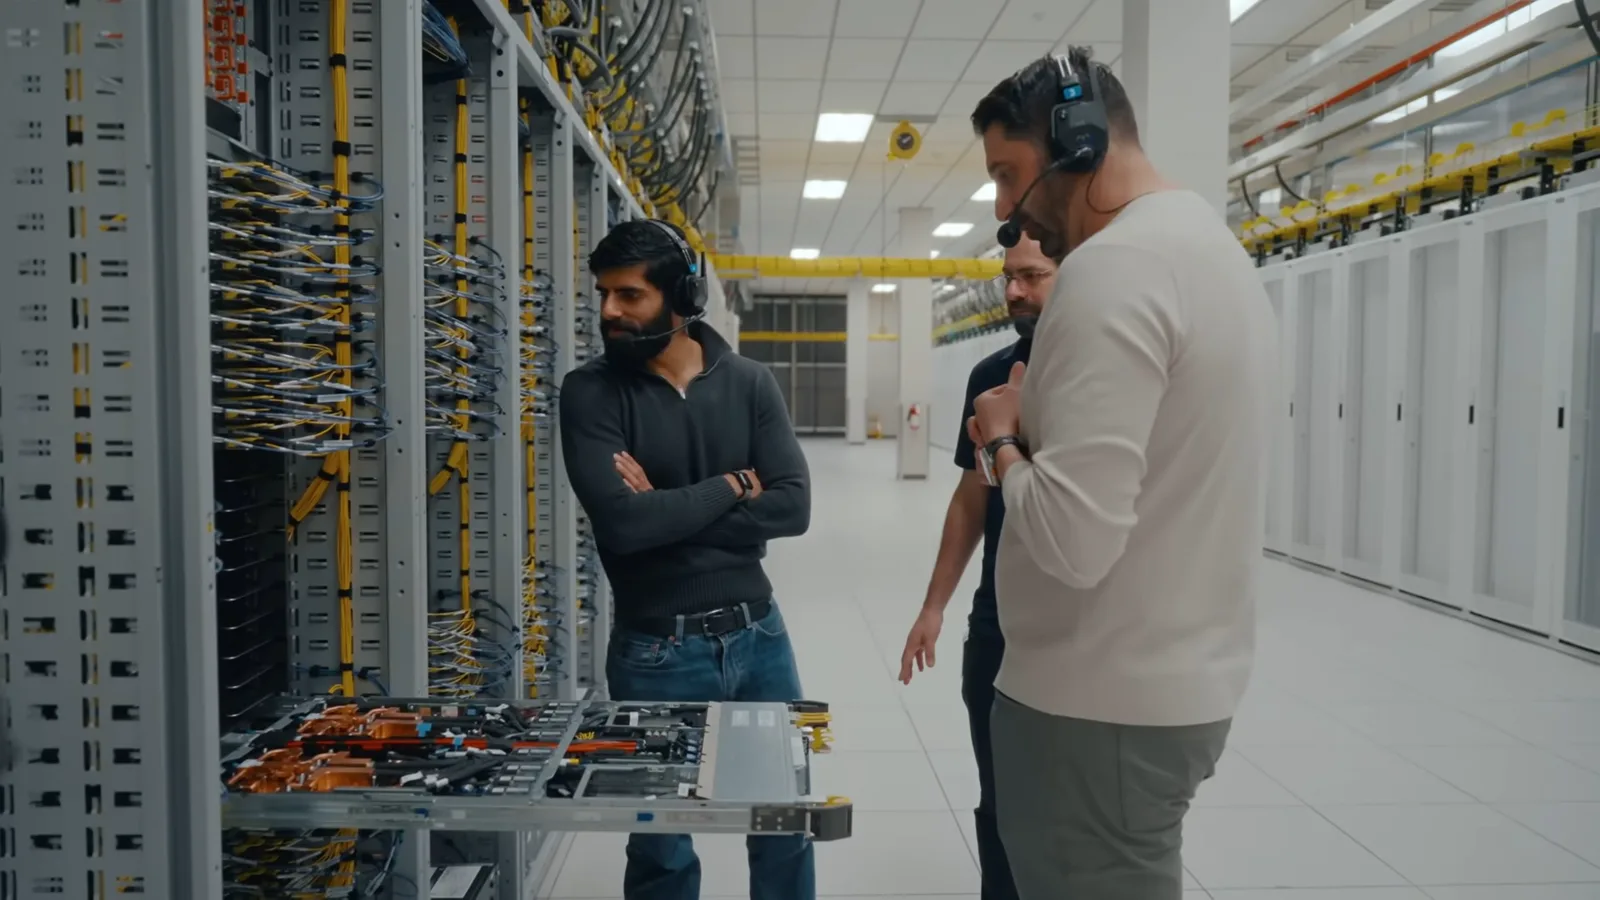
在 GPU 服务器托盘内,液体通过快速接头进入,流经 GPU 上的冷板,然后以更高的温度返回。推入托盘时,液体供应和回流管路以及 54 伏电源都会接通。Pontecorvo 说,冷板移除了托盘约 85%–90% 的热负荷;有些组件仍由空气冷却。
Minsky 问起泄漏问题:数据中心历来都试图让水远离设备。Pontecorvo 指出,设备内部和地板下都有漏水检测绳,系统还配有警报和隔离阀门。他说,到目前为止泄漏并不常见,但这项技术还很新,故障仍可能毁掉服务器。
被问到为什么可以完成改造时,Pontecorvo 称这是一项工程挑战。Minsky 强调了背后的规划:团队知道需要扩大规模,却不确切知道未来的计算设备会是什么样,因此在电力和冷却设计中留出了灵活性。
冷却回路与分配
团队平衡各机柜的流量,并将建筑冷却回路与清洁的技术水回路分开。改造利用架空地板容纳管道和检测设备。
屋顶的冷水机组供应约 18°C 的流体,同一建筑回路既能支持风冷,也能支持液冷。阀门平衡每个机柜的流量,避免一排开头的设备取走太多冷却液、末端设备却得不到足够供应。超声波流量计以升每分钟为单位测量流量。
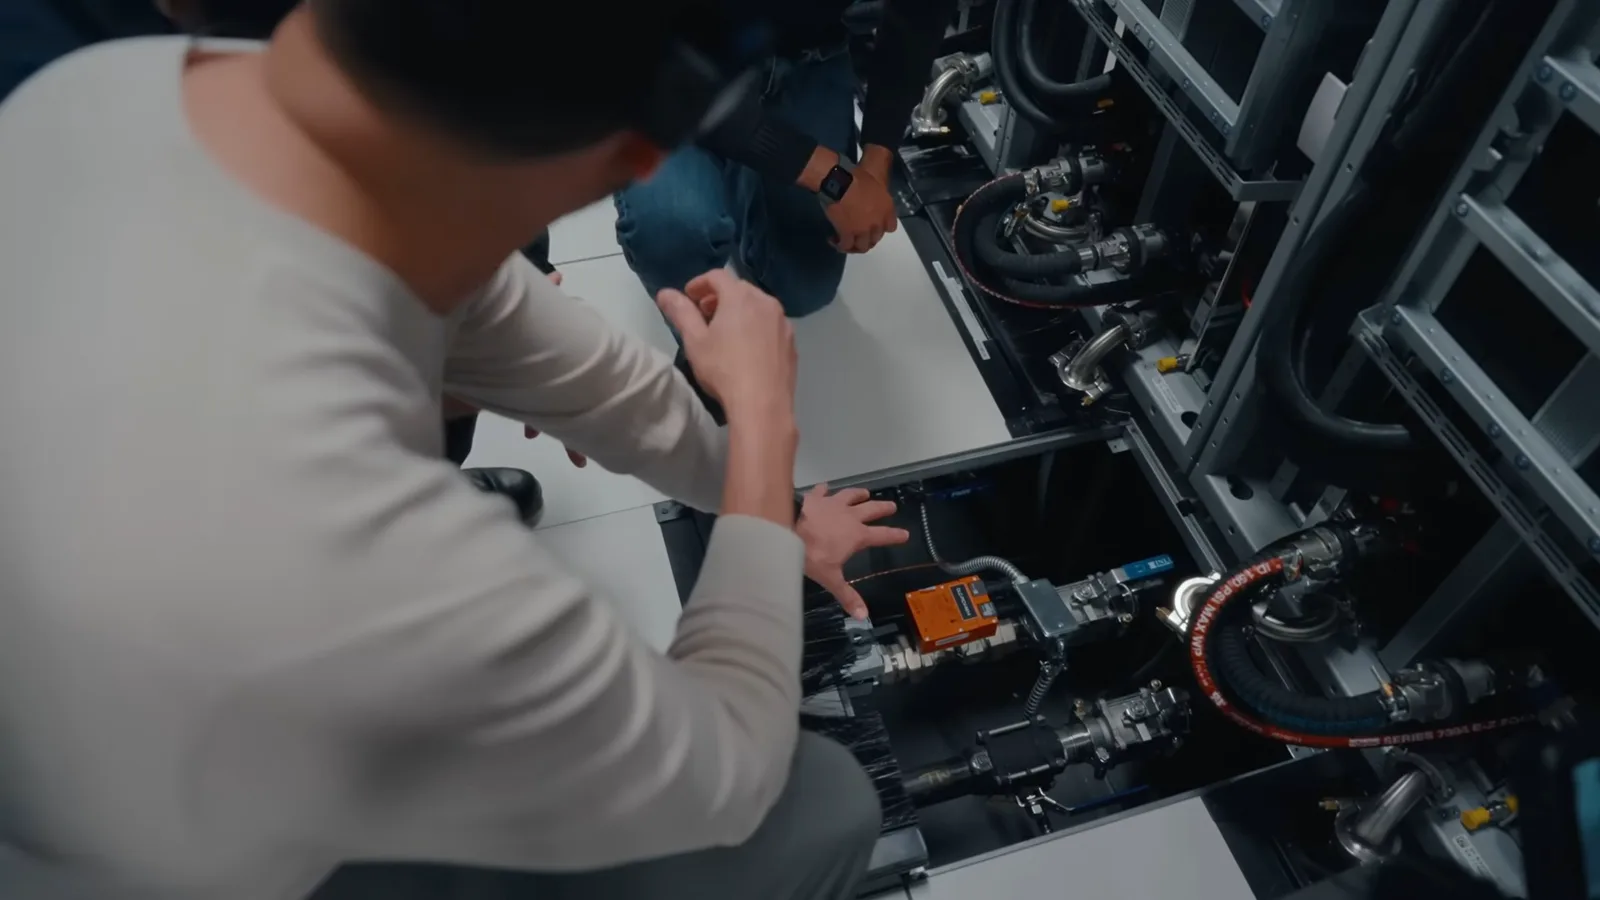
在冷却液分配单元内,热交换器在建筑回路和独立的技术水回路之间传递热量。Pontecorvo 说,后者必须保持清洁并过滤至 25 微米,以免 GPU 冷板堵塞。流体包含蒸馏水或去离子水以及 25% 的丙二醇,用以抑制生物生长。
液冷带来了泄漏、流量和污染等问题,与单纯向房间输送冷空气不同。建筑的架空地板原本用于送风,现在也容纳了管道和漏水检测线缆。Pontecorvo 将其与架空管道作对比:较新的设施常用后者来加快部署。
电力、容量与网络
设施在 56 个机柜中部署了 4,032 个 GPU。几位嘉宾讨论机会成本、固定电力配额、光纤和灵活分配。
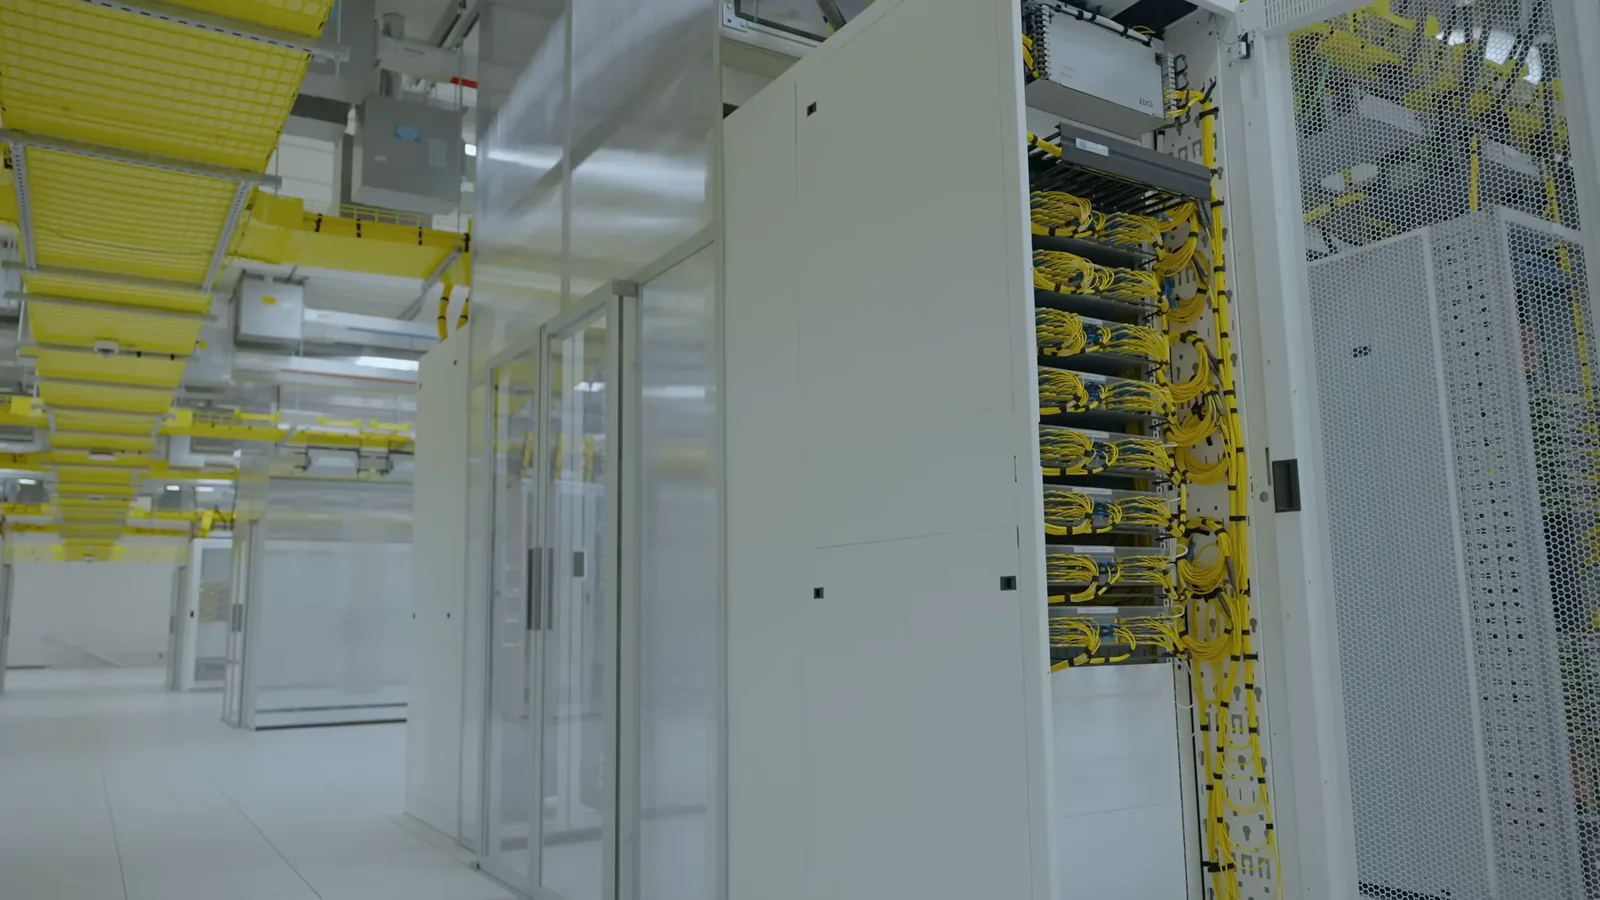
该设施在 56 个机柜中部署了 4,032 个 GPU。配电必须保持平衡,使母线槽的负载不超过其额定电流,避免断路器跳闸。训练中断可能迫使任务回退到较早的检查点。
Patel 询问一个机柜每小时的成本。Minsky 区分了硬件、电力成本和机会成本。算力需要时间才能上线,而各团队要竞争有限的供应;他说,由于产出对业务很有价值,机会成本可能超过本已不低的硬件成本。
当设备密度提高而电力配额不变时,同样的电力预算只需占用更少的地面空间。Pontecorvo 说,目标是在配额范围内有效利用电力。地面空间空着,并不意味着电力容量也有剩余。
Minsky 指出,更高的密度可以简化复杂的网络布局。他介绍说,机笼外使用光纤,对延迟敏感的最快内部连接则使用铜缆。Pontecorvo 说,此次部署使用了约 8,000 公里光纤。
灵活性也取决于分配系统。Pontecorvo 解释说,团队在部分分配系统中预留额外容量,以便在设施总限额内将电力和冷却能力转移到不同排。当业务需要时,这就为增加 CPU 或 GPU 容量留出了空间。
断路器与监控
供电路径有电流限制,需要仔细平衡。监控系统可以在断路器中断工作之前应对高负载。
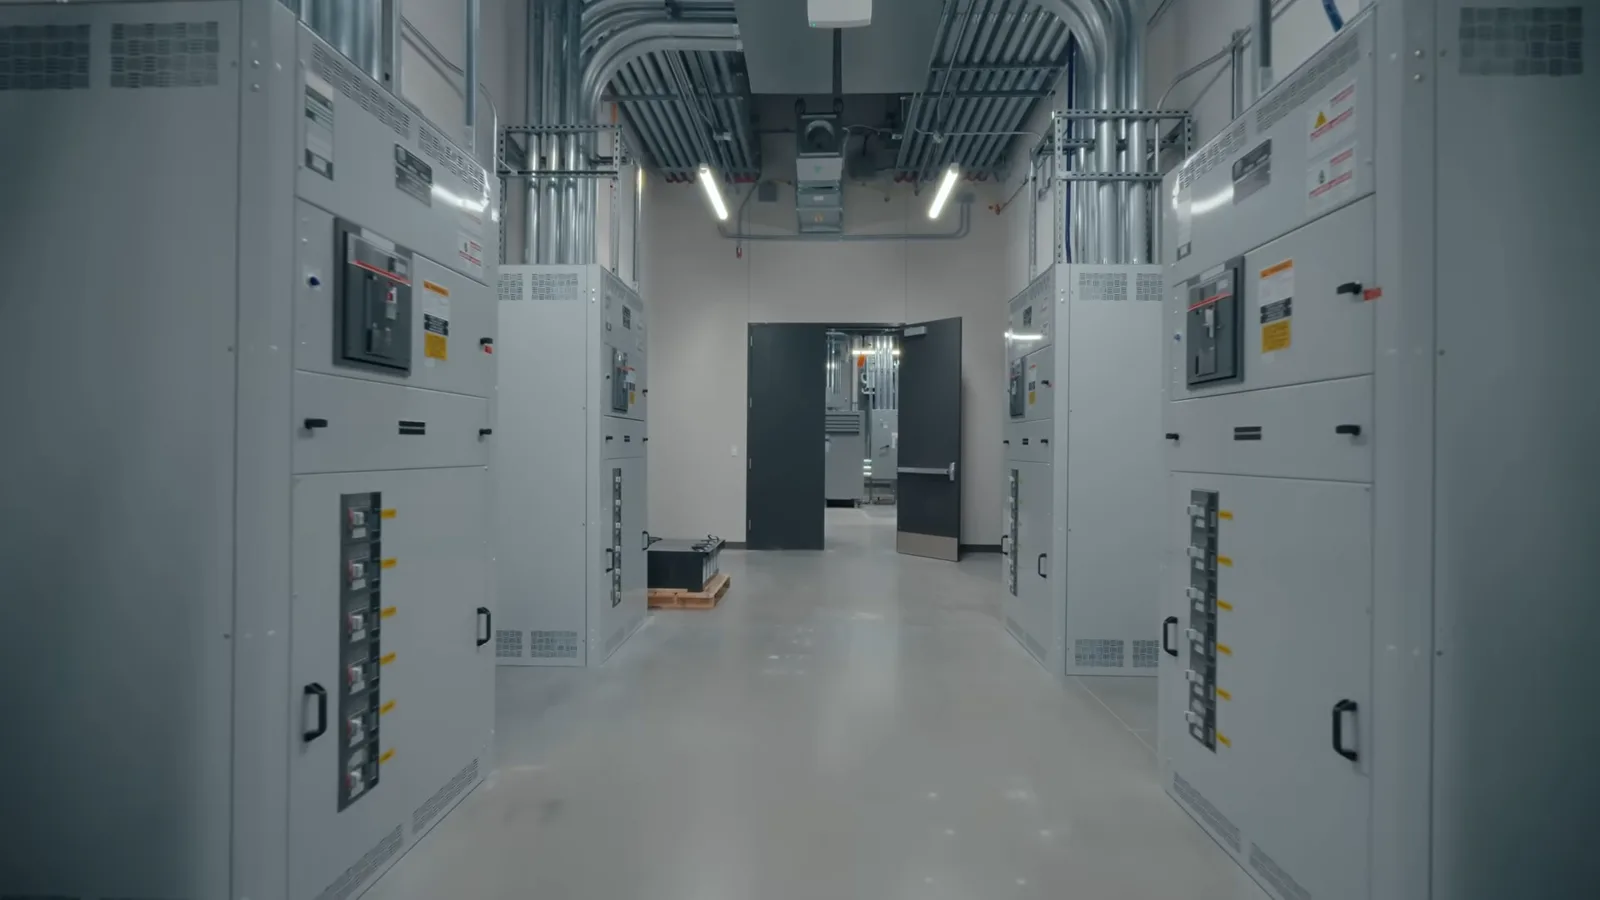
断路器面板向机房内的母排分配电力。Pontecorvo 说,电力容量不如冷却能力容易调配:加大管道可以将流体输送到不同位置,但每条供电路径都有断路器和电流限制。母线跳闸时冗余设计有帮助,但中断仍然不理想。
如果一条路径上的负载过大,或实际需求超过超额分配时的假设,断路器就可能跳闸。Pontecorvo 介绍了 NVIDIA 的负载管理工作:利用电容和软件平滑负载曲线,让峰值功耗与平均功耗更加接近。
Minsky 说,Jane Street 构建了监控工具,将设施的多个方面汇集到一个视图中。系统能发现问题,有时还可以关闭耗电过多的工作负载。Pontecorvo 补充说,系统会读取断路器信息并理解供电拓扑,从而在跳闸前采取受控措施。
目标是在保持安全余量的同时,让昂贵的硬件接近可用容量运行。Minsky 说,只要有保障机制让系统能够受控地收缩负载,超额分配就可能有用。设施正在运行,因此关闭断路器可能中断活跃的工作负载。
基础设施与早期历史
缓冲水箱和阀门有助于提高冷却系统的可靠性。Minsky 回忆了早期由六台电脑组成的集群,并解释交易对延迟的需求如何变化。
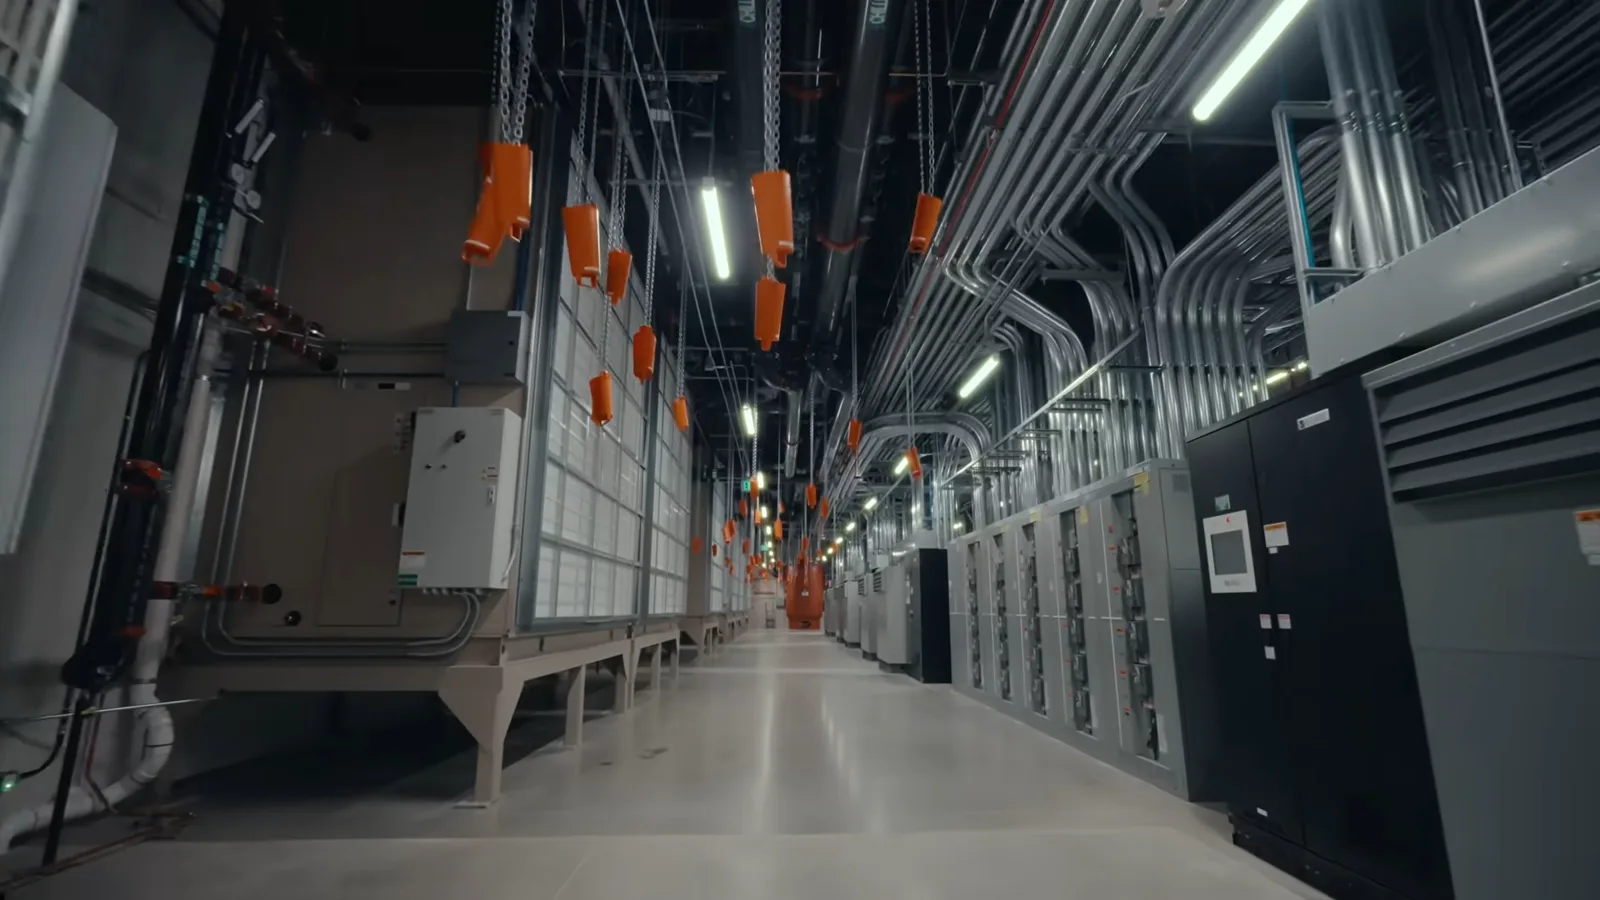
Pontecorvo 展示了像热电池一样工作的缓冲水箱。如果电力中断,屋顶冷水机组需要重新启动,储存的冷量可以在机组恢复期间继续冷却 GPU。水箱也能缓和负载升降带来的温度波动。
传统风冷机组仍是设施的一部分,阀门允许团队隔离冷却系统的部分区域进行维修。Pontecorvo 观察到,随着计算设备密度提高,电脑占用的空间相对于支撑它们所需的变压器、冷水机组等基础设施越来越小。
Minsky 回忆了大约 20 年前小得多的一套设备。早期一个名为 Hive 的集群,实际上就是六台 Dell 电脑,堆放在办公室里工作人员附近。它支持对交易策略的量化研究。
交易系统最初也放在附近,因为人们希望出问题时能够亲手关闭它们。团队花了一段时间才对控制、标识和访问管理建立起足够信心,将设备搬入别处的机柜。甚至有一次,一位清洁人员白天吸尘时拔掉了一套交易系统的电源。
Patel 问,为什么那些早期系统不需要与交易所同址部署。Minsky 说,公司早期交易速度并不特别快:不同策略关注的时间尺度不同,从秒到毫秒、微秒都有。他说,如今有些最快的系统力求在 100 纳秒以内完成一个数据包的处理和返回。
同频道的其他文章
 1:34:29EN
 1:34:36EN → 简体中文
 1:20:57EN → 简体中文
 1:12:58EN → 简体中文
 58:47EN → 简体中文
 3:13EN → 简体中文