30 秒看懂
微软产品经理 Keiji Kanazawa 让编程智能体重构三周后发现,所谓的智能体只是普通工作流,测试调用了付费生产推理,日报也没有内容。他重新编写规格和结果评估标准,同时继续把代码交给智能体。他的视频分析工具能挑选画面并解释公式,但智能体写的评分标准曾过度适配单个讲座。他因此用多个例子检验标准,并让编程智能体互相审查。
- 1“智能体”没有可检查的运行轨迹摘要中一处内容错位,让 Kanazawa 发现获批设计里的名称与实际实现不符。
- 2单元测试一天调用生产推理约 30 次意外产生的费用约为他平时一周的五倍,另一项每日反思任务也只产生空报告。
- 3他以明确规格和结果评分标准重新开始他继续使用编程智能体,给重建后的系统设定更清晰的目标,并比较四种框架。
- 4视频智能体把选出的画面和公式配上解释原型从一段讲座中提取约 440 帧,并支持针对具体内容提问。
- 5评分标准本身过度适配了一段讲座该标准在另外五段视频上表现不佳;他让智能体修改标准,使其更具通用性。
- 6他掌握目标,让智能体互相审查代码Kanazawa 仍将大部分实现交给智能体,并反复调整评估标准,而不是逐行阅读。
要点建议
- 检查实现是否符合名称的实际含义,而不只看计划是否获批。
- 让测试与付费生产推理隔离,并关注费用告警。
- 用评估标准描述期望结果,再根据实际输出修改标准。
- 用多个例子测试评分标准,发现过度适配。
- 让编程智能体反复交叉审查,同时由人掌握目标。
按章节阅读整理后的全文
个人研究工作流演变成智能体项目
Kanazawa 说明自己倾向于委托代码,并介绍播客摘要工具如何扩展为定时研究系统。
我让编程智能体重构了三周代码,然后读了结果。有人主张让智能体消耗更多 token 完成工作,也有人主张慢下来读代码;我强烈倾向前者。
我是微软的产品经理,过去做过开发和 AI 研究。工作忙,没时间听播客,于是我制作了下载、转写和总结播客的技能。项目逐渐扩展到抓取 X 和网页、接收邮件链接、定时运行,最终变成一套大语言模型驱动的知识库。
最初的步骤是确定性的,例如下载并转写视频。后来我增加了更像智能体的任务,包括深度研究和每天反思自己如何使用 Claude Code,并为带有定时任务和智能体注册表的运行时写了规格。
我让 Codex 和 Claude 轮流实现功能、互相审查代码。后来,一份摘要把一句话放错了部分。我问 Claude Code 智能体的运行轨迹在哪里,想分析错误并建立评估;它回答说,系统实际上并不是一个真正的智能体。
一处摘要错位暴露重构问题
预期中的智能体并未真正实现;连接生产推理的测试产生意外费用,定时报告也为空。
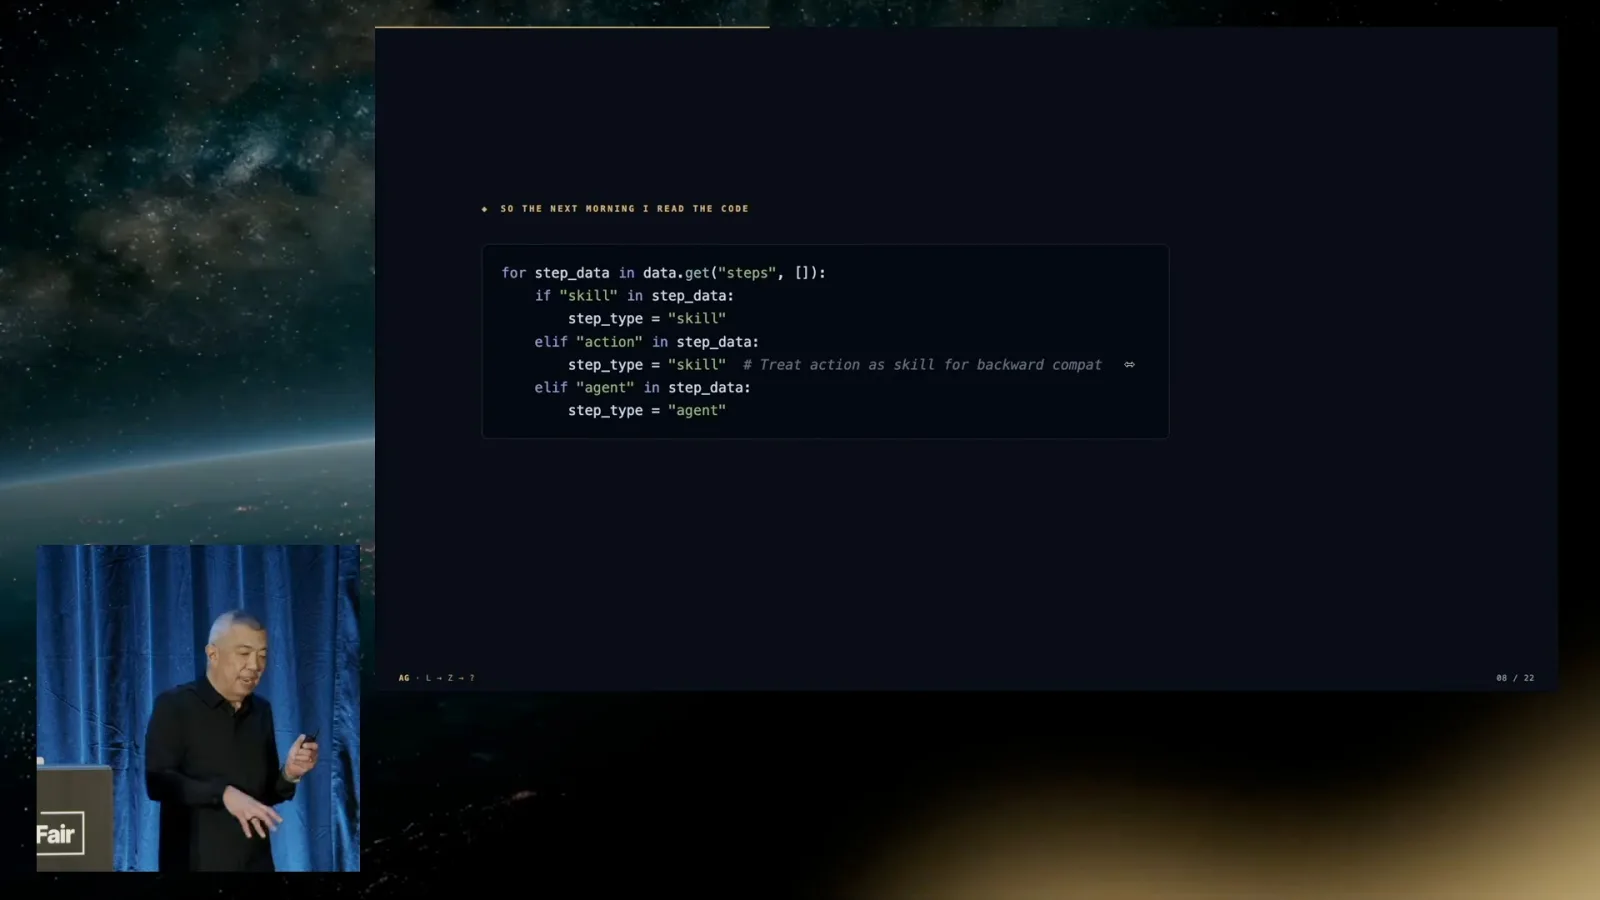
读了实现后,我发现自己不喜欢这个显然曾获我批准的设计。我看过计划,也接受了智能体和技能这样的熟悉名称,但实现并不符合其含义。所谓技能没有技能文件和脚本,智能体也没有运行在智能体 SDK 上。
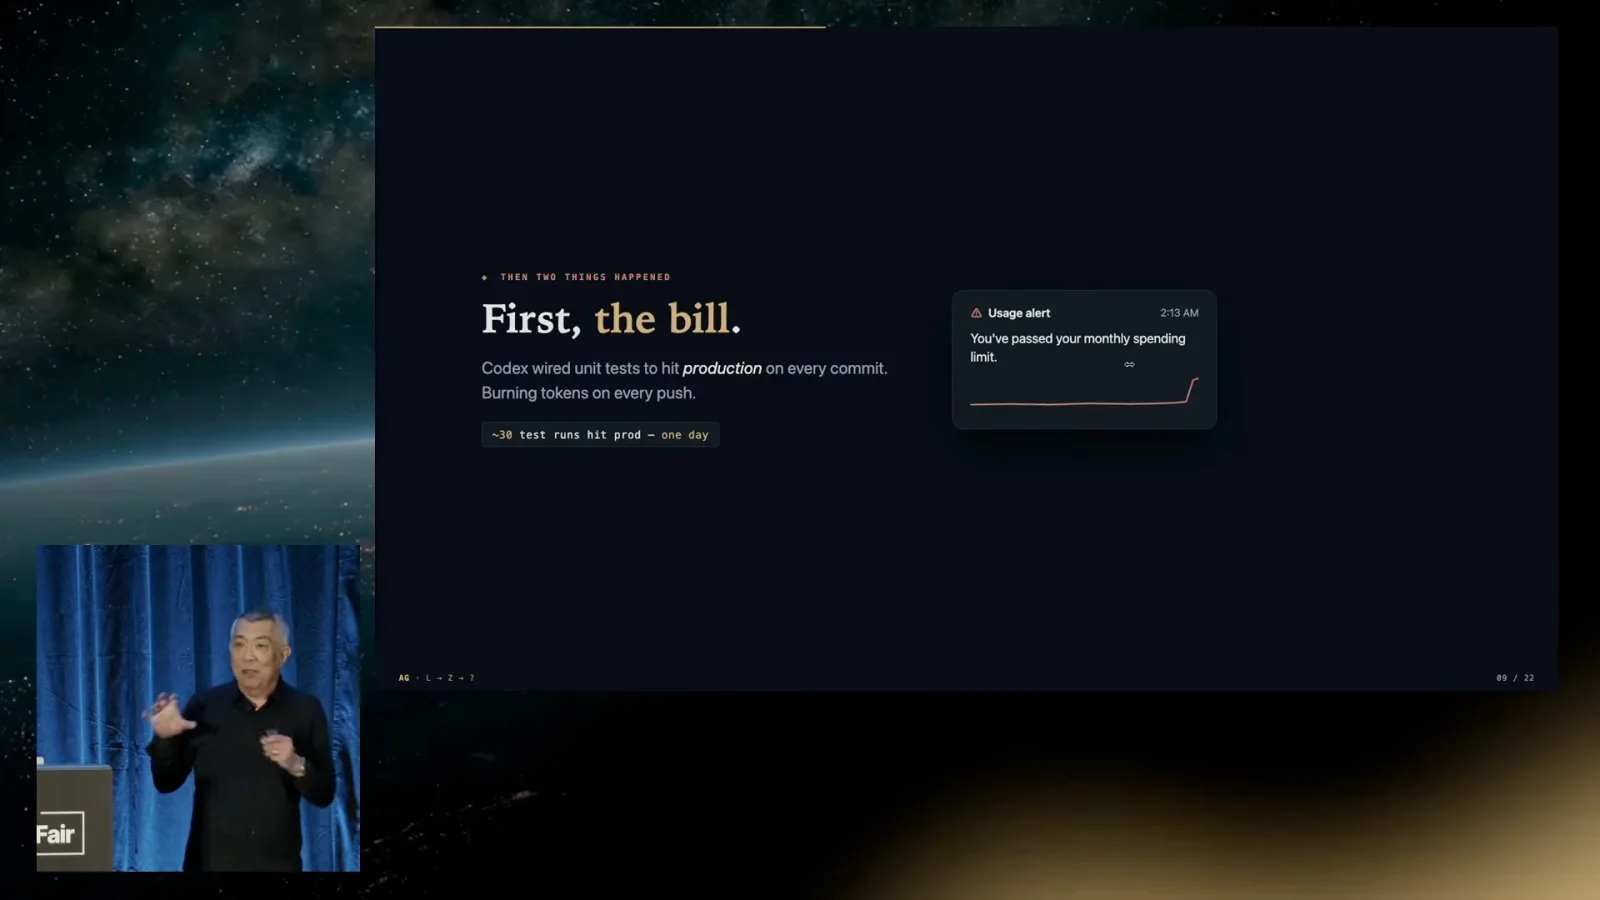
随后,一家服务商在月初提醒我已超出通常预算:大约 100 美元,相当于我平时一周花费的五倍。Codex 把单元测试接到了生产推理服务,一天大约 30 轮测试消耗了付费 token。
我还发现每天的反思任务虽然照常运行,却生成了空报告。重构过程中,原本用于生成报告的提示词已经不再执行。
用明确目标重建并比较工具
他围绕注册表、规格和结果评分标准重新搭建系统,并比较四种编程工具。
让智能体重构三周后,我不相信任何一个工具能修好原有系统。我决定重新实现,编写新的规格和结果评分标准。我仍然使用编程智能体:作为产品经理,我没有打算亲自写完整系统。
新的运行时有智能体注册表,使用智能体 SDK。我向编程智能体说明要构建什么,让生成的智能体在画布上输出结果。为了选择工具,我让四种框架分别构建同类体验。
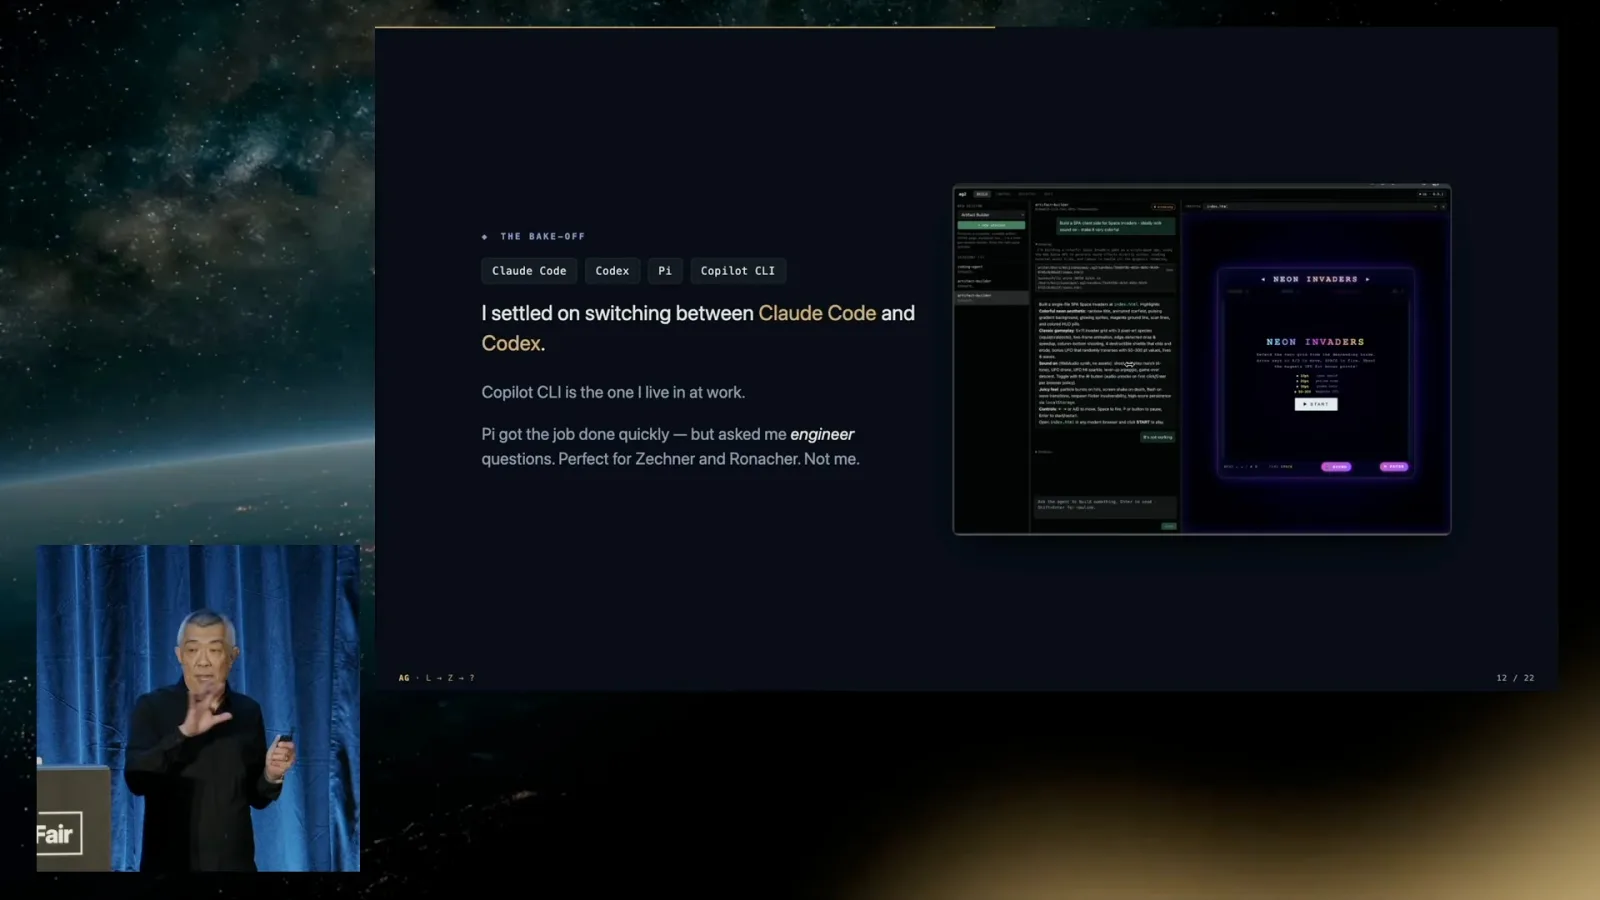
个人项目中,我最终选择交替使用 Claude Code 和 Codex;工作中则主要用 Copilot CLI。Pi 很快做出了好看的体验,但它向我提出数据库和 API 架构方面的问题,而这些并不是我作为产品经理想决定的事情。
提取视频画面并评估结果
视频分析智能体把技术讲座整理成可探索的画布。他通过迭代评分标准纠正排版问题和过度适配。
我重新加入了转写、摘要和邮件功能。此前 YouTube 工作流只总结字幕文本;后来我看到 Reiner Pope 关于大语言模型推理数学的黑板讲座,这与我的工作直接相关,因此我也想理解视频画面。
我搭建了一个视频深度分析智能体,从这段讲座中提取约 440 个关键帧,再用评估标准选择有用画面并提取公式。生成的画布展示章节、黑板内容和解释,我可以跳转到视频,也可以让智能体解释某个公式。
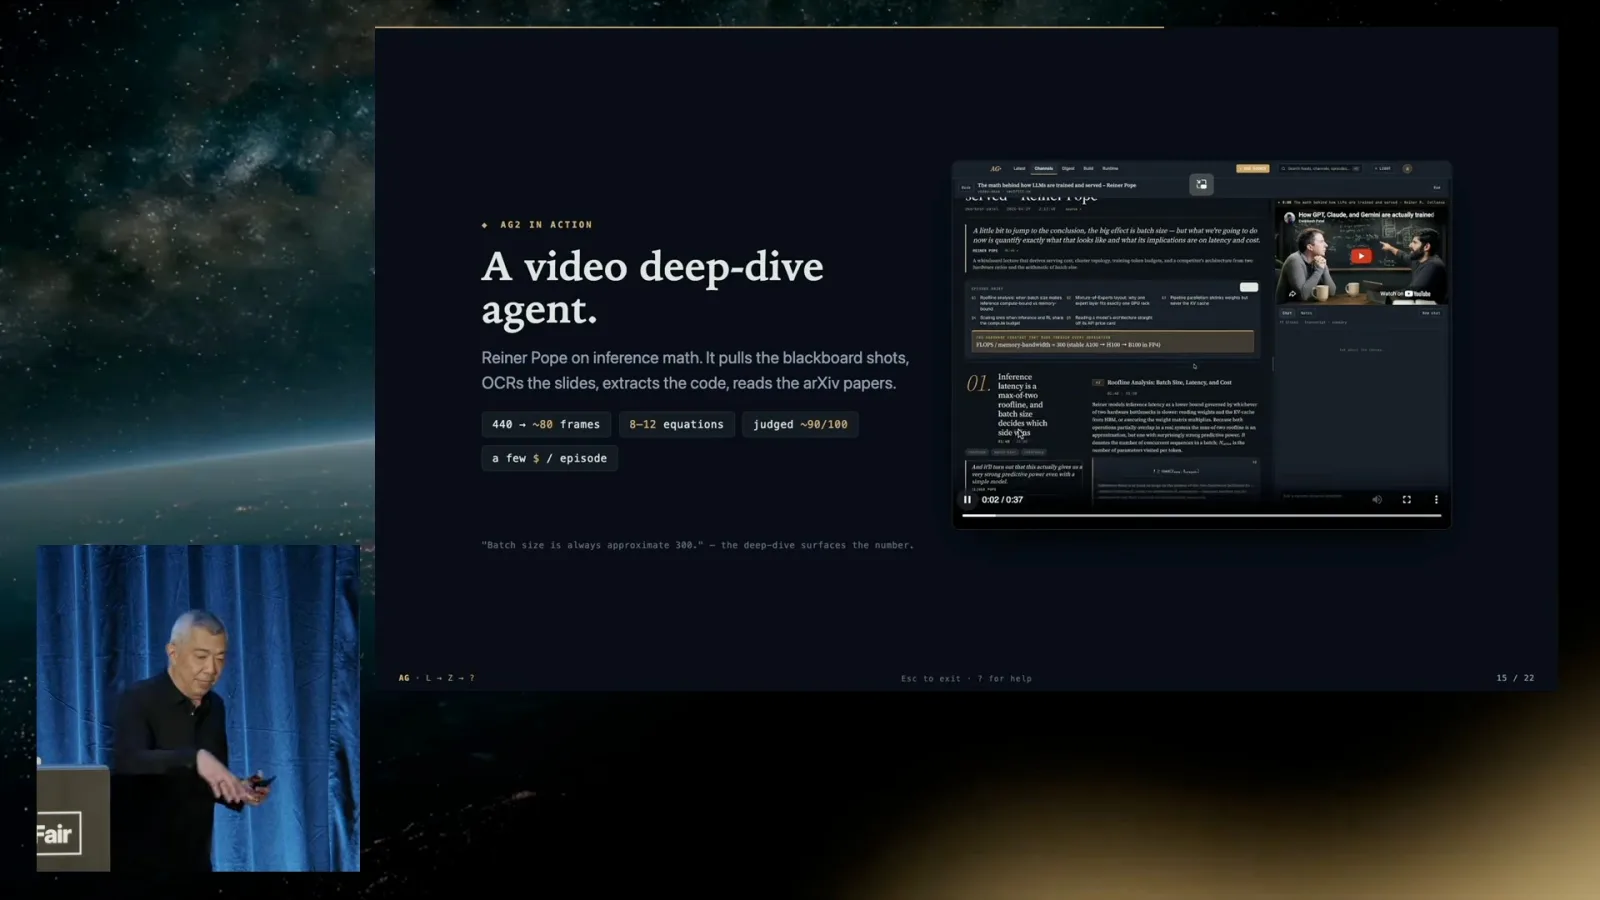
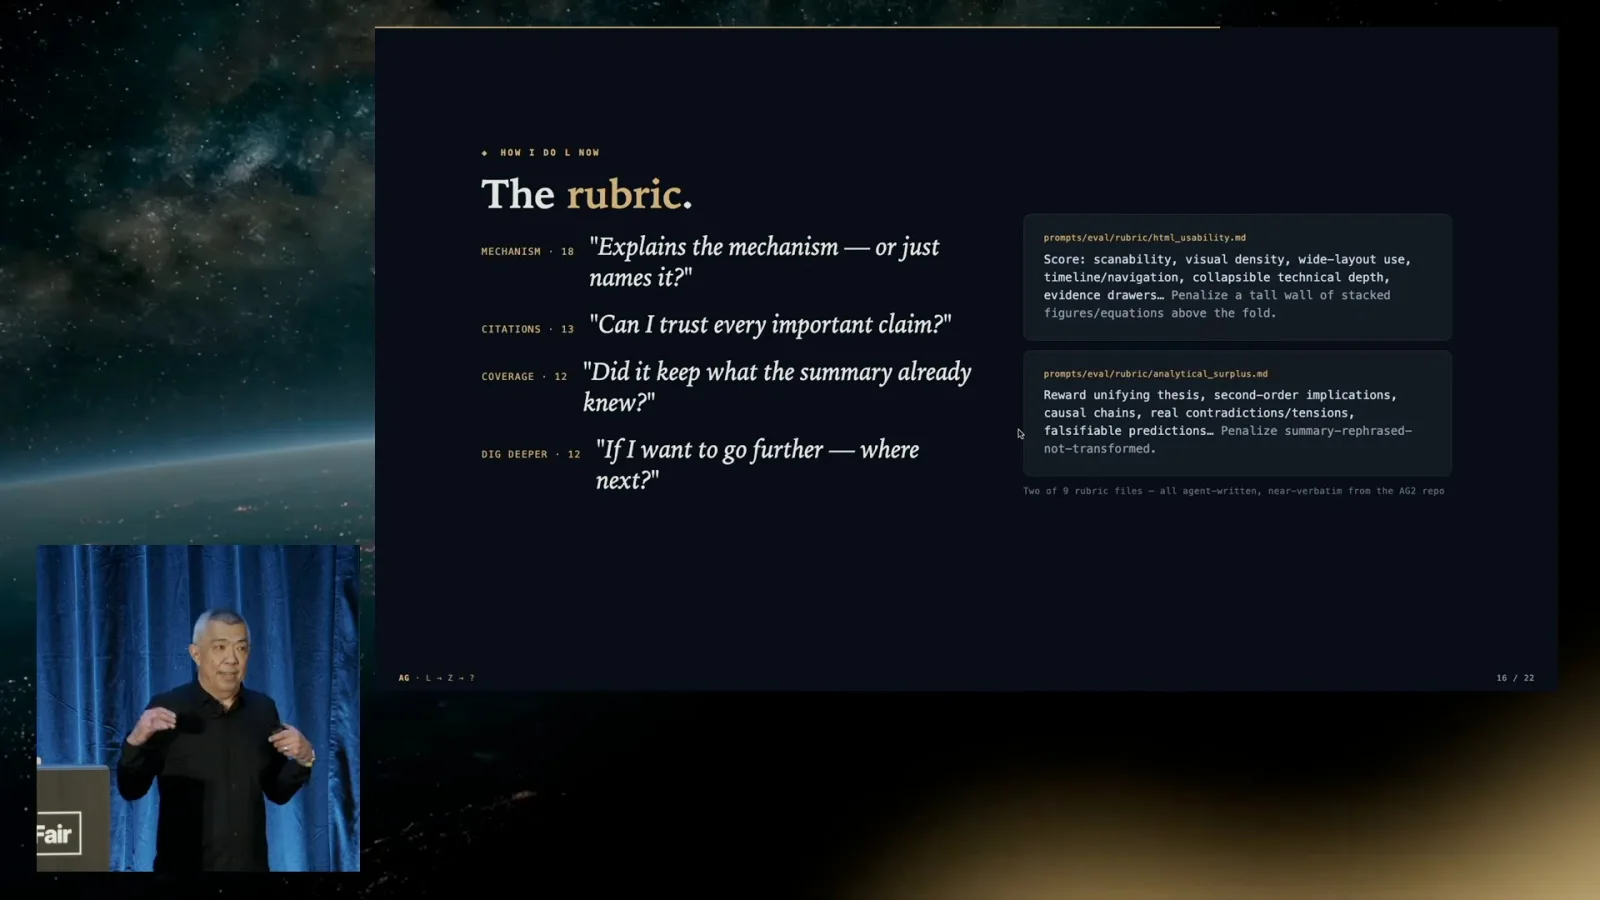
以前我给智能体一份规格,然后批准或拒绝它的计划。现在我还会设定描述期望结果的评分标准。对于视频画布,这包括解释清楚、保持简洁,以及链接到正确的视频时间点。
我先深入处理一段讲座,随后发现这一方法也适用于幻灯片、编程演示和终端录屏。评分标准由智能体在我的指导下编写;我不断调整标准,让智能体根据标准反复改进输出。
最初,所有公式都堆在开头,后面跟着一大段文字。我希望每个公式都和解释放在一起,于是让智能体修改评分标准。我检查结果、调整标准,再让智能体继续改进。
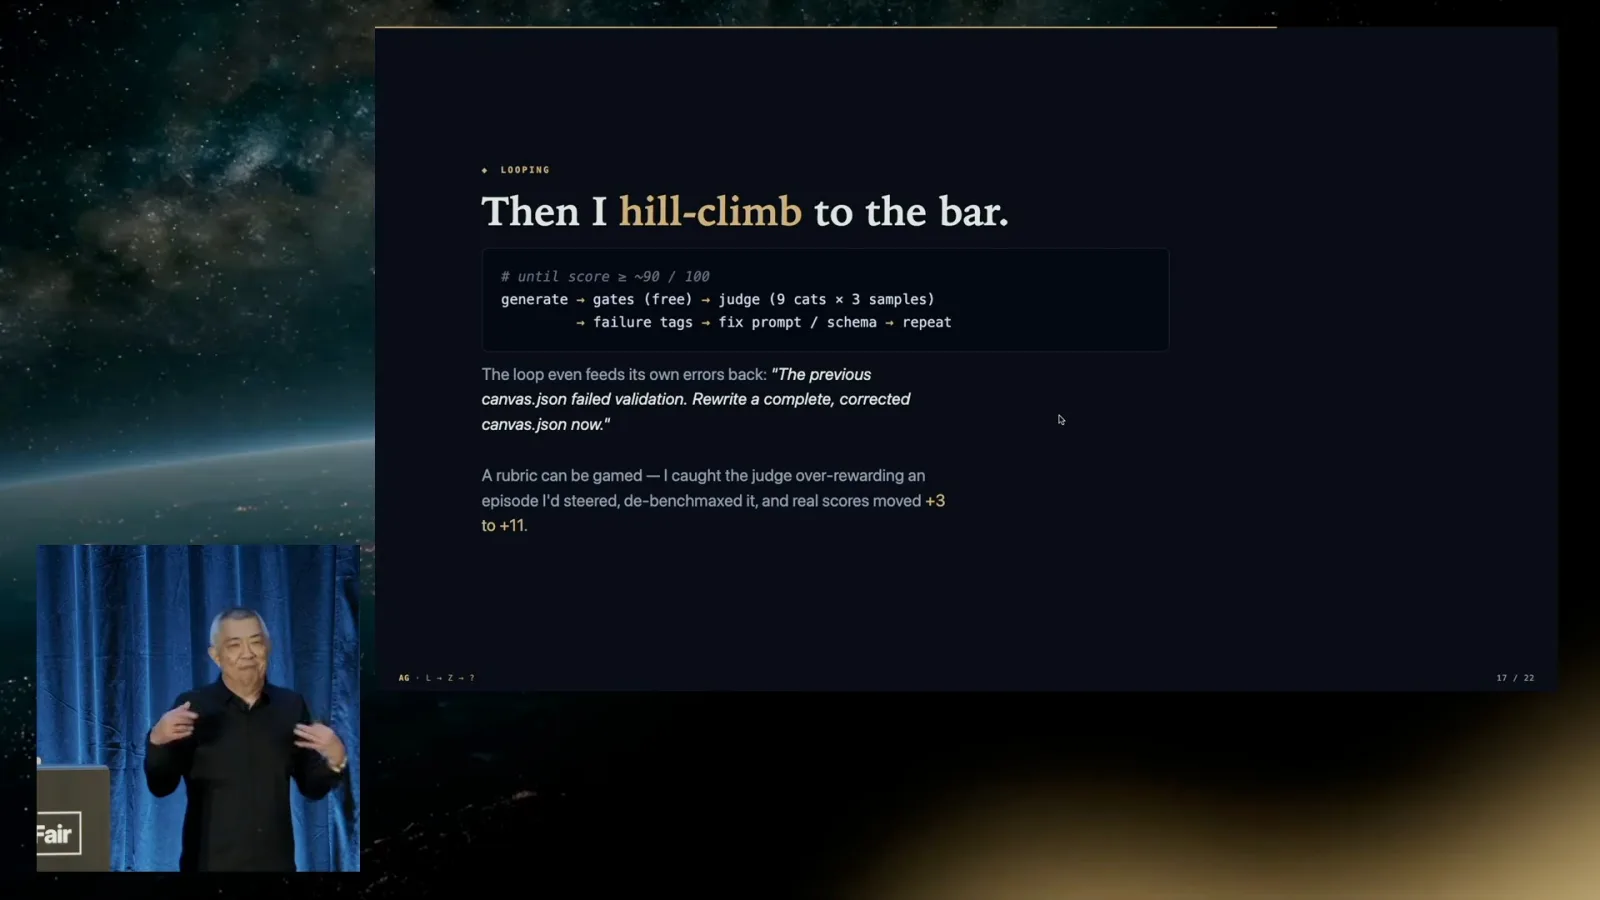
我发现智能体写的一项评分标准为了在那一段讲座上得高分而过度适配,在另外五段视频上表现不佳。我让智能体不要只针对单个例子优化,修改后的标准泛化得更好,整组视频的分数也提高了。
审查循环与人的目标控制
智能体依照标准优化结果并互相审查。Kanazawa 继续掌握目标,将大部分代码实现交给智能体。
这里有多层循环:智能体帮助编写评分标准,根据标准优化输出,我再根据看到的结果修改标准。我还让 Claude 和 Codex 进行多轮对抗式代码审查,互相找问题并提出修复。
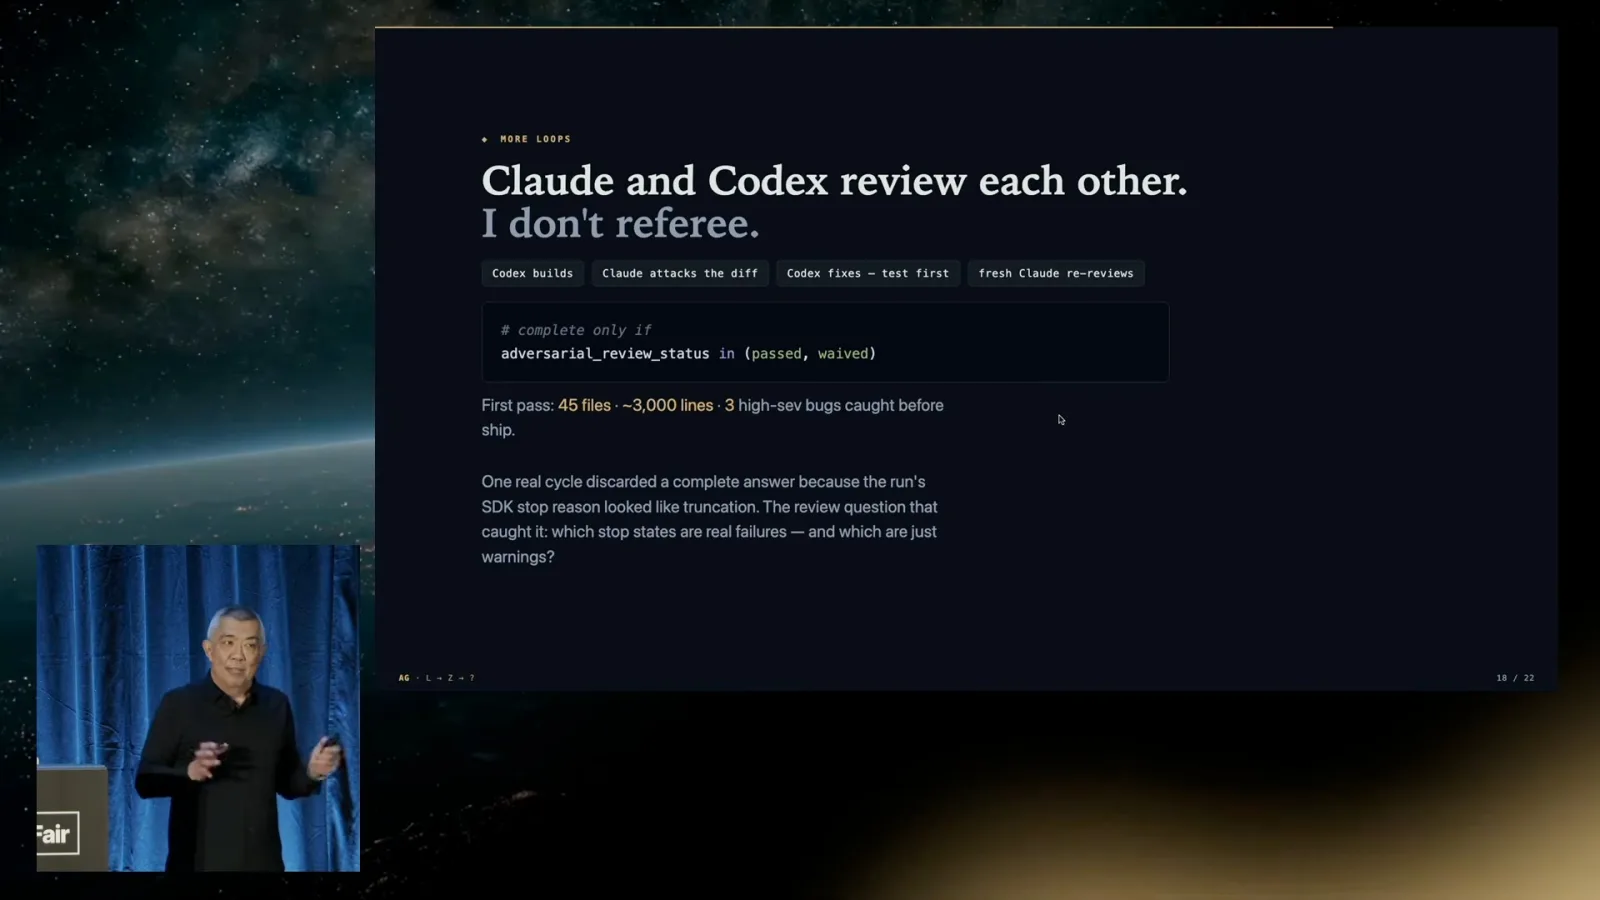
我仍然倾向于委托实现。我掌握目标,告诉智能体想要的结果和工作方式,但仍不会阅读大多数代码。对我而言,这种使用 token 的方式让产品经理也能构建自己想了多年的体验。
同频道的其他文章
 19:41EN → 简体中文
 AI Engineer· 2026年11月9日高可靠自动化的第一步:把难处理的案例分流出去Matthew Jewkes · Standard CyberneticsMatthew Jewkes 介绍如何在生物医药文档索引流程中区分关键错误、模糊判断和异常情况。
 22:01EN → 简体中文AI Engineer· 2026年11月9日Zach Lloyd:让软件工厂可以衡量和修改Zach Lloyd · WarpWarp CEO 建议记录智能体运行、评估失败原因,并用真实任务测试工作流的改动。
 27:35EN → 简体中文AI Engineer· 2026年11月9日Uber 为加快 AI 时代的代码合并,放弃主干始终通过测试Preetam Dwivedi, Manjari Akella · Uber合并队列放宽部分冲突限制,合并后再验证组合状态,并保留已验证的可用版本。
 15:25EN → 简体中文AI Engineer· 2026年11月9日Hassan 与 Omar El Mghari:AI 财务预测为何会“结果对了,理由错了”Hassan El Mghari, Omar El Mghari · Together AI一个 Costco 会员费模型通过了基础检查,结果也接近实际数据,但审计发现了相互抵消的错误假设。
 14:38EN → 简体中文AI Engineer· 2026年11月9日Jemima Abu:从一开始就给编程代理无障碍规则Jemima Abu · CAIS一位产品工程师介绍如何利用语义化 HTML、可复用组件和明确的代理技能,帮助团队构建更易用的界面。
 21:12EN → 简体中文AI Engineer· 2026年11月9日Tom Moor:给编程代理补上代码看不到的产品背景Tom Moor · LinearLinear 的工作流将客户请求、历史决策、审查记录和人工反馈贯穿于接收、实现与审查。