30 秒看懂
AI Explained 回顾 2025 年 12 月 GPT-5.2 的发布,在介绍强劲结果的同时追问基准比较到底衡量了什么。讲解者报告自己的测试,并强调计算预算、任务选择和真实环境的重要性。
- 1GDPval 衡量什么在明确任务上的强劲表现不等于掌握完整职业。
- 2推理有预算解读模型分数时应结合成本与测试时计算量。
- 3SimpleBench 结果讲解者报告自己的历史测试结果和粗略人类基线。
- 4长上下文检索四针结果衡量特定检索任务,而非所有长文档推理。
要点建议
- GDPval 覆盖明确的数字化任务,而不是完整职业。
- 推理预算与成本会改变基准比较。
- 不同评测可能对同一组模型给出不同排名。
- SimpleBench 与长上下文分数是特定时间、特定测试的结果。
- 讲解者用数羊比喻讨论渐进式进步。
按章节阅读整理后的全文
GDPval 与专业工作
讲解者解释基准范围并测试表格任务。
在这期 2025 年 12 月的评测中,我不只看 GPT-5.2 的标题分数。它在多项测试中表现强劲,但比较模型时,还要考虑为回答投入了多少推理算力。这里讨论的结果和价格均以视频录制时为准。
OpenAI 报告称,GPT-5.2 Thinking 在 GDPval 的 70.9% 比较中胜过或持平专业人士。这个结果针对 44 种职业中明确规定的知识工作任务,不能据此认定模型能够取代专家完成整份工作。
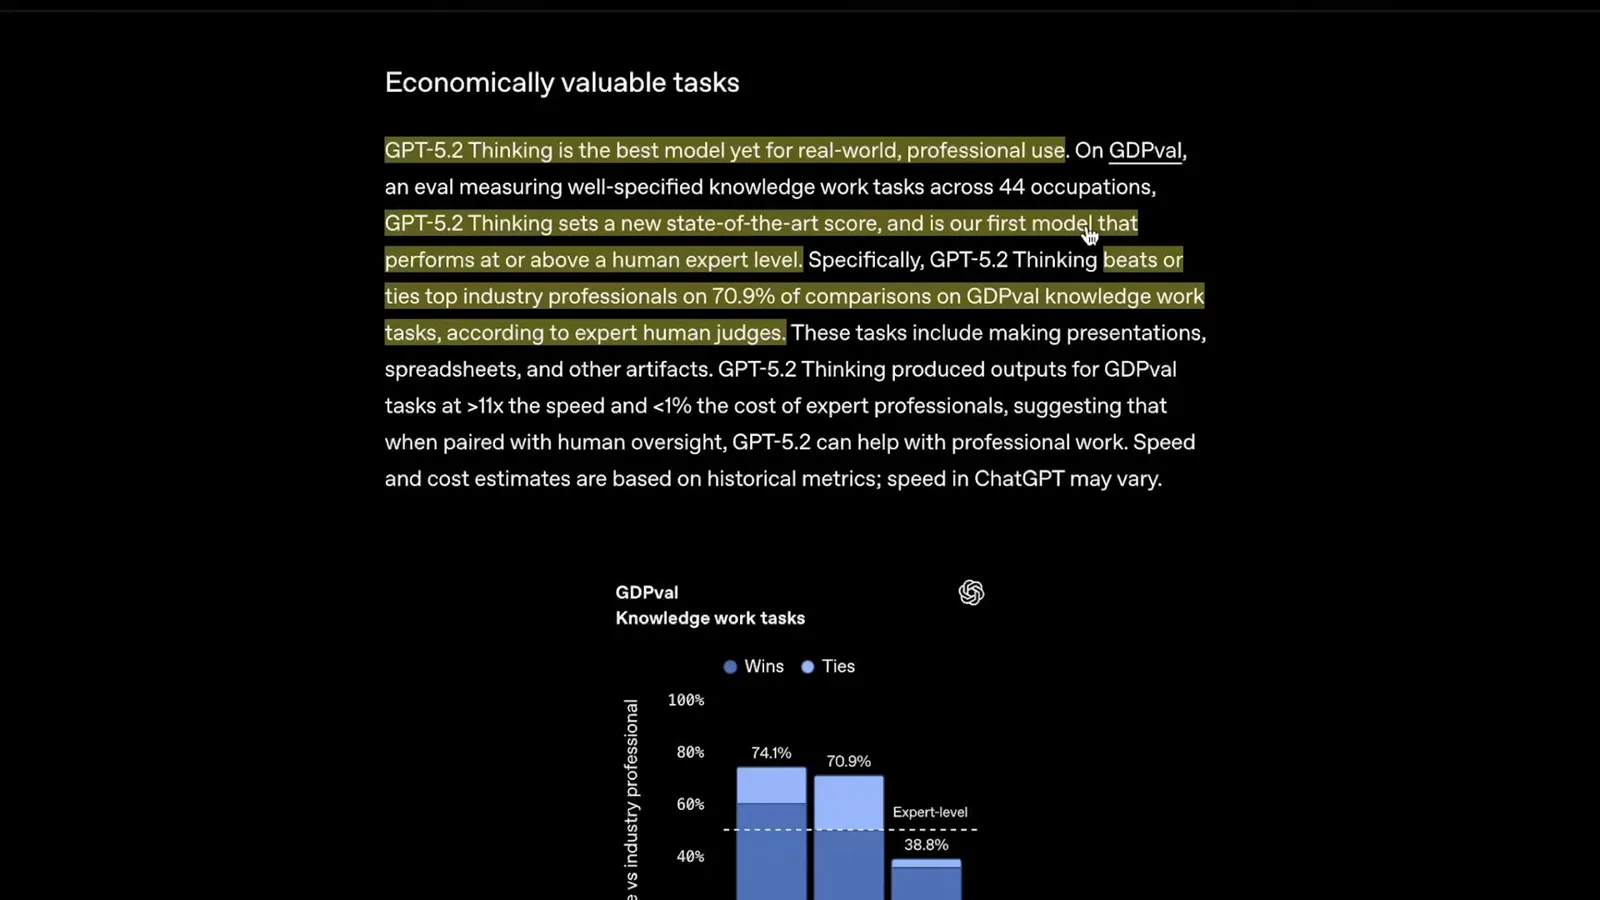
基准主要选择数字化任务,并向模型提供必要上下文。真实工作往往需要寻找缺失信息和运用隐性知识;评估也没有直接体现灾难性错误的后果。
我测试了一项足球表格任务:收集某支球队的比赛结果,整理成交互矩阵。Pro 模型的结果令人印象深刻,我也抽查了部分比分;在我的测试中,预算较低的版本找到了结果,却没有完成矩阵。
我注意到发布材料的比较没有包含一些同期竞争模型。Google 一位代表分享了 Gemini 3 Pro 对同一主板图像更精细的分割示例,但单个例子不能构成全面比较。
思考预算与基准选择
成本、运行框架和任务选择使比较更复杂。
测试时计算量使排行榜更难比较。模型可以花更多 token 或资金思考问题,并经常因此提高成绩。理想的比较应展示性能与成本或预算的关系,而不是脱离这些背景只给出一个分数。
ARC-AGI 测试要求模型根据例子推断变换规律。我介绍 GPT-5.2 的强劲成绩,以及 ARC-AGI-1 上相较一年前的大幅效率改善。画面中的 ARC-AGI-2 图表也显示分数随成本变化;不同的运行框架同样可能改变结果。
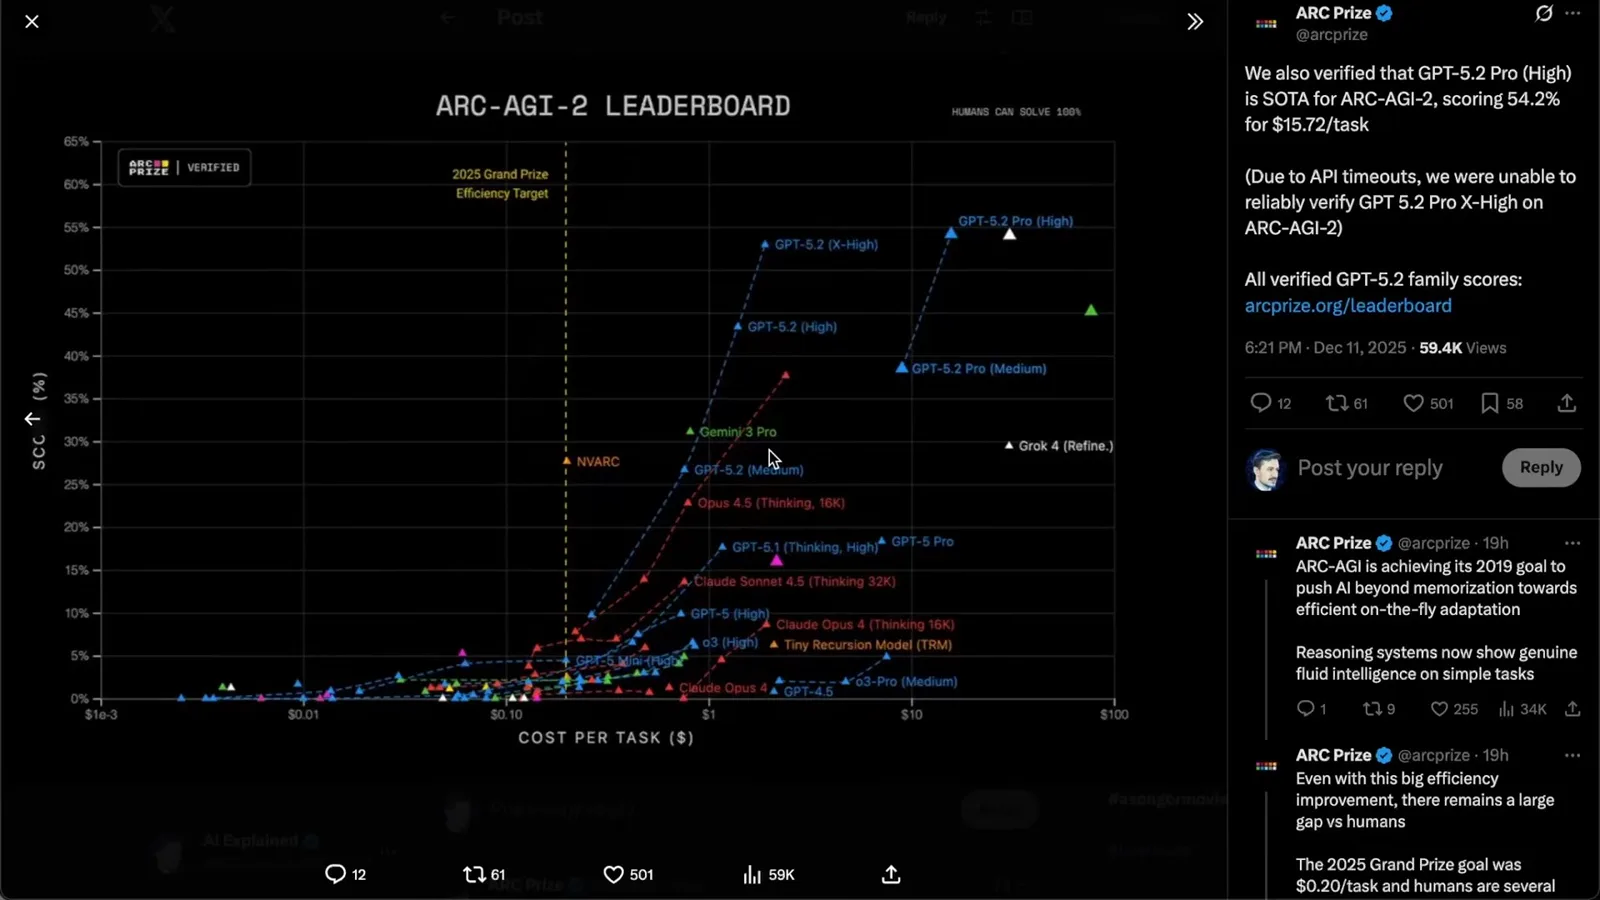
基准选择也是不确定性的来源。SWE-bench Pro 覆盖多种编程语言,并试图减少数据污染;其他代码评测的范围不同。更多推理 token 可能提高分数,但模型每个 token 的效率也可能提高。
两项图表视觉评测即便看起来都在测试图表理解,也可能得出不同的模型排名。因此,在宣布某个模型全面更好之前,应先检查题目和测量条件。
科学问题与 SimpleBench
讲解者讨论基准可靠性和自己的测试结果。
在 Humanity’s Last Exam 和 GPQA Diamond 上,我比较了公布的成绩,也指出基准污染和答案错误的可能性。公开分数是关于特定测试的有用证据,并不能完整衡量科学推理能力。
我还运行了自己的 SimpleBench,这是一组私有的常识及时空推理问题。在我的测试中,GPT-5.2 Pro 得分 57.4%,Gemini 3 Pro 得分 76.4%;我粗略估计的人类基线约为 84%。这些是该基准当时的结果,并非普遍排名。
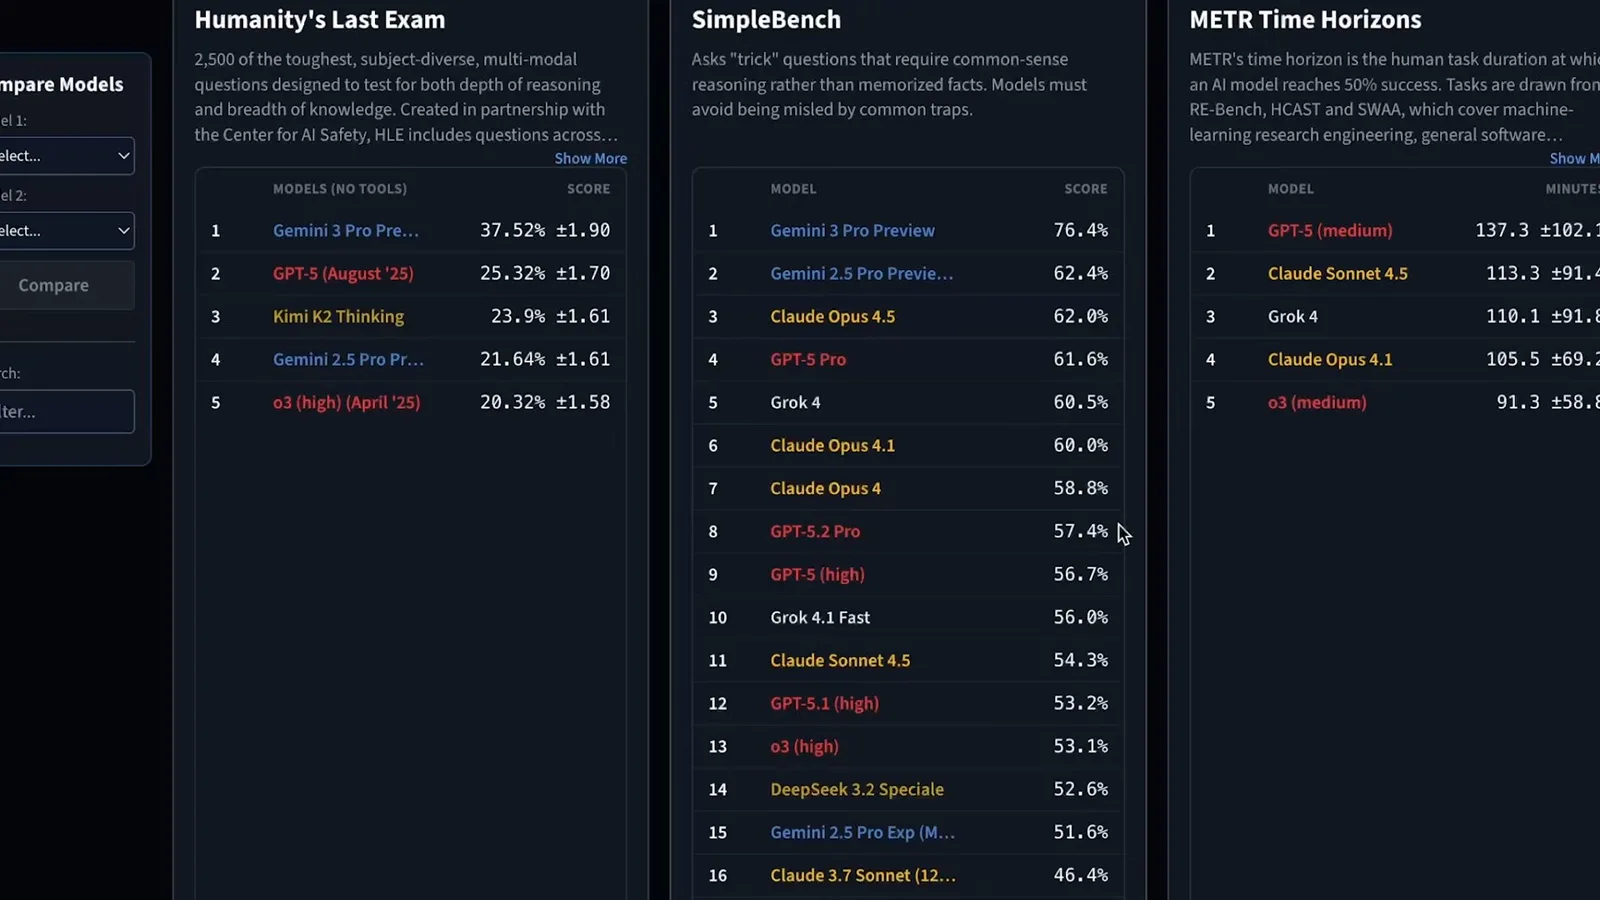
答案由程序与私有答案表比较。我观察到,基础版 GPT-5.2 在我的测试中低于一些早期 GPT 成绩。但基准构造和测试条件的差异仍然重要,我没有证据证明某家厂商不当针对公开测试进行优化。
在视频录制时,我实际更喜欢用 Claude Opus 4.5 编程。我建议根据具体任务选择模型,并演示自己运营的模型比较服务。视频中的产品和价格信息属于历史信息,不应假定今天仍然有效。
长上下文与 AI 研究
视频讨论检索和工程评测。
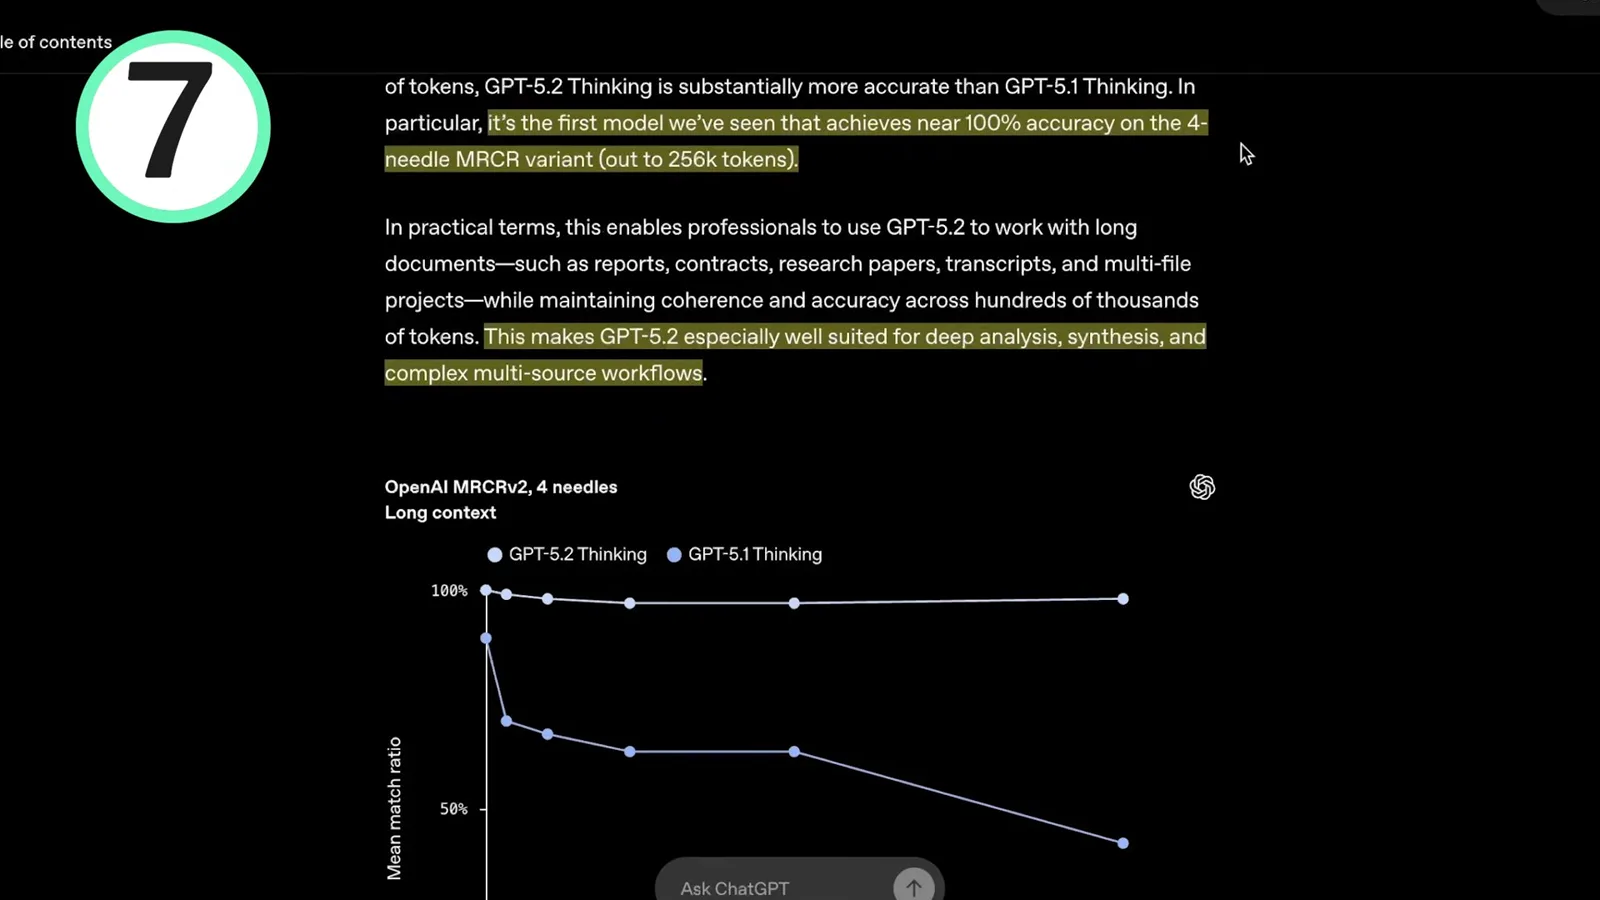
OpenAI 报告称模型在四针长上下文检索测试中表现出色。视频图表所述的是该特定测试在 25.6 万 token 范围内接近满分;找回预先插入的细节,不等于能可靠推理所有长文档。
模型在 OpenAI 自己的拉取请求评测中有小幅提升,而另一项机器学习工程基准与早期模型的比较结果并不一致。我把这些视为进步,而非奇点即将到来的证据。
我将这次发布放在 OpenAI 十周年及其领导者愿景的背景下讨论。关于未来超级智能的说法属于预测。我还提到发布时的 API 价格和心理健康评估,这些并不是当前产品建议。
数羊的比喻
将渐进式任务进步与突然突破作比较。
为解释渐进式进步,我想象在许多田野里数羊:每只羊代表一项人类任务。一种方法是一只只数,类似模型逐步改善各项任务;另一种则是突然取得突破,一次数完所有田野。
我推测,即使没有一次戏剧性的突破,反复改进最终也可能覆盖更多任务,包括实体世界的任务。这个比喻是一种思考进步的方式,并不能证明所有人类任务都可以或必将被自动化。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。