30초 요약
讲者延续多模态论文系列,讲解 BLIP 的编码器—解码器与数据自举、CoCa 的对比和字幕生成目标,以及 BEiT-3 的多模态掩码建模。结尾回顾相关模型脉络,并展望语言接口与通才模型;论文结果按视频录制时的背景理解。
- 1数据自举BLIP 生成候选图像描述并过滤不匹配的图文对,再用处理后的数据训练模型。
- 2共享与任务路径BLIP 通过共享参数,在文本编码、图像条件编码和解码之间切换。
- 3CoCa 的两个目标CoCa 将图文对比与字幕生成结合,并关注训练效率和规模扩展。
- 4BEiT-3 的统一思路BEiT-3 将图像视作语言式输入,通过 Multiway Transformer 与掩码建模学习多模态表示。
- 5走向更通用的模型语言接口用提示指定任务,通才模型尝试减少下游任务的专用结构。
핵심 정리
- BLIP 用参数共享结合图文理解和生成,并通过 Captioner 与 Filter 改善训练数据。
- 数据自举可以独立于最终使用数据的模型,生成描述仍需筛选。
- CoCa 将对比和字幕生成目标组合,强调减少重复前向计算。
- BEiT-3 使用 Multiway Transformer 与掩码建模处理多种模态。
- 比较模型效果时需要同时看训练数据、计算规模和复现条件。
- 语言接口和通才模型探索以更少任务专用结构覆盖更多任务。
챕터별로 다듬은 전문 읽기
BLIP 的问题与动机
讲者介绍统一图文理解与生成的模型目标,以及清理网页噪声数据的动机。
本期继续多模态论文串讲,聚焦 Transformer 编码器与解码器。首先介绍 BLIP 的两个主题:用自举方法改善数据,以及在一个灵活框架中同时处理图文理解和生成。
BLIP 的作者来自 Salesforce Research,与 ALBEF 团队相同。论文从模型和数据两个角度提出问题:现有架构各有所长,但难以直接覆盖所有任务;网页图文对则含有大量噪声。
CLIP、ALBEF 等编码器模型适合图文理解和检索,但没有解码器时,生成文字并不直接。编码器—解码器模型可以生成文本,却不一定直接适合图文检索。BLIP 希望把这些能力放到统一框架里。
数据方面,扩大网页图文数据集可以改善效果,但并不能消除文本与图片不匹配的问题。BLIP 用 Captioner 为图片生成描述,再用 Filter 筛除不匹配的图文对,希望提高训练数据质量。
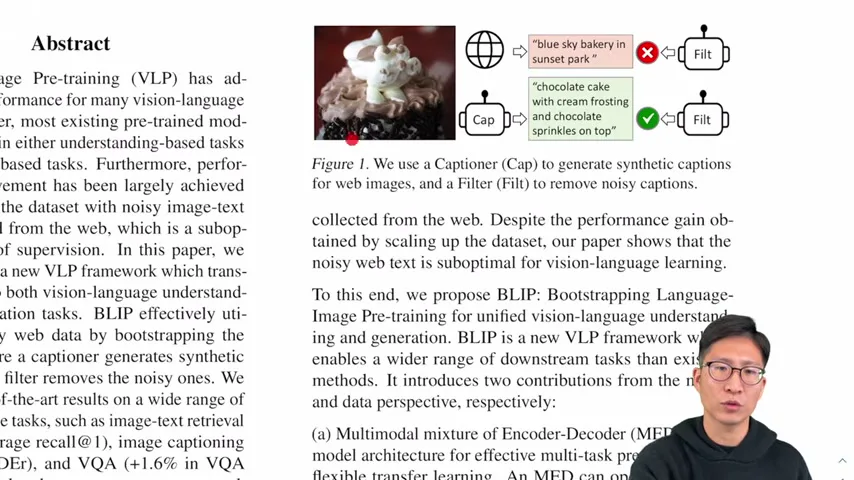
讲者举例说,一张蛋糕图片的网页文字可能介绍店铺位置,而非描述蛋糕本身。这种文字有搜索和商业价值,却未必适合训练视觉语言模型;生成描述可以提供另一种候选文本。
从 ALBEF、VLMo 到 BLIP
对照编码器、跨注意力与参数共享,解释 BLIP 的三种文本模式和训练目标。
回顾 ALBEF:视觉编码器和文本编码器先分别提取特征,用图文对比学习对齐;随后通过跨注意力融合图像和文本,再用图文匹配目标训练多模态表示。
ALBEF 将文本侧的层数分配给单模态编码和融合,以控制计算量。VLMo 则采用多模态专家混合结构:共享自注意力参数,根据输入模态选择不同的前馈网络,从而灵活复用模型。
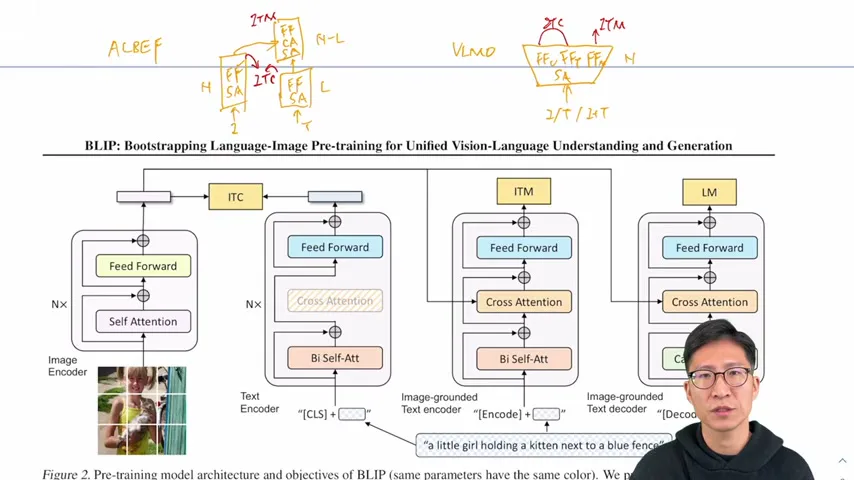
BLIP 综合这些思路:图像侧使用 Vision Transformer,文本侧提供文本编码、图像条件文本编码和图像条件文本解码三种模式。不同任务选择不同路径,但许多参数可以共享。
文本编码器和视觉编码器的特征用于图文对比损失;图像条件文本编码器通过跨注意力融合视觉特征,再用于图文匹配。讲者将前两部分与 ALBEF 对照,指出 BLIP 利用参数共享减少重复。
为了生成文字,BLIP 还加入文本解码模式。生成时不能看到未来词,因此使用因果自注意力;模型根据已有内容预测后续文本,而不是读取完整句子后再复述。
讲者解释,双向编码与因果解码的注意力需求不同,而跨注意力和前馈部分仍可以共享。语言建模目标预测后续词,与遮住句中词再恢复的掩码语言建模不同。
BLIP 的三种文本模式对应图文对比、图文匹配和语言建模三个目标。虽然共享参数提高灵活性,训练时文本侧仍需要多次前向计算,因此成本不能忽略。
论文还沿用 ALBEF 的技巧:用动量编码器辅助知识蒸馏,并利用对比相似度挑选困难负样本,帮助训练图文匹配。整个编码器与解码器组合被称为 MED。
CapFilt 与数据自举
讲解 Captioner、Filter 的训练过程,消融实验与数据生成的应用。
第二个贡献是 CapFilt 数据自举。网页抓取的图文配对可能不匹配,人工标注数据通常更干净。先用已有数据预训练 MED,再借助较干净的数据微调过滤器,评估图文是否匹配。
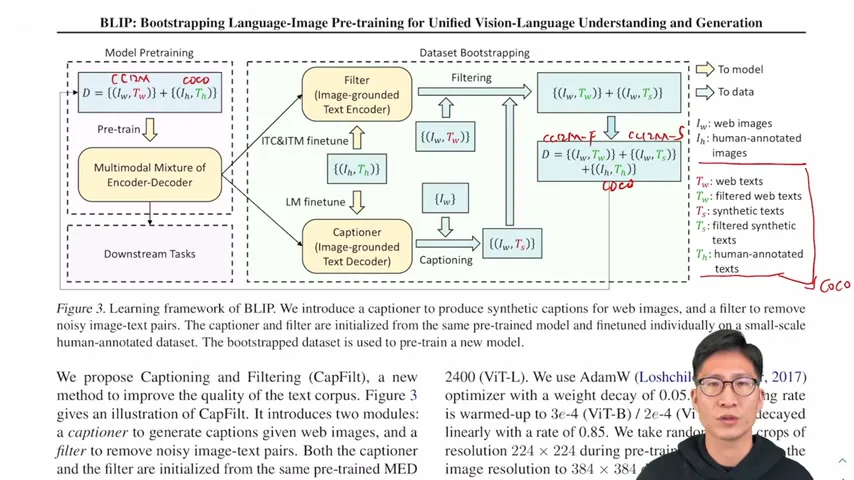
过滤器保留更匹配的原始网页文本;Captioner 则为同一张图片生成新的候选描述。生成文本有好有坏,因此也需要筛选。两种方式形成更丰富、经过清理的数据,再用于重新训练 BLIP。
论文的示例表明,生成描述有时能更准确地写出日落、湖面与飞鸟;另一些图片的原始文本可能比生成的泛泛描述更具体。过滤器的作用是在候选之间作选择,而不是假设合成文本总是更好。
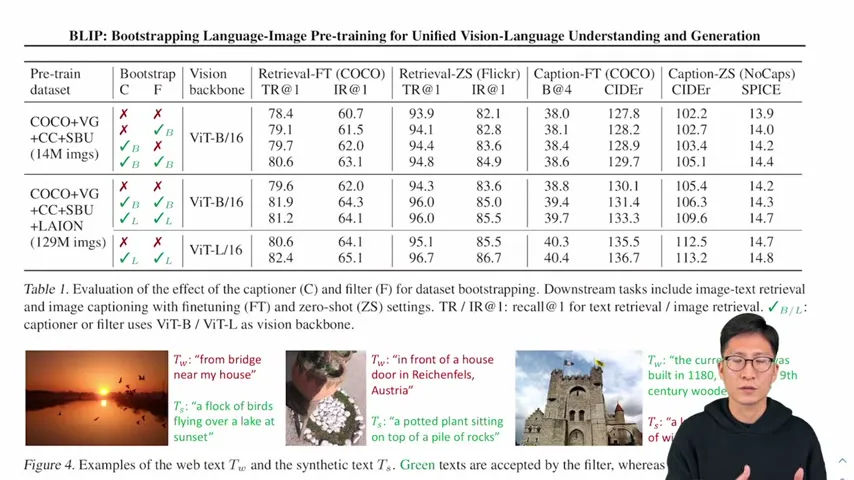
消融实验比较了模型大小、数据规模以及 Captioner 和 Filter 的作用。讲者指出,单独使用任一模块都有收益,结合两者效果最好;生成描述还增加了数据多样性。
自举是分阶段过程:先训练模型,再微调 Captioner 和 Filter、生成或清理数据,最后用新数据预训练。生成数据的模型可以比最终使用数据的模型更大,两者不必绑定。
因为数据生成是独立步骤,讲者认为 BLIP 生成的伪标签也可以供其他多模态模型使用。它的价值不只在某一种模型结构,还在于作为改善图文训练数据的工具。
一个例子是用宝可梦图片微调 Stable Diffusion:图片数据集容易获得,却缺少文本。研究者借助 BLIP 为图片生成描述,然后用图文对进行微调;讲者展示了绿色宝可梦的描述作为例子。
另一个例子是 LAION-COCO:从 LAION 的英语子集出发,用 BLIP 生成候选描述,再用 CLIP 模型排序筛选,形成约六亿条图文对。这个流程把生成与过滤组合起来改善数据。
讲者介绍其处理流程:每张图采样 40 条描述,先用一个视觉 Transformer 模型选出五条,再用另一模型重排,最后使用语言模型修正语法和标点。不同候选让排序有选择空间。
BLIP 的 Captioner 也可能用于缺少描述的视频、遥感或医疗数据,但讲者强调这些领域的效果还需要验证。更高质量的图文数据也为语言引导的检测和分割等研究提供了实验机会。
CoCa:对比学习与字幕生成
讲解 CoCa 的模型路径、效率设计和大规模实验。
接下来是 Google Research 的 CoCa,即 Contrastive Captioning。它使用对比损失和图像字幕生成损失,借助大模型与大规模数据,在多模态、图像分类和视频识别任务上展示强劲结果。
CoCa 左侧是图像编码器,右侧是文本解码器。文本分支先提取单模态特征,之后融合图像特征;前一部分与图像特征计算对比损失,融合后的特征用于字幕生成。
视觉特征通过注意力池化进入多模态解码器,再通过跨注意力与文本融合。可学习的池化方式可以针对不同任务提取特征;文本侧从一开始采用因果注意力。
CoCa 的一个重点是训练效率。多个目标如果需要分别前向计算,会增加训练时间;CoCa 让对比和生成目标利用同一次前向计算中的特征,从而更容易扩大训练规模。
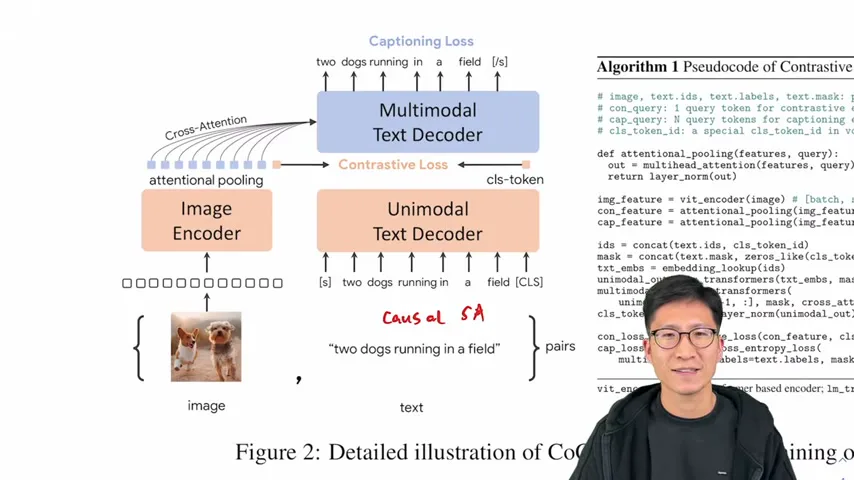
论文最大模型约有 21 亿参数,并使用包含大型私有图像数据集在内的数十亿训练样本。讲者指出,方法本身相对简单,但数据和算力规模使完整复现很困难。
论文用多边形图比较图像描述、视觉语言理解、ImageNet、视频和检索等任务。图中的各个顶点代表不同任务,CoCa 的结果展示了一个模型跨任务的广泛表现;这些比较应放在论文发表时的背景下理解。
讲者总结,ALBEF 式分支与 BLIP、VLMo 式参数共享都是可行思路。模型和数据扩大后,训练数据仍会显著影响结果,因此不能只比较结构而忽略数据条件。
BEiT-3:图像作为语言
介绍 Multiway Transformer、掩码建模及公开数据和任务表现。
BEiT-3 希望进一步统一模型、训练目标和规模扩展。论文将图像视为一种类似语言的输入,把图文对类比为平行句子,并使用掩码建模学习表示。
模型采用 Multiway Transformer:自注意力层共享,前馈网络按视觉、语言和视觉语言输入选择专家。讲者认为,这延续了 VLMo 的多模态专家结构。
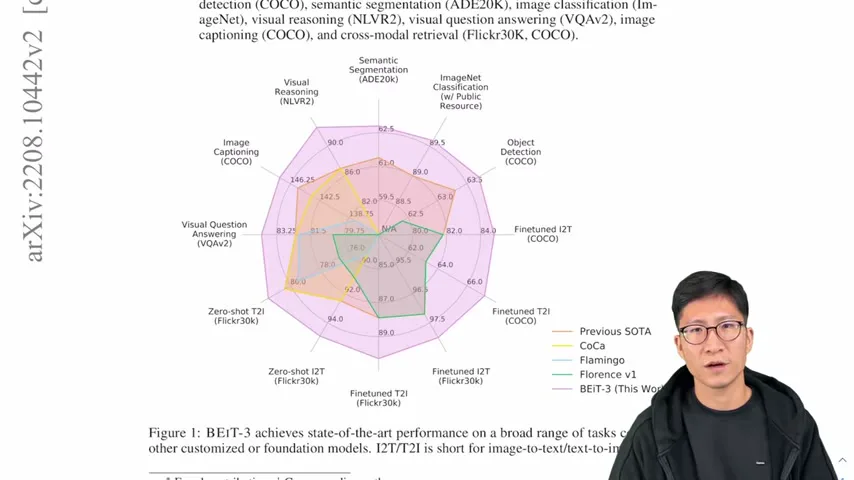
BEiT-3 报告了分类、检测、分割及多模态任务的结果。讲者比较其公开数据训练条件与 CoCa 使用额外私有数据的情况,强调复现时应看数据来源,而不只看排行榜数字。
讨论中提出两个谨慎的结论:更多目标函数不一定更好,需要考虑目标之间是否互补;更多数据也不保证效果更好,质量、模型规模和训练设置都重要。
论文引言将这一趋势称为 Big Convergence:在大量数据上预训练,学习可迁移的表示,并希望形成可服务多种任务和模态的基础模型。讲者把它视为多模态领域的重要方向。
讲者看好 Transformer 的原因之一,是它能较自然地应用到语言、图像和多模态输入。相比仅比较单一视觉任务上的模型分数,跨模态适用性更有利于构建统一框架。
现有双编码器适合快速检索,编码器—解码器适合生成,融合编码器适合理解。但不同下游任务常需调整输入、输出或结构,因此它们距离完全通用的模型仍有差距。
BEiT-3 选择掩码数据建模作为共同目标。减少目标函数可以降低多项损失的权重调节与优化负担,也有助于扩大训练;图像经过嵌入后成为 token 序列,便于与文本按类似方式处理。
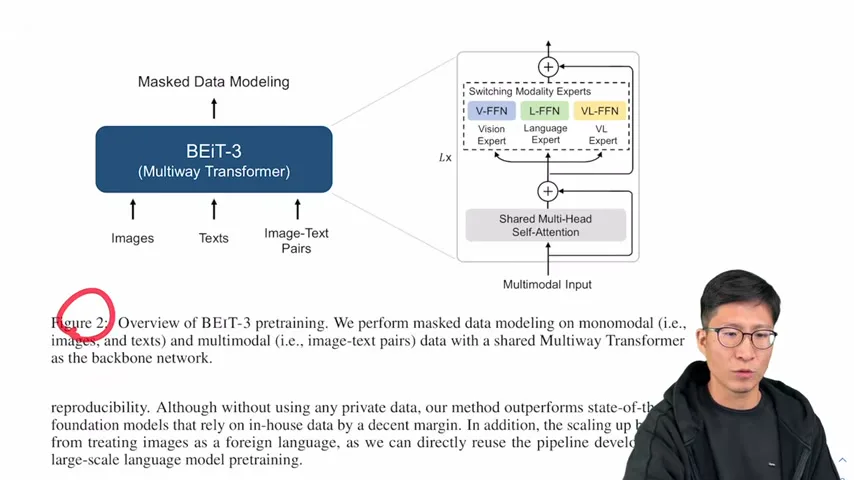
在预训练后,可以选择不同路径用于图像分类、检测、分割、语言任务或图文理解;分开的视觉和语言路径可以用于检索。讲者把这种灵活组合比作搭积木。
模型演进与通才模型
回顾视觉语言模型的关系,讨论 FLIP、语言接口和通才模型。
最后的回顾从 Vision Transformer 出发,梳理 ViLT、CLIP 和 ALBEF 的关系:简化视觉特征提取、提高检索效率,以及通过融合改善多模态表示,共同推动了后续工作。
在此基础上,CoCa 结合对比与字幕生成;VLMo 探索共享参数和专家网络;BLIP 引入灵活的编码器—解码器模式和数据自举。讲者将这些方法看作一系列相互借鉴的设计。
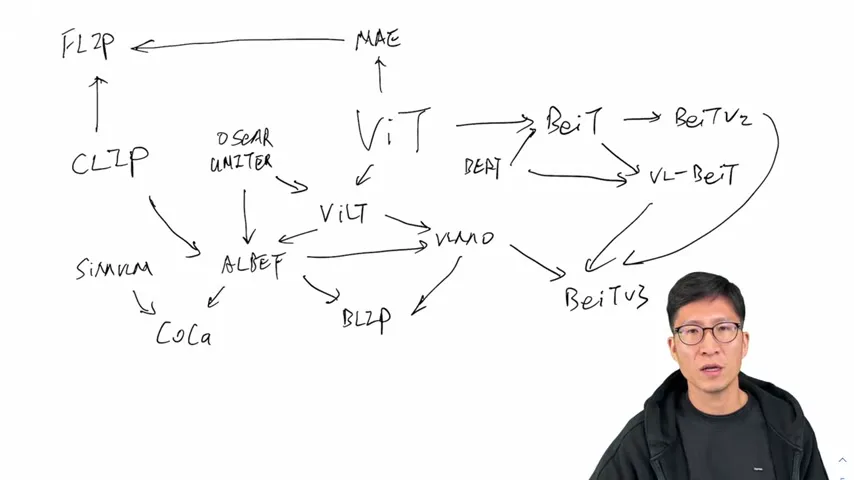
另一条路线是掩码建模:BEiT 和 MAE 分别探索恢复视觉 token 或像素,BEiT-3 把此前视觉、视觉语言与专家模型的经验组合起来。不同恢复目标和输入方式带来不同的计算与表示特性。
MAE 只把未遮挡的图像块送进视觉编码器,从而减少计算。讲者介绍 FLIP 将类似思想用于 CLIP:训练时移除遮挡的视觉 token,缩短序列并加快训练。
讲者进一步讨论语言接口:MetaLM、PaLI 等方法用文本提示指定任务,再用文本生成答案。这样图像分类和视觉问答等任务可以共享更相似的输入输出形式。
最后展望通才模型,例如 Unified-IO 和 Uni-Perceiver 系列:目标是尽量使用同一个模型处理下游任务,减少专门任务头和结构调整。讲者认为该方向值得关注,但当时的效果仍在发展中。
같은 채널의 다른 글
 23:39ZH
 跟李沐学AI· 2025년 7월 23일李沐:给文本大模型加入一千万小时语音,开源 Higgs Audio李沐 · Boson AI李沐介绍团队如何在文本大语言模型的训练里加入大量语音数据,做成能听能说的 AudioLLM,并把 Higgs Audio 开源。他讲了架构取舍、token 压缩、数据从哪来,以及怎么在 3090 上跑起来。
 1:07:10ZH跟李沐学AI· 2022년 12월 29일InstructGPT 论文精读:从人工反馈到语言模型对齐从监督微调、奖励模型到 PPO,梳理 InstructGPT 的训练流程、实验结果与局限。
 55:47ZH跟李沐学AI· 2022년 12월 19일Neural Corpus Indexer 论文精读:用生成模型检索文档从倒排索引、双塔检索到 NCI 的语义文档 ID,同时讨论数据泄露更正与部署瓶颈。