In 30 Sekunden
讲者以 2022 年底的 ChatGPT 为背景,精读 InstructGPT 论文:先用人工示范监督微调,再用回答排序训练奖励模型,最后通过 PPO 优化语言模型。他也讨论数据标注、偏好评估、安全风险,以及更多监督数据能否替代部分强化学习步骤。
- 1三阶段训练人工示范训练 SFT,排序训练奖励模型,PPO 再根据奖励优化语言模型。
- 2小模型与人类偏好论文报告 1.3B InstructGPT 在其人类偏好评估中优于 175B GPT-3;比较依赖具体评估。
- 3标注质量论文招募约 40 名标注人员,并通过筛选和持续沟通处理开放式任务。
- 4限制奖励优化偏移KL 惩罚约束策略偏离 SFT 模型,降低奖励模型面对分布外回答的风险。
- 5开放问题讲者质疑增加监督数据是否能替代部分强化学习复杂性,但这需要实验验证。
Das Wichtigste
- 预训练的下一个词预测目标与帮助、真实和无害的用户需求并不完全相同。
- InstructGPT 依次使用人工示范、偏好排序和强化学习训练模型。
- 奖励模型是对标注偏好的代理,KL 惩罚用于限制策略偏移。
- 论文的人类偏好结果针对特定数据和任务,不能推广成所有能力上的优势。
- 标注者组成、语言覆盖和剩余错误限制了对齐结果的代表性。
- 讲者提出更多监督示范可能替代部分强化学习步骤,这是需要验证的假设。
Den bearbeiteten Text nach Kapiteln lesen
ChatGPT 的背景
讲者介绍当时的应用示例及公开信息,说明为何回看 InstructGPT。
讲者从 2022 年底 ChatGPT 引发的关注说起,介绍它在写邮件、文档和多轮对话中的潜力。本期选择阅读 InstructGPT 论文,因为当时公开的 ChatGPT 介绍称其训练方法与 InstructGPT 类似。
官方示例展示了模型追问代码问题、拒绝违法请求、围绕数学问题持续对话,以及解释自己无法完成某些现实世界操作。讲者将这些例子用于说明对话能力和安全行为,而非保证模型总能正确表现。
一个数学对话示例展示,模型可以根据前文继续解释问题、生成诗歌并总结对话。讲者提醒,公开演示体现的是当时示例中的表现。
讲者认为,多轮对话比单次提示更符合人的交互习惯,也可能催生大量应用。随后他指出,讨论时 ChatGPT 的详细论文尚未发布,因此应区分公开信息与对底层训练细节的推测。
公开介绍称 ChatGPT 使用与 InstructGPT 相似的方法,但对话数据的收集形式有所不同。讲者对 GPT-3.5 的数据组成提出推测;他没有把这些猜测当成论文已证实的细节。
InstructGPT 的问题是:仅靠预测下一个词训练的语言模型,其行为取决于预训练文本,未必能遵循用户意图,也可能输出错误或不安全内容。论文通过人工示范与反馈让模型更贴近所需行为。
讲者指出,给模型增加人工标注并非新鲜事,但能够在特定需求上提供更直接的训练信号。实际系统需要权衡标注成本、算力和原始数据的覆盖,而不是假定扩大无监督数据可以解决一切问题。
对齐问题与安全风险
讨论用户意图、错误输出和模型部署中的风险。
论文称,模型变大不一定更能遵循指令:它仍可能产生虚假、有毒或无帮助的回答。所谓 alignment,是让模型的行为更接近用户意图;讲者强调,部署时安全与有效性和基准分数同样重要。
他回顾了图像标注、聊天机器人和学术语言模型曾出现的有害或错误输出,以及产品因此下线或调整的例子。生成模型输出形式更灵活,应用范围更广,也更难穷举所有失败场景。
他提到当时科学语言模型生成了看似可信但错误或有偏见的内容,批评者担心读者会误信。这个例子说明,流畅表达与可靠性是不同的性质。
讲者还展示角色扮演式提示绕过拒答的例子,提醒听众:即便模型经过安全训练,也不应把拒答行为视为可靠的安全保证。安全限制需要持续测试,而不是依靠单个演示判断。
InstructGPT 三阶段流程
概览示范微调、偏好排序、奖励模型和强化学习。
InstructGPT 首先收集提示与人工撰写的示范答案,监督微调 GPT-3;然后让标注人员对模型的多个答案排序,训练奖励模型;最后通过强化学习调整模型,使其回答更符合学到的偏好。
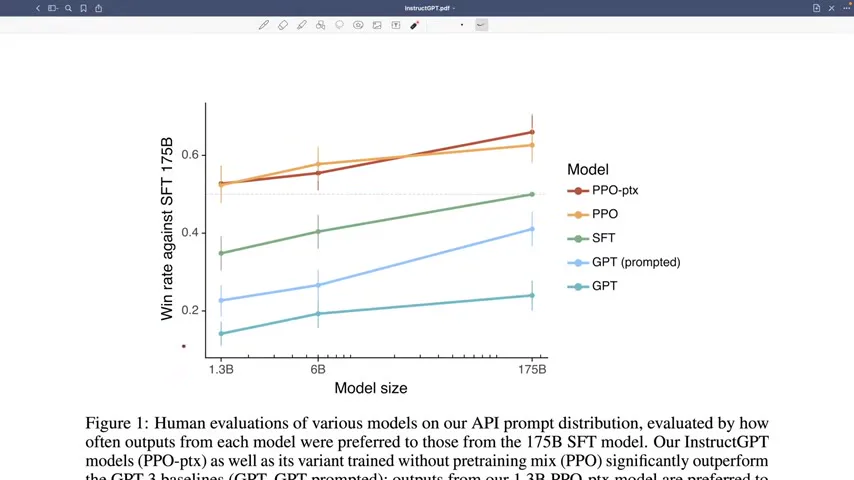
论文报告,在所用的人类偏好评估中,13 亿参数的 InstructGPT 回答优于 1750 亿参数的 GPT-3。讲者提醒,这个比较针对论文的特定任务和评估数据,并不意味着小模型在所有任务上都更强。
论文还报告真实性和有毒输出方面的改善,以及公开 NLP 任务上没有明显全面退化,但模型仍会犯简单错误。讲者认为,匹配任务的数据能提高训练信号效率,同时也要注意标注代价。
论文将目标描述为 helpful、honest 和 harmless:帮助用户完成任务,尽量真实,并避免造成伤害。预训练的下一个词预测目标与这些要求并不完全相同,这就是作者希望缩小的差距。
讲者指出,基于人工反馈的强化学习借鉴了之前的研究。InstructGPT 的贡献之一是在更广泛的指令任务与数据上应用这条训练路线。
第一步是监督微调(SFT):收集提示和人工写出的答案,把它们组成训练样本,对 GPT-3 继续训练。对语言模型而言,训练方式仍是预测序列中的词,只是数据更贴近目标任务。
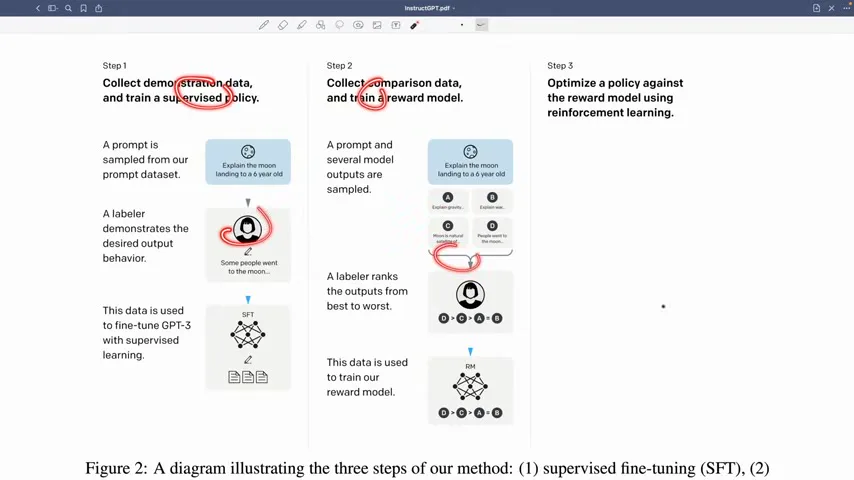
第二步针对同一个提示生成多个答案,让标注人员排序。奖励模型接收提示和回答并输出一个分数,训练目标是让较受偏好的回答得到较高分,而不是要求人直接给出绝对分数。
第三步从 SFT 模型出发,用奖励模型评价生成的回答,再优化语言模型。讲者解释,排序通常比从头撰写大量完整答案更便宜,因此在标注预算内可以获得更多偏好信息。
这一流程中的技术问题包括如何收集示范和排序数据、如何从排序训练奖励模型,以及如何用奖励模型进一步训练策略。讲解随后分别展开这些步骤。
论文的人类评估认为 InstructGPT 的回答更受欢迎,也报告了真实性和减少有毒输出方面的变化;但偏见指标并未明显改善。讲者强调,改进某些指标不等于模型已经安全或无偏。
针对专门目标微调可能损害其他任务。论文在强化学习中加入原始预训练目标,以减轻公开 NLP 任务上的性能下降;此外还用未参与训练的标注人员进行评估,检查偏好是否能跨标注者延续。
作者还比较了其他公开指令数据集,并观察到训练数据分布与目标用户任务的匹配很重要。讲者举出代码相关任务,说明少量训练示例之外仍可能出现一定泛化,但不能据此断言所有任务都可靠。
讲者区分令人惊喜的演示和可靠的工具:后者不仅需要偶尔做得好,还要在常见场景中稳定可用。InstructGPT 和当时的 ChatGPT 仍会犯简单错误,结果需要结合具体用途评价。
数据收集与标注
讲解提示来源、按用户划分数据以及标注人员的工作。
论文的数据来自人工编写的提示,也来自用户在产品中提交、经过筛选的提示。讲者将其描述为迭代过程:先用初始数据训练模型,再从真实使用中了解任务分布并改进数据集。
人工编写的提示既可以是自由提出的问题,也可以围绕特定应用场景设计。初始模型部署供用户试用后,新的用户提示又能补充任务分布的信息。
训练、验证和测试按用户划分,而不是把同一用户的相似问题随机分到不同集合,以减少相似提示造成的评估污染。论文也描述了对含个人信息提示的过滤。
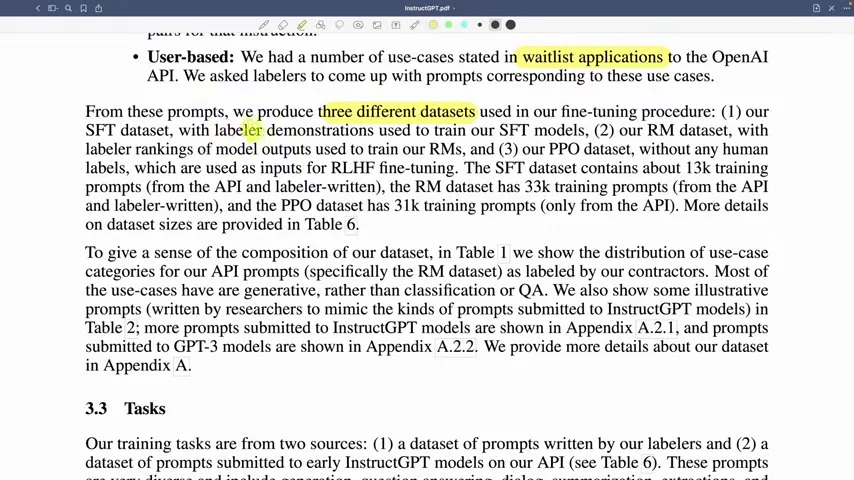
论文列出三类数据:约 1.3 万条示范用于 SFT,约 3.3 万条提示的比较用于奖励模型,约 3.1 万条提示用于 PPO 阶段。提示覆盖生成、开放问答、改写、摘要、分类等任务。
示例提示包括头脑风暴、讲故事、提取表格内容、判断讽刺语气和翻译。任务形式的多样性解释了为什么只靠少数固定模板不足以覆盖真实使用。
作者通过承包平台招募约 40 名标注人员,并介绍筛选和合作方式。讲者说,开放式回答的判断有歧义,标注质量依赖筛选、明确说明和持续沟通,而不是只增加人数。
讲者注意到标注与评估的侧重点并非完全相同:训练指导强调帮助性,评估也重视真实性和无害性。论文报告标注者间约 72% 的一致程度,但一致性并不消除主观性。
论文附录描述了标注流程与界面。讲者建议有类似需求的团队参考已有流程:构建标注系统不只是招聘人员,还包括设计任务、反馈和质量控制。
奖励模型与排序损失
讲解奖励模型的标量分数、成对损失与排序数据的复用。
SFT 在小规模示范集上多轮训练,用来初始化后续模型。奖励模型则把语言模型的输出转换成单个分数;论文采用约 60 亿参数的奖励模型,讲者提到稳定性和计算成本是规模选择的考虑因素。
奖励模型用成对排序损失训练:对同一提示,比较更受偏好的回答与较不受偏好的回答,推动两者分数保持正确顺序。损失通过 sigmoid 和对数函数表达,依据的是相对偏好。
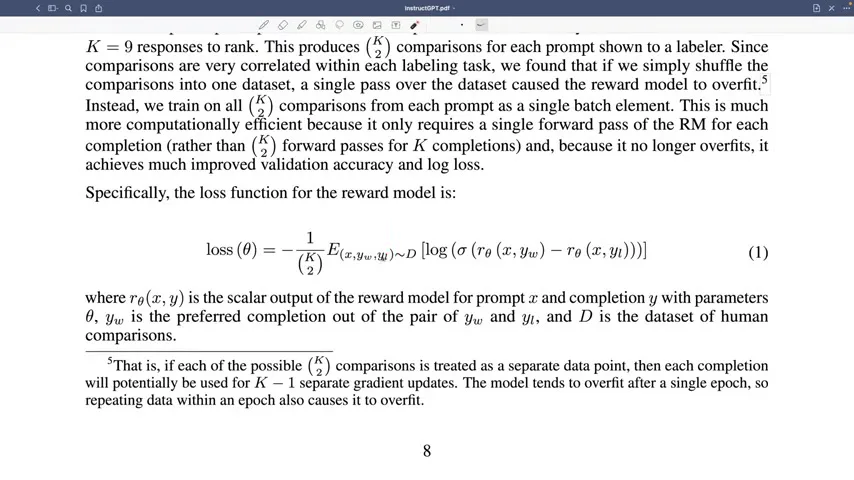
如果一个提示有九个回答,完整排序可以产生 36 对比较。讲者认为,在读懂提示后排序更多答案可能只增加部分人工时间,而每个答案的模型分数也可以在多组成对比较中复用。
把同一提示的所有回答比较放在一个批次中,模型只需为每个回答计算一次分数,再组合成多对排序项。这样可以减少重复计算,也影响过拟合表现。
论文还比较了只选最佳答案与学习完整排序。讲者说,完整排序提供更多约束,作者发现这有助于减少过拟合;具体收益仍依赖数据和训练设置。
PPO 与正则化
解释奖励、参考模型 KL 惩罚、预训练混合项和训练迭代。
第三个模型使用 PPO 优化。语言模型在强化学习术语中是策略:给定提示生成回答;奖励模型对回答打分。模型更新后,它生成的回答分布也随之改变。
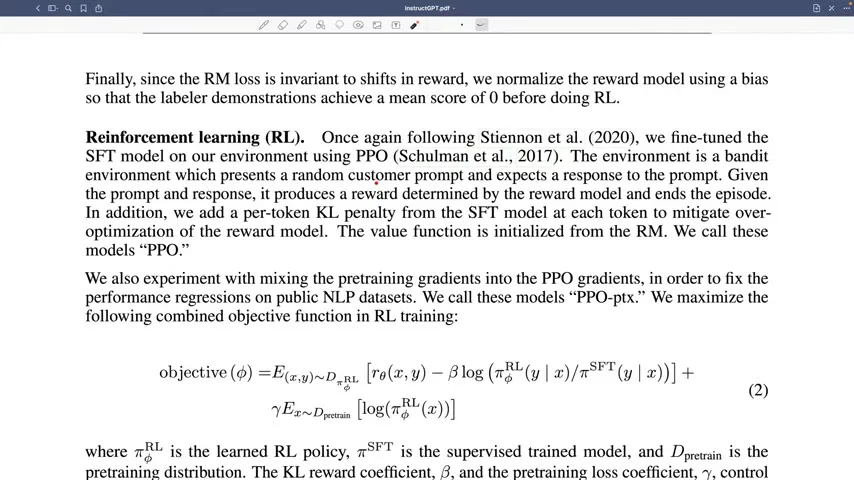
PPO 的策略从 SFT 模型初始化;提示来自强化学习阶段的数据,回答由当前策略采样,再由奖励模型打分。目标是提高评分,同时维持必要的约束。
为什么不在每次更新后都找人实时排序?讲者解释,这会让训练与人工反馈互相等待。奖励模型近似学习人的偏好,从而能在训练时持续提供分数,但它只是代理信号,并不等同于真正的人类判断。
奖励模型基于较早模型的回答训练。如果强化学习后的策略变化太大,新回答可能偏离奖励模型的训练分布,使评分不可靠。目标函数因此加入相对于 SFT 参考模型的 KL 惩罚,限制策略偏移。
KL 项衡量当前策略相对参考策略的偏移;系数决定惩罚强度。它不能证明奖励模型正确,但能降低策略过度利用奖励模型缺陷的风险。
论文还可以加入预训练数据上的语言建模项,避免只优化偏好而损害原有能力。讲者解释,系数控制这个项的强度;没有该项的版本称 PPO,加入预训练混合项的版本称 PPO-ptx。
讲者比较了其他工作中反复收集新偏好、更新奖励模型并再次优化策略的多轮方法。是否需要多轮取决于任务复杂度和奖励模型能否覆盖新输出;本论文采用的流程相对简洁。
总结训练链条:人工示范得到 SFT 模型,回答排序训练奖励模型,PPO 再利用奖励模型改进策略。奖励是对标注偏好的近似,训练中还需限制偏移并关注其他能力。
实验结果、局限与讨论
回顾人类偏好比较、标注代表性、语言覆盖和监督学习替代方案。
实验图比较不同大小的 GPT-3、监督微调和偏好优化模型。论文中的人类评估显示,小型 InstructGPT 可优于大得多的原始模型;讲者强调,评估提示与训练分布相近可能有助于微调模型。
讲者指出,基于标注的训练与评估数据如果分布接近,结果会比完全未见过目标形式的模型更有利。论文的结果应理解为该提示分布上的人类偏好比较。
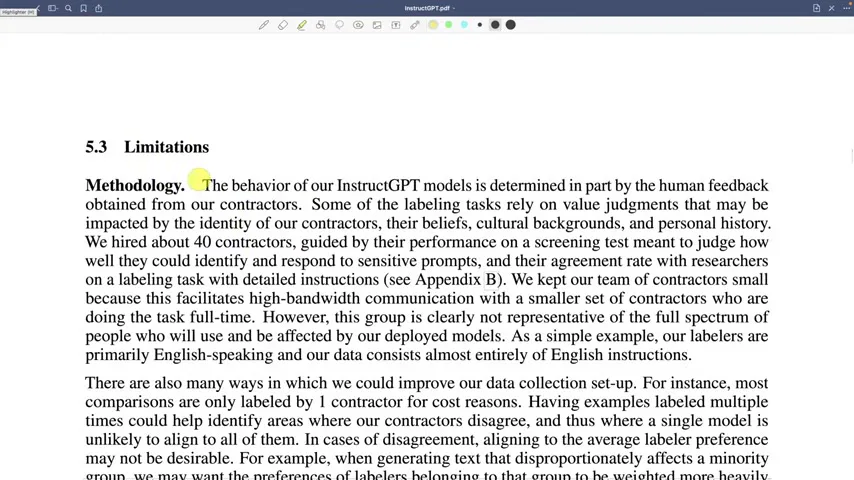
论文的局限包括:标注数据体现约 40 名承包人员的判断,不能代表所有未来用户;数据主要为英语,其他语言的能力可能不同;模型也没有完全解决安全和事实错误。
更深层的问题是模型究竟与谁、与什么对齐:直接执行用户指令,还是考虑更广泛的意图与后果?讲者认为,这些目标及其衡量方式仍然困难,RLHF 也只是可选方法之一。
讲者认为,论文实际更集中于帮助性,而真实性与无害性的提升并非都被显式优化。他提出疑问:如果增加高质量监督示范,是否可能得到足够好的结果,从而省去奖励模型和强化学习的复杂性?
最后,讲者将这种替代方案作为待验证的问题,而不是既定结论。若要把生成模型做成产品,还必须认真评估安全性与错误输出,不能只依据一项偏好实验就假定部署风险已经解决。
对于面向公众的产品,讲者认为组织还需要考虑错误造成的实际影响和外界反应。论文提供了训练思路,但部署仍需要针对应用做独立评估。
Mehr aus diesem Kanal
 23:39ZH
 跟李沐学AI· 23. Juli 2025李沐:给文本大模型加入一千万小时语音,开源 Higgs Audio李沐 · Boson AI李沐介绍团队如何在文本大语言模型的训练里加入大量语音数据,做成能听能说的 AudioLLM,并把 Higgs Audio 开源。他讲了架构取舍、token 压缩、数据从哪来,以及怎么在 3090 上跑起来。
 1:03:29ZH跟李沐学AI· 12. Jan. 2023多模态论文串讲:BLIP、CoCa 与 BEiT-3从图文数据清理到统一预训练,梳理三种视觉语言模型的结构、目标函数与相互联系。
 55:47ZH跟李沐学AI· 19. Dez. 2022Neural Corpus Indexer 论文精读:用生成模型检索文档从倒排索引、双塔检索到 NCI 的语义文档 ID,同时讨论数据泄露更正与部署瓶颈。